Qué es un hilo y qué comparte con su proceso, los modelos multihilo N:1, 1:1 y M:N, y cómo se crean, se esperan y se cancelan los hilos en C++, POSIX y Windows API.
·53 min de lectura
En el modelo de proceso que hemos descrito hasta el momento, cada proceso tiene una única secuencia de instrucciones que se ejecuta en la CPU, por tanto, solo puede realizar una tarea a la vez.
Por ejemplo, en un procesador de textos en un sistema operativo con este modelo de procesos, el usuario nunca podría escribir al mismo tiempo que se comprueba la ortografía.
En ese caso, si queremos hacer varias tareas al mismo tiempo, estamos obligados a crear varios procesos y seleccionar un mecanismo de comunicación para que estos colaboren.
Por eso muchos sistemas operativos modernos han extendido el concepto de proceso para permitir que cada uno tenga múltiples secuencias de instrucciones para ejecutarse en la CPU.
A cada una de estas secuencias de instrucciones se las conoce como hilo de ejecución.
Los procesos con varios hilos pueden realizar varias tareas a la vez.
Desde que introducimos el concepto de proceso hemos considerado que es la unidad básica de uso de la CPU.
Es decir, que la CPU se asignaba a los procesos, que la usaban para ejecutar sus instrucciones.
Sin embargo, en los sistemas operativos multihilo es el hilo la unidad básica de uso de la CPU.
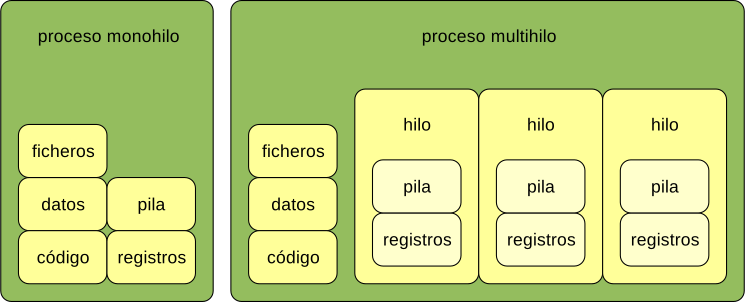
Esquema comparativo entre procesos monohilo y proceso multihilo.
Cada hilo tiene una serie de recursos propios dentro del proceso (ver la figura anterior):
El identificador del hilo es único para cada hilo y sirve para identificarlos, de la misma manera que lo hace el identificador de proceso con cada proceso.
El contador de programa es el registro de la CPU que indica la dirección de la próxima instrucción del hilo que debe ser ejecutada por la CPU.
Los registros de la CPU, cuyos valores son diferentes en cada hilo, puesto que, aunque todos los hilos ejecutan el mismo programa, pueden estar ejecutando diferentes partes del mismo.
La pila contiene datos temporales como argumentos y direcciones de retorno de las funciones y variables locales.
Al igual que ocurre con los registros de la CPU, cada hilo necesita su pila porque recorre el programa de manera independiente.
Sin embargo, hay otros recursos que se asignan al proceso, por lo que se comparten entre todos los hilos del mismo (ver la figura anterior):
El código del programa.
El programa es el mismo para todos los hilos.
Los segmentos BSS y de datos y el montón.
Las secciones de datos diferentes de la pila son accesibles a todos los hilos.
Eso quiere decir, por ejemplo, que cualquier hilo puede acceder y modificar una variable global o una asignada dinámicamente mediante malloc() o new().
Otros recursos del proceso como archivos, sockets, tuberías y dispositivos abiertos, regiones de memoria compartida, señales, directorio actual de trabajo, entre muchos otros recursos.
Todo esto significa que en cada instante, en cada CPU del sistema se puede estar ejecutando un hilo, del mismo o de distintos procesos en el sistema; pero la memoria, los archivos y otros recursos pertenecen al proceso del que cada uno forma parte.
Si un hilo reserva memoria o abre un archivo o un dispositivo y no lo libera antes de terminar, el recurso permanecerá reservado, no siendo liberado hasta que lo haga otro hilo o el proceso completo termine.
Si un hilo ejecuta una instrucción privilegiada o intenta acceder a una zona de memoria para la que no tiene permiso, la condición de error se propaga a todo el proceso.
Por tanto, por lo general, el sistema operativo detendrá el proceso completo del que formaba parte.
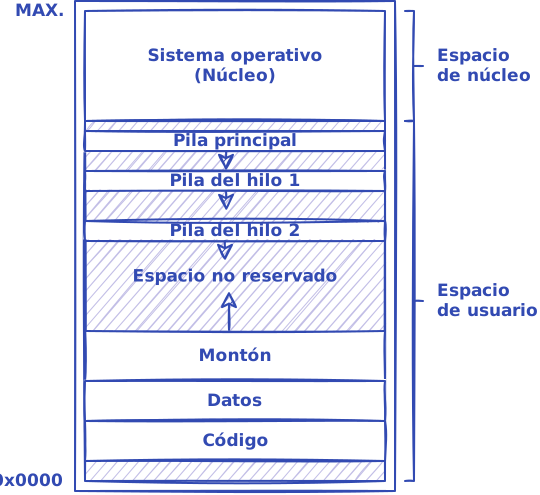
En la siguiente figura se puede observar cómo cambia la disposición de los elementos de un proceso en la memoria cuando es multihilo, respecto a lo que vimos en «El proceso».
Son muchos los beneficios que aporta la programación multihilo, derivados de que ofrece una forma sencilla de que un único proceso pueda realizar varias tareas al mismo tiempo.
Una aplicación multihilo interactiva puede continuar ejecutando tareas aunque uno o varios de sus hilos estén bloqueados o realizando operaciones muy lentamente, mejorando así el tiempo de respuesta al usuario.
Por ejemplo, un navegador web multihilo puede gestionar la interacción del usuario a través de un hilo, mientras el contenido solicitado se descarga en otro.
Para hacer lo mismo en un navegador monohilo habría que utilizar comunicaciones asíncronas, de lo contrario, mientras el proceso está en estado esperando, a la espera de que lleguen los datos a través de la red, no puede atender las acciones del usuario.
El uso de comunicaciones asíncronas para obtener el mismo beneficio tiene menor coste que usar hilos, pero es más difícil de programar.
Los hilos de un proceso comparten automáticamente sus recursos, sin que el programador tenga que hacer nada para conseguirlo.
No solo comparten la memoria, sino también otros muchos recursos del proceso, como los archivos y los dispositivos abiertos.
La alternativa es que un mismo programa cree varios procesos hijo, que se comuniquen y coordinen entre sí, para hacer distintas tareas.
Sin embargo, aunque la programación multiproceso ofrece beneficios similares a la multihilo, en esta última la comunicación es mucho más sencilla, porque los datos que hay que intercambiar ya están al alcance de todos los hilos.
Por eso los hilos son una forma más conveniente de ejecutar múltiples tareas al mismo tiempo que la programación multiproceso.
Como contrapartida, esa misma compartición es la que impide aislar los errores más graves.
Ya mencionamos que un error en un hilo se propaga a todo el proceso, mientras que un proceso hijo que termina de forma inesperada no arrastra a su padre, que puede seguir ejecutándose e incluso crear otro hijo para sustituirlo.
Reservar memoria y otros recursos para la creación de un proceso es muy costoso.
Por eso los sistemas operativos modernos han desarrollado diversas técnicas para que sea lo más eficaz posible.
Aun así, puesto que los hilos comparten los recursos de los procesos a los que pertenecen, son mucho más económicos de crear.
También es más económico el cambio de contexto entre ellos, ya que hay que guardar y recuperar menos información al conmutar la ejecución en la CPU entre dos hilos de un mismo proceso, que entre dos procesos diferentes.
Además, los hilos de un mismo proceso comparten espacio de direcciones, así que no hay que invalidar la TLB —la caché de la CPU que acelera la traducción de las direcciones virtuales—.
Al cambiar entre procesos sí hay que hacerlo, salvo que el hardware incluya algún mecanismo para evitarlo (ver el apartado «Borrado de la TLB en el cambio de contexto»).
En Microsoft Windows crear un proceso lleva entre 10 y 30 ms, mientras que crear un hilo cuesta unas pocas decenas de microsegundos —unas 300 veces menos—.
En Linux crear un proceso baja a unos pocos milisegundos, gracias a la eficiencia de fork().1
Aprovechamiento de las arquitecturas multiprocesador
En los sistemas multiprocesador diferentes hilos pueden ejecutarse en paralelo en distintos procesadores.
Por el contrario, un proceso monohilo solo se puede ejecutar en una CPU a la vez, independientemente de cuántas CPU estén disponibles para ejecutarlo.
Nuevamente, en los sistemas monohilo se pueden utilizar varios procesos para aprovechar las arquitecturas multiprocesador.
Sin embargo, como hemos comentado anteriormente, los hilos son más fáciles de programar y más económicos de crear y gestionar que los procesos.
Comparación con soluciones alternativas
A modo de resumen, los hilos son una forma sencilla de que un único proceso pueda realizar varias tareas al mismo tiempo, pero no son la única:
El uso de comunicaciones asíncronas permite realizar varias tareas de E/S al mismo tiempo, sin necesidad de hilos.
Suele ser una opción más económica que usar hilos, pero también es más difícil de programar.
El uso de múltiples procesos permite realizar varias tareas al mismo tiempo, tanto de E/S como de cálculo, y de forma más fiable que los hilos.
Sin embargo, los procesos suelen ser más caros de crear y gestionar que los hilos y no comparten los recursos de forma automática, por lo que la comunicación entre ellos es algo más complicada.
Las librerías de hilos proporcionan al programador la interfaz de programación para crear y gestionar los hilos de un proceso.
Por lo general, mediante lenguaje C se puede acceder directamente a la librería de hilos del sistema.
Pero el estándar del lenguaje no incluye soporte para hilos, así que conviene consultar la documentación de cada implementación de C para saber cuál es la forma más adecuada de crearlos y gestionarlos.
Por ejemplo, en los sistemas POSIX se puede utilizar directamente la librería POSIX Threads, pero en Windows API, en lugar de llamar a CreateThread(), se debe utilizar _beginthreadex() de la librería de tiempo de ejecución del C de Microsoft.
El motivo es que la librería de tiempo de ejecución de C en Windows realiza algunas tareas adicionales para que el hilo pueda ejecutar código C correctamente, como inicializar la pila del hilo y los datos de la librería de tiempo de ejecución.
Otros lenguajes proporcionan una librería de hilos dentro de su librería estándar, que a su vez se apoya en la librería de hilos del sistema operativo y prepara todo lo necesario para que el hilo pueda ejecutar código en ese lenguaje correctamente.
Por ejemplo, en C++ se puede utilizar la clase std::jthread de la librería estándar de C++20, independientemente de la API del sistema operativo.
El soporte de hilos en un sistema operativo se puede proporcionar a nivel de usuario o a nivel de núcleo.
El soporte de hilos a nivel de usuario se implementa mediante una librería de hilos en el espacio de usuario, junto al código del programa y los datos del proceso, sin requerir ningún soporte especial por parte del núcleo del sistema operativo.
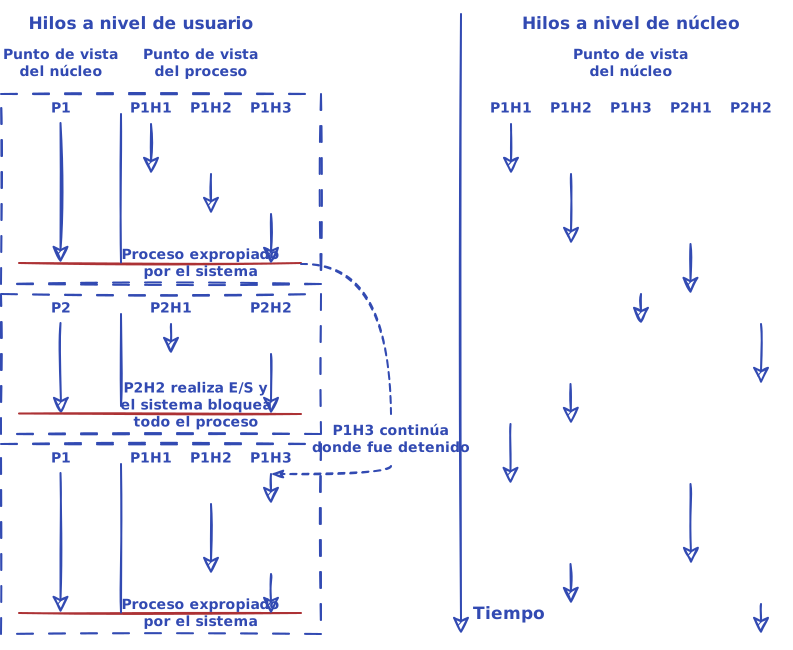
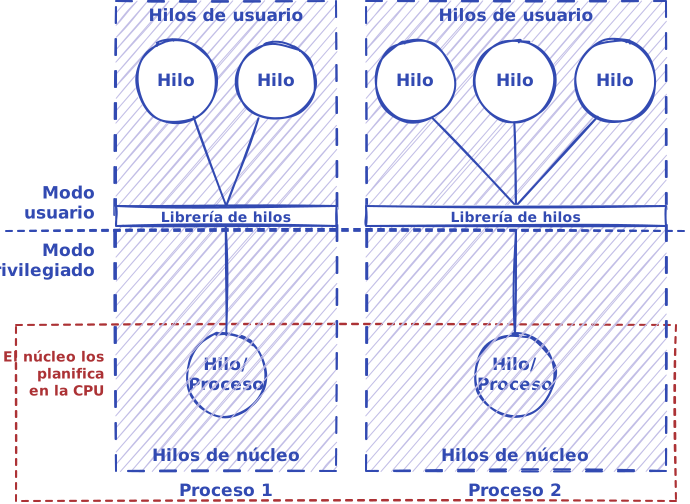
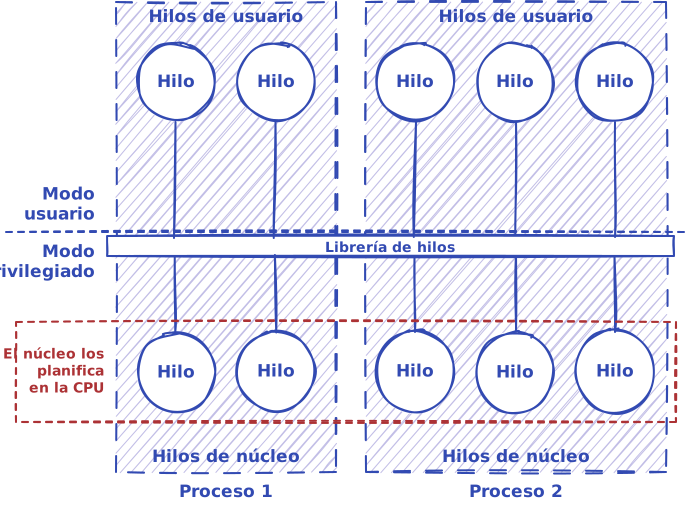
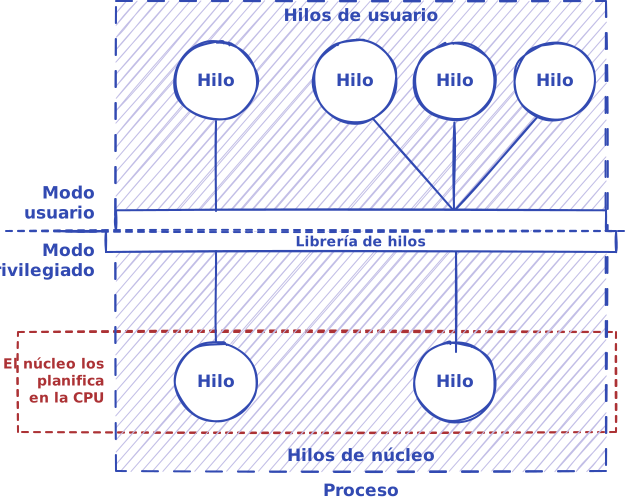
Por tanto, como se puede observar en el lado izquierdo de la siguiente figura, estos hilos existen desde el punto de vista del proceso y del programa que ejecuta, pero no para el sistema operativo.
El planificador de la CPU planifica procesos, asignando tiempo de CPU a cada uno, mientras que la librería de hilos de cada proceso reparte el tiempo de ejecución del proceso entre los diferentes hilos de este.
Comparación de hilos a nivel de usuario y a nivel de núcleo.
Como el código y los datos de la librería residen en el espacio de usuario, invocar una de sus funciones se reduce a una simple llamada a función, evitando el coste de hacer llamadas al sistema.
Se habla de hilos a nivel de núcleo cuando el núcleo del sistema es el encargado de ofrecer el soporte multihilo.
El código y los datos de la librería de hilos, mediante la cual los programadores pueden solicitar la creación y gestión de los hilos, reside en el espacio del núcleo.
Por tanto, para invocar una función de la librería de hilos es necesario hacer una llamada al sistema.
Obviamente, la librería del sistema ofrece las funciones necesarias para realizar estas llamadas al sistema de forma sencilla.
Que sea el núcleo el que conoce y gestiona los hilos implica que todo lo que estudiamos sobre planificación de la CPU se aplica en estos sistemas a los hilos y no a los procesos.
Los criterios de planificación, el ciclo de ráfagas de CPU y de E/S y algoritmos como FCFS, SJF, RR, la planificación con prioridades o la de colas multinivel realimentadas siguen siendo exactamente los mismos.
Lo que cambia es la entidad sobre la que operan, puesto que, en estos sistemas, es el hilo la unidad básica de uso de la CPU, como se ilustra en la figura anterior.
Por tanto, en estos sistemas son los hilos los que se mueven por los estados del diagrama de estado de un proceso y las colas de planificación, en lugar de los procesos.
La cola de preparados es ahora una cola de hilos.
El planificador de la CPU selecciona para ejecutarse un hilo de entre todos los que están en el estado preparado en el sistema y el cambio de contexto asigna la CPU a un hilo distinto al que la tiene asignada, que puede ser del mismo o de diferente proceso.
Sin embargo, el concepto de proceso no desaparece.
Deja de ser la entidad que compite por la CPU y pasa a ser, sobre todo, la unidad a la que el sistema operativo asigna los recursos: la memoria, los archivos y los dispositivos abiertos que comparten todos sus hilos.
Es decir, los procesos poseen los recursos y los hilos consumen la CPU para hacer el trabajo, por lo que el sistema operativo necesita ahora dos estructuras de datos en lugar de una.
Aparte del PCB, ahora el sistema operativo también gestiona una estructura llamada bloque de control del hilo o TCB (Thread Control Block) para cada hilo en el sistema, donde se guarda información sobre su estado de actividad actual.
Por tanto, es en el TCB —y no en el PCB— donde se guarda la información privada del hilo necesaria para la gestión de los estados y para el cambio de contexto: los valores de los registros de la CPU, el contador de programa, el estado y la información de planificación de la CPU.
El TCB incluye además un puntero al PCB del proceso al que pertenece el hilo, donde está el resto de la información privada del proceso.
En la actualidad, en los diferentes sistemas operativos se pueden encontrar librerías de ambos tipos.
Por ejemplo, la librería de hilos de Windows API se implementa en el núcleo2 mientras que la librería de hilos POSIX Threads —frecuentemente utilizada en los sistemas POSIX— puede ser de ambos tipos, dependiendo solamente del sistema donde se implemente.
En Linux, macOS y en la mayor parte de los sistemas POSIX modernos, POSIX Threads se implementa en el núcleo del sistema, pero nada obliga a que sea así.
A partir de lo anterior, sabemos que hay sistemas que implementan hilos a nivel de núcleo mientras otros los hacen a nivel de usuario.
Sin embargo, también existen sistemas donde se combinan ambos.
Para comparar las diferentes opciones que tienen los diseñadores de un sistema en cuanto al soporte de hilos, se definen los modelos multihilo con base en la relación entre hilos de usuario e hilos de núcleo.
Aquí entendemos por hilos de usuario estas secuencias de instrucciones tal y como las ve el programa en el espacio de usuario.
El concepto de hilos de núcleo, en cambio, se corresponde con cómo las ve el núcleo del sistema.
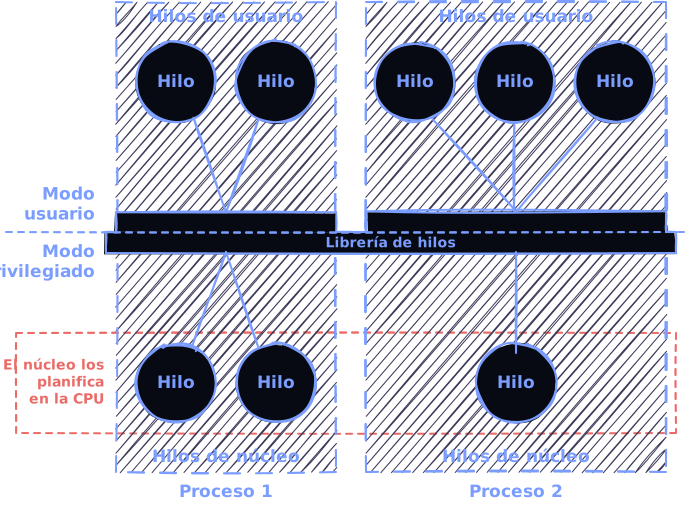
En el modelo muchos a uno muchos hilos de usuario son mapeados en un único hilo de núcleo.
El planificador de la CPU en el núcleo reparte el tiempo de CPU entre los diferentes hilos de núcleo en el sistema, mientras que la librería de hilos en cada proceso reparte el tiempo de ejecución del hilo de núcleo del proceso entre múltiples hilos de usuario (ver la siguiente figura).
Modelo muchos a uno (N:1).
Los sistemas modernos son multihilo, por lo que al crearse un proceso siempre se crea con un hilo de núcleo inicial, que es al que el núcleo asigna tiempo de CPU.
Sin embargo, los sistemas más antiguos no tenían ningún soporte de hilos en el núcleo, por lo que no había hilos de núcleo.
En este sentido, quizás sería más correcto definir el modelo muchos a uno como aquel en el que muchos hilos de usuario son mapeados en una «única entidad planificable en la CPU».
En los sistemas más antiguos estas entidades son los procesos, de forma que, bajo este modelo multihilo, los hilos de usuario realmente se reparten el tiempo de ejecución del proceso al que pertenecen.
El modelo muchos a uno corresponde al caso en el que solo se implementan hilos a nivel de usuario, que es el caso ilustrado a la izquierda en la figura de comparación anterior.
La principal ventaja de este modelo es su bajo coste, por lo que resulta ideal cuando la cantidad de hilos a crear —el nivel de concurrencia— va a ser muy alta:
Los hilos de usuario son muy baratos de crear porque la gestión de hilos se hace con una librería en el espacio de usuario, dentro del proceso.
En cambio, los hilos de núcleo pueden necesitar más recursos del sistema, como espacio en la tabla de hilos del sistema y en otras estructuras de gestión.
La invocación de las funciones de la librería de hilos se hace por medio de simples llamadas a funciones, que son menos costosas que las llamadas al sistema necesarias cuando el soporte de hilos se implementa en el núcleo.
Los cambios de contexto son más rápidos.
Los cambios de contexto, que ocurren cuando se transfiere el control de la CPU, pueden ser operaciones costosas.
En el modelo muchos a uno pueden ocurrir cambios de contexto en el núcleo al intercambiar procesos en la CPU, pero el intercambio de hilos se gestiona en el propio proceso, lo que suele ser más rápido que hacerlo en el núcleo.
Mientras que algunos posibles inconvenientes son que no aprovecha las ventajas de los sistemas multiprocesador y que un hilo puede bloquear a todos los demás:
Los hilos de un mismo proceso no se pueden ejecutar en paralelo en sistemas multiprocesador, por lo que este modelo no permite aprovechar ese tipo de sistemas.
El motivo es que la librería de hilos en espacio de usuario no tiene acceso a los procesadores del sistema.
Solo conoce el proceso en el que se ejecuta y reparte el tiempo de ejecución del proceso entre los distintos hilos.
El núcleo del sistema sí ve los diferentes procesadores, pero desconoce la existencia de los hilos dentro de los procesos.
Solo ve procesos que deben ejecutarse en las distintas CPU.
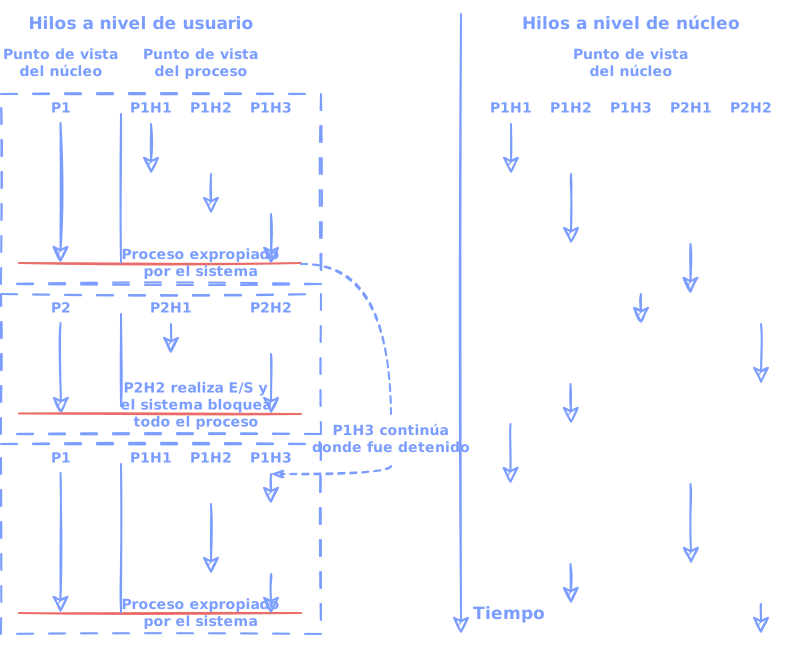
Un hilo puede bloquear la ejecución del resto de los hilos de su proceso, en determinadas circunstancias.
Si uno de los hilos solicita al sistema operativo una operación que deba ser bloqueada a la espera —por ejemplo, operaciones de E/S sobre archivos, comunicaciones o esperar a que otro proceso termine— todo el proceso es puesto como esperando por el sistema operativo, no pudiendo ejecutarse otros hilos del mismo proceso en la CPU, mientras tanto.
Para evitar en parte este problema, es frecuente que las implementaciones de este modelo ofrezcan versiones especiales de estas operaciones bloqueantes, capaces de evitar el bloqueo total del proceso.
Pero eso depende de que el sistema operativo tenga el soporte adecuado, por ejemplo con versiones asíncronas de esas operaciones.
Por tanto, este modelo no es una opción si lo que interesa es aprovechar el paralelismo en sistemas multiprocesador, para intentar realizar ciertas operaciones en menos tiempo.
El problema del bloqueo de procesos ocasionado por operaciones de E/S que pongan al proceso en estado esperando puede ser evitado interceptando las llamadas a funciones de la librería del sistema, para evitar el uso de llamadas al sistema que se puedan bloquear y sustituirlas por versiones equivalentes pero asíncronas.
Obviamente, la librería de hilos intercambia el hilo de usuario en ejecución cuando el que se está ejecutando finaliza.
Además, generalmente, tiene funciones para que el hilo de usuario en ejecución se duerma —sleep()— o para que espere a que otro hilo termine —wait() o join()—.
En ambos casos, el hilo de usuario queda bloqueado y la librería de hilos asigna otro hilo al hilo de núcleo para su ejecución.
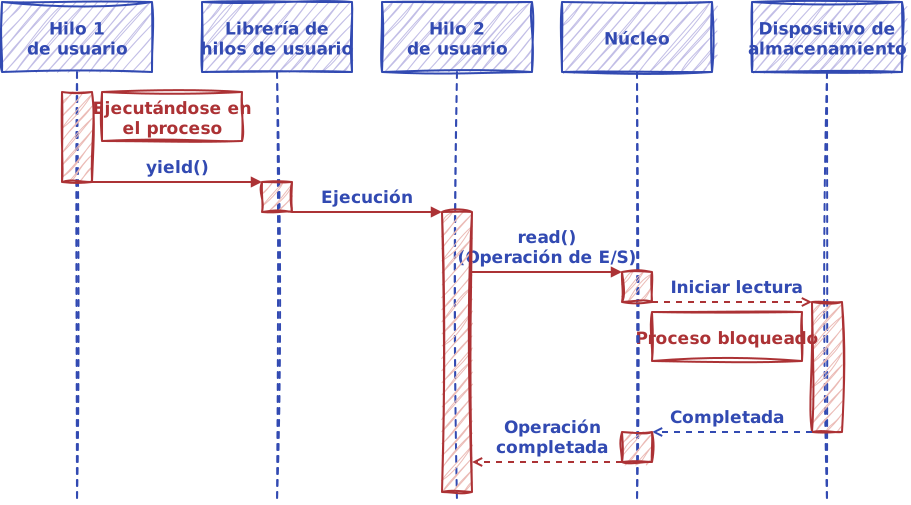
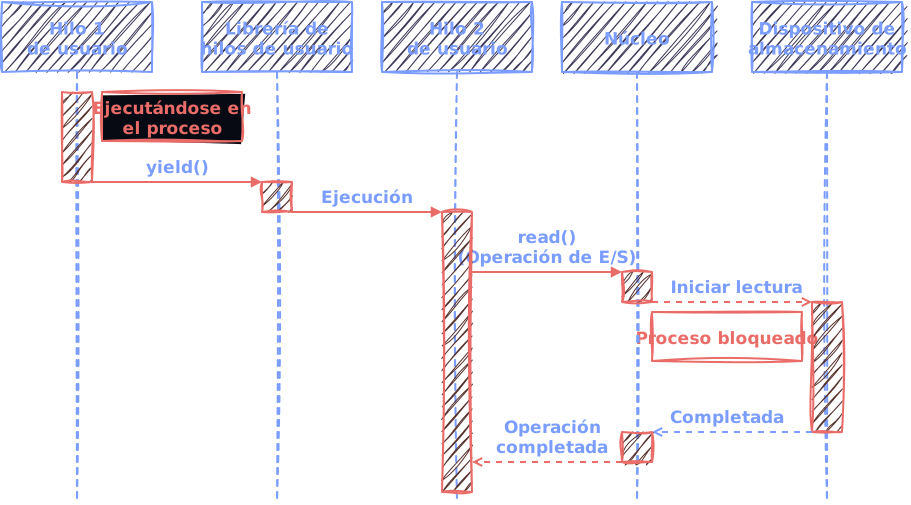
Por ejemplo, en la siguiente figura se ilustra cómo el Hilo 1 llama a la función yield() de la librería de hilos, provocando su intercambio con el Hilo 2.
La función yield() suele estar presente en algunas librerías de hilos, con el objeto de que los hilos puedan indicar puntos del programa en los que quieren dejar tiempo de ejecución para otros hilos, de forma voluntaria.
Diagrama de secuencia del bloqueo del proceso en el modelo muchos a uno.
Sin embargo, en la figura anterior también vemos que Hilo 2 invoca la llamada al sistema read() para leer un archivo.
Desde el punto de vista del núcleo, esa llamada la realiza el proceso, por lo que es bloqueado, hasta que la operación de lectura del archivo se completa.
Al proceso nunca se le asignará la CPU mientras esté en estado esperando, por lo que ni Hilo 1 ni ningún otro hilo de usuario del proceso podrá ejecutarse.
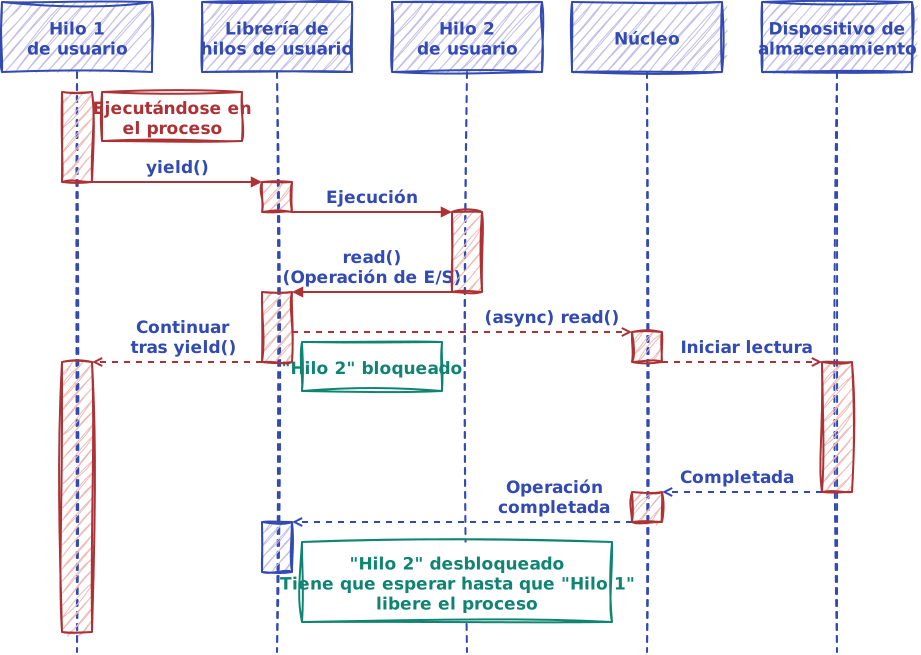
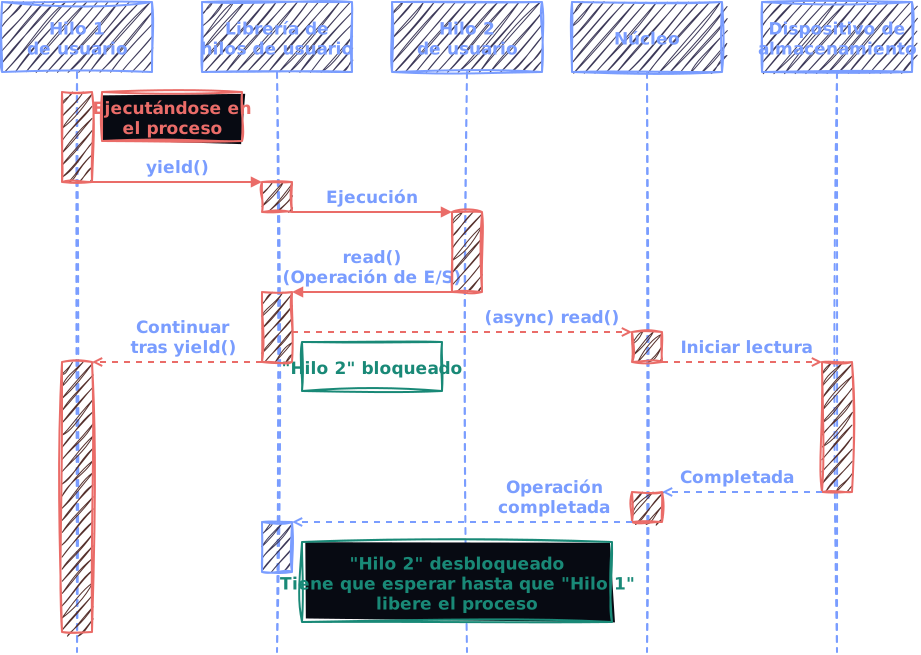
La solución, como hemos comentado, es que la librería de hilos proporcione sus propias versiones de las llamadas al sistema que pueden poner al proceso en estado esperando.
Por ejemplo, en la siguiente figura el Hilo 2 no usa la llamada al sistema read() sino una función read() proporcionada por la librería de hilos.
Para implementar su read(), la librería de hilos usa una versión asíncrona de la llamada al sistema.
Una versión donde se le indica al sistema que se quiere hacer una operación de E/S, pero el proceso no entra en estado de espera mientras ocurre.
En su lugar, el proceso retorna inmediatamente de la llamada al sistema y sigue ejecutándose en la CPU, lo que permite que la librería de hilos comience a ejecutar Hilo 1 en el lugar de Hilo 2.
Es decir, desde el punto de vista de Hilo 2, la función read() de la librería de hilos es bloqueante.
Diagrama de secuencia de la solución al bloqueo del proceso en el modelo muchos a uno.
Más adelante, el sistema operativo notificará a la librería de hilos que la operación ha sido realizada, por lo que los datos ya están disponibles en la memoria para ser usados.
En ese momento, Hilo 2 vuelve al estado preparado para volver a ser planificado por la librería de hilos cuando sea posible.
Este procedimiento es complejo y requiere versiones no bloqueantes de todas las llamadas al sistema, lo que puede que no siempre se cumpla.
Por lo general, cualquier sistema operativo moderno ofrece versiones asíncronas de todas las operaciones de E/S, pero puede haber otras llamadas al sistema que puedan poner al proceso en estado esperando y que no tengan versión asíncrona.
A este modelo de hilos también se lo denomina green threads.
En sistemas y plataformas antiguos, podía ser la única opción disponible.
Por ejemplo, en Java 1.1 era el único modelo soportado —ya que los hilos se implementaban en la máquina virtual de Java, independientemente del soporte del sistema operativo—.
Sin embargo, debido a sus limitaciones en versiones posteriores se implementó el soporte de hilos nativos del sistema operativo.
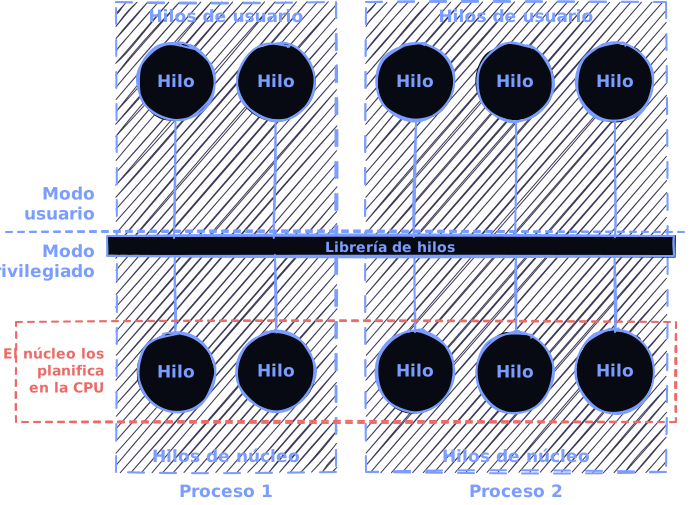
En el modelo uno a uno un hilo de usuario se mapea en un único hilo de núcleo.
Por lo general, este modelo corresponde al caso de los sistemas que solo soportan hilos a nivel de núcleo.
En este caso, la librería de hilos se implementa en el núcleo, por lo que las entidades que planifica el núcleo en la CPU son los hilos de núcleo y los procesos pueden gestionar estos hilos mediante llamadas al sistema (ver la siguiente figura).
Modelo uno a uno (1:1).
Es importante tener en cuenta que, a efectos prácticos, los hilos de usuario de la figura anterior no son hilos diferentes de los hilos de núcleo.
Realmente, son los mismos hilos de núcleo, pero vistos desde la perspectiva del programa en el modo usuario, como se ilustra a la derecha en la figura de comparación.
Las principales ventajas de este modelo son que no tienen ninguno de los inconvenientes del modelo muchos a uno:
Permite a otros hilos del mismo proceso ejecutarse aun cuando uno de ellos haga una llamada al sistema que debe bloquearse.
El núcleo se encarga de ponerlo en espera y planificar en la CPU a otro de los hilos preparados para ejecutarse de entre todos los existentes en el sistema.
Permite paralelismo en sistemas multiprocesador, ya que diferentes hilos pueden ser planificados por el núcleo en distintos procesadores.
Mientras que crear y gestionar hilos tiene mayor coste que en el modelo muchos a uno:
Crear hilos puede tener mayor coste.
En este caso, crear un hilo para un proceso implica crear y gestionar ciertas estructuras de datos en el núcleo.
Debido a que la cantidad de memoria disponible para el núcleo suele estar limitada, muchos sistemas restringen la cantidad máxima de hilos de núcleo soportados.
Usar la librería de hilos suele ser más costoso.
La gestión de los hilos se hace con una librería en el espacio de núcleo, lo que requiere que el proceso haga llamadas al sistema para gestionarlos.
Esto suele tener mayor coste que invocar simplemente una función, como ocurre en el modelo muchos a uno.
El modelo uno a uno se utiliza en la mayor parte de los sistemas operativos multihilo modernos.
Linux, Microsoft Windows —desde Windows 95—, Solaris 9 y superiores, macOS y la familia de UNIX BSD son ejemplos de sistemas operativos que utilizan el modelo uno a uno.
En teoría debería ser posible aprovechar lo mejor de los dos modelos anteriores con una librería de hilos en el núcleo, para crear hilos de núcleo, y otra en el espacio de usuario, para crear hilos de usuario.
Así los desarrolladores pueden utilizar la librería de hilos en el espacio de usuario para crear tantos hilos como quieran y que estos se ejecuten sobre los hilos de núcleo de su proceso.
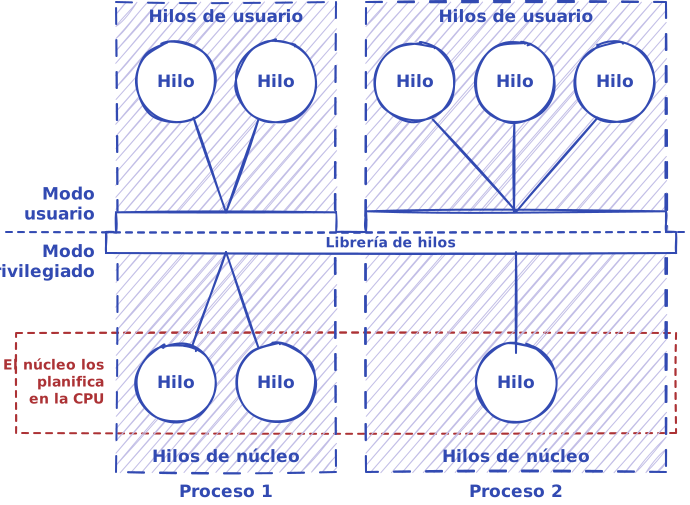
Ese es el modelo muchos a muchos, donde muchos hilos de usuario se mapean en muchos hilos de núcleo.
El planificador de la librería de hilos en espacio de usuario se encarga de determinar cómo se reparte el tiempo de ejecución de cada hilo de núcleo entre los hilos de usuario.
Mientras que el planificador de la CPU asigna la CPU a alguno de los hilos de núcleo del sistema (ver la siguiente figura).
En el modelo muchos a muchos es conveniente que exista cierto grado de coordinación entre el núcleo y la librería de hilos del espacio de usuario.
Dicha comunicación tiene como objeto ajustar dinámicamente el número de hilos de núcleo para garantizar la máxima eficiencia.
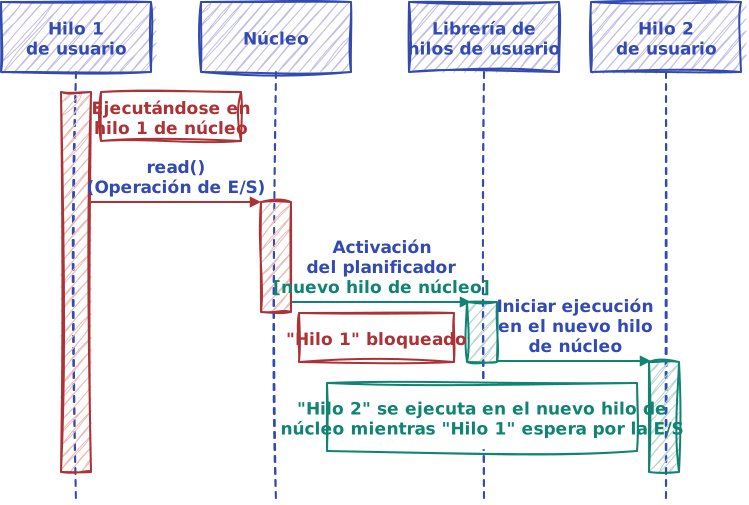
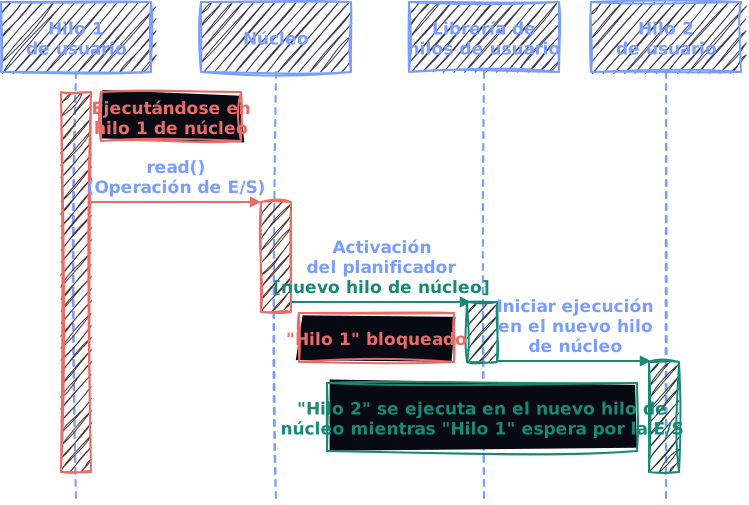
Diagrama de secuencia del mecanismo de activación del planificador.
Uno de los esquemas de comunicación se denomina activación del planificador y consiste en que el núcleo informa a la librería de hilos en espacio de usuario que una llamada al sistema, realizada por uno de sus hilos de usuario, va a bloquear un hilo de núcleo del proceso cuyos hilos gestiona.
Antes de dicha notificación, el núcleo se encarga de crear un nuevo hilo de núcleo en el proceso y se lo pasa a la librería de hilos en la notificación (ver la figura anterior).
Así, el planificador de la librería puede asignarle alguno de los otros hilos de usuario, evitando el bloqueo completo del proceso si no quedan hilos de núcleo disponibles, y ajustando el número de hilos de núcleo dinámicamente, según las necesidades.
Las principales ventajas de este modelo son que tampoco tienen ninguno de los inconvenientes del modelo muchos a uno:
Permite paralelismo en sistemas multiprocesador, ya que diferentes hilos de núcleo pueden ser planificados en distintos procesadores y en cada uno puede ejecutarse cualquier hilo de usuario de su proceso.
Permite a otro hilo de usuario del mismo proceso ejecutarse cuando un hilo hace una llamada al sistema que debe bloquearse.
Si esto ocurre el correspondiente hilo de núcleo se queda bloqueado, pero el resto de los hilos de usuario pueden seguir ejecutándose en los otros hilos de núcleo del proceso (ver el apartado anterior).
Sin embargo, su principal inconveniente es su complejidad para implementarlo y la dificultad de coordinar el planificador de la librería de hilos en espacio de usuario con el planificador de la CPU para obtener el mejor rendimiento.
Como vimos en el capítulo «Planificación de la CPU», los planificadores de la CPU modernos intentan clasificar los hilos de núcleo para ordenarlos de la forma más óptima en el acceso a la CPU.
Por ejemplo, no es lo mismo una tarea de cálculo, que necesita usar intensivamente la CPU, que otra que copia datos de la red o del sistema de archivos.
Generalmente, primero se planifican las segundas, dejando para el final las tareas intensivas en el uso de la CPU.
En el modelo muchos a muchos en un mismo hilo de núcleo se pueden ejecutar diferentes hilos de usuario que pueden ser de distinto tipo.
Por tanto, cualquier clasificación que haga el planificador de la CPU puede ser incorrecta en cuanto la librería de hilos en espacio de usuario cambie el hilo de usuario que se está ejecutando en un hilo de núcleo por otro diferente.
La solución a este problema pasa porque la librería de hilos en espacio de usuario y el planificador de la CPU intercambien información sobre sus hilos y se coordinen.
Debido a estas dificultades, muchos sistemas actuales han optado finalmente por el modelo uno a uno, concentrando esfuerzos en reducir el coste de creación de hilos a nivel de núcleo, con el objeto de que haya poca ventaja en implementar también hilos a nivel de usuario.
Esto no significa que actualmente no se puedan obtener las ventajas del modelo muchos a muchos en casos en los que puede ser beneficioso.
Para esos casos los desarrolladores pueden utilizar librerías o lenguajes específicos, con implementaciones diseñadas para crear un gran número de hilos de usuario con un coste mínimo, sobre la librería de hilos de los sistemas operativos actuales.
Este modelo se soportaba en sistemas FreeBSD y versiones antiguas de NetBSD, así como en UNIX comerciales como Solaris 8 y anteriores, IRIX, HP-UX y Tru64 UNIX.
Microsoft Windows también soportaba este modelo —a partir de Windows 7 y hasta Windows 10— gracias a incorporar el mecanismo UMS mencionado anteriormente.3
Algunos lenguajes de programación implementan el modelo muchos a muchos sobre el modelo uno a uno nativo de la mayoría de sistemas operativos modernos.
Ese es el caso de Go, Erlang, Elixir y Java.
Existe una variación del modelo muchos a muchos donde, además de funcionar de la forma comentada anteriormente, se permite que un hilo de usuario quede ligado indefinidamente a un único hilo de núcleo, como en el modelo uno a uno.
Esta variación se denomina, en ocasiones, modelo de dos niveles (ver la siguiente figura).
El modelo de dos niveles presenta los mismos inconvenientes que el modelo muchos a muchos, con algunas ventajas en casos de uso concretos relacionados con maximizar el rendimiento de una tarea:
Vincular un hilo de usuario a un hilo de núcleo se asegura la disponibilidad del recurso, lo que puede ser interesante si un hilo de usuario es particularmente importante para el rendimiento de la aplicación.
En sistemas con múltiprocesador puede interesar que un hilo de usuario se ejecute siempre en el mismo procesador para mejorar el rendimiento.
Al vincular un hilo de usuario a un hilo de núcleo y configurar este último para que siempre se planifique en el mismo procesador, se puede aprovechar mejor la memoria caché del procesador.
Hemos comentado que el modelo muchos a uno debe ser, teóricamente, «más ligero» que el modelo uno a uno.
También hemos dicho que el modelo muchos a muchos, teóricamente, permite conservar esa ventaja, al tiempo que ofrece los beneficios del modelo uno a uno, en lo que respecta al aprovechamiento de los sistemas multiprocesador.
Sin embargo, debemos tener en cuenta que la diferencia real puede variar en función de múltiples factores.
Un criterio común hasta la década de los 2000 era que el modelo uno a uno era adecuado hasta varias decenas de hilos —a lo sumo, en torno a 100 o, quizás, a unos pocos cientos de hilos— por proceso, mientras que el modelo muchos a uno podía llegar a varios miles de hilos.
La principal limitación en la cantidad de hilos de usuario del modelo muchos a uno estaba en el tamaño del espacio de direcciones del proceso.
Por ejemplo, en las versiones de Windows de 32 bits, los procesos disponen de 2 GiB de su espacio de direcciones para código y datos.
Como cada fibra —que es como se llama a los hilos del modelo multihilo muchos a uno que implementa Windows API— necesita 1 MiB de memoria para su pila, el límite teórico era de 2048 fibras.
Este límite era realmente algo inferior porque en el mismo espacio se almacena el código y los datos del programa y las librerías que este utiliza.
Una forma de soslayar este problema es indicar al sistema que reserve menos memoria para la pila al crear cada fibra.
Esta posibilidad la suelen soportar los sistemas operativos, independientemente del modelo multihilo.
En el caso de Microsoft Windows, esto permite llegar hasta cerca de 32 Ki fibras en sistemas de 32 bits.
Posteriormente, se optimizó la creación de hilos a nivel de núcleo, hasta el punto de equiparar, en gran medida, el coste de cada hilo en ambos modelos.
Mientras que pasar a sistemas de 64 bits permitió superar las limitaciones derivadas del pequeño tamaño del espacio de direcciones de los procesos en los sistemas de 32 bits, que limitaba a ambos modelos multihilo.
Actualmente, la creación de hilos a nivel de núcleo se ha optimizado hasta el punto de que usando el modelo uno a uno se puede llegar a decenas o cientos de miles de hilos por proceso, equiparándose a muchas implementaciones del modelo muchos a uno.
Con suficiente memoria y ajustando el tamaño de la pila de los hilos, se puede llegar a millones de hilos en ambos modelos.
Sin embargo, cuando se tienen requisitos tan exigentes, suele recomendarse utilizar librerías o lenguajes específicos, con implementaciones del modelo muchos a uno o muchos a muchos diseñadas para escalar hasta esa cantidad de hilos.
Obviamente, hoy resulta más interesante el modelo muchos a muchos, porque permite aprovechar el paralelismo de las CPU modernas.
Algunas de estas implementaciones son:
Stackless Python, una implementación del modelo muchos a uno para Python.
Permite crear un millón de hilos a nivel de usuario —llamados tasklets— consumiendo solo 100 MiB de memoria.
Go, un lenguaje de programación creado por Google, orientado a la creación de servicios de alto rendimiento, que incluye su propia implementación del modelo muchos a muchos.
Go puede crear un millón de hilos a nivel de usuario —llamados goroutines— 10 veces más rápido de lo que se puede crear la misma cantidad de hilos del sistema operativo en Linux,4 utilizando 2 GiB de memoria para las pilas.
Java soporta hilos virtuales —a partir de la versión 19 como feature preview— una implementación del modelo muchos a muchos, dirigida a cargas de trabajo que necesitan una cantidad extremadamente alta de hilos.
Como ocurre con los procesos, los hilos se crean y se destruyen dinámicamente mientras el programa se ejecuta.
Por eso los sistemas operativos deben ofrecer servicios para crearlos, para esperar a que terminen y para cancelarlos antes de que acaben su trabajo.
En un sistema operativo con librería de hilos implementada en el núcleo, todo proceso se crea con un hilo, denominado hilo principal.
Este es el hilo con el que comienza a ejecutarse el programa al entrar en main() y el que provoca la terminación de todo el proceso —incluida la terminación de los otros hilos que existan— al retornar de dicha función.
El hilo principal puede crear otros hilos y estos, a su vez, crear los hilos que necesiten.
Pero, a diferencia de lo que ocurre con los procesos, no existe una relación de padres a hijos ni se crea un árbol de hilos.
Excepto por la característica especial del hilo principal de que su finalización significa la terminación del proceso, todos los hilos son iguales entre sí.
Al crear un hilo hay que indicar la función por la que empezará a ejecutarse —su función principal— y los argumentos que se le quieren pasar.
Cuando esa función retorna, el hilo termina:
Los argumentos se pasan con su tipo, detrás del nombre de la función, al construir el objeto std::jthread.
La librería se encarga de copiarlos y de entregárselos al hilo.
voidthread_function(inttid);
// ...
inttid=1;
std::jthreadthread( thread_function, tid );
La función principal del hilo recibe un único void*, que hay que convertir al tipo correcto dentro de la función.
Si se necesita pasar más de un argumento, se agrupan en una estructura y se pasa su dirección.
Como solo se pasa una dirección, hay que asegurarse de que la variable siga existiendo mientras el hilo la use.
Igual que en POSIX, la función principal recibe un único void*.
Además debe declararse con la convención de llamada __stdcall5, que es la que espera la librería.
Aunque se use dentro de Windows, _beginthreadex() no es una función de Windows API, sino de la librería de tiempo de ejecución de C de Microsoft.
Internamente llama a CreateThread(), que es la verdadera función del sistema para crear hilos.
Pero es la que hay que usar desde un programa en C, porque antes prepara los datos que la librería mantiene para cada hilo.
Aunque todas las formas se parezcan, no están al mismo nivel: cada una pertenece a una capa distinta.
Las funciones pthread_create() y CreateThread() son las interfaces que ofrece el sistema operativo.
En cambio, std::jthread y _beginthreadex() vienen con el lenguaje, y se implementan sobre las anteriores.
Como solo std::jthread es parte del estándar de C++, únicamente el código que usa esta clase se puede llevar de un sistema a otro sin tocarlo, mientras que el que usa la API del sistema o extensiones especiales del lenguaje hay que reescribirlo.
Un hilo que termina no desaparece del todo.
Hasta que otro hilo se ocupa de él, el sistema mantiene las estructuras de datos que lo describen y, donde lo haya, su estado de terminación.
Esto permite que otro hilo pueda esperar a que termine y recuperar su estado de salida, pero también se puede optar por desentenderse del hilo y dejar que el sistema libere sus recursos automáticamente cuando termine.
El hilo que invoca std::jthread::join() se queda dormido hasta que el hilo gestionado por ese objeto termine.
La función principal del hilo no devuelve nada —el tipo de retorno es void—, así que para recuperar un resultado hay que pasarle al crearlo una referencia o un puntero a la variable donde debe guardarlo.
std::jthreadthread( thread_function, tid );
// ...
thread.join();
La función pthread_join() duerme el hilo que la invoca hasta que el hilo indicado termine.
Además, acepta un puntero a void* a través del cual devuelve el valor que retornó la función principal del hilo.
Como el hilo devuelve un puntero, es importante no intentar devolver una variable local del hilo, pues se destruirá en cuanto el hilo termine y el puntero ya no será válido.
Esperar por un hilo es esperar por su manejador, con la misma función que se usa para esperar por cualquier otro objeto del sistema.
La función principal del hilo devuelve un unsigned, que es el valor de salida del hilo.
Este estado de salida se puede consultar después de que el hilo termine, con la función GetExitCodeThread().
Por defecto los hilos se crean unidos —o joinable—, que es como se denomina a los hilos por los que se puede esperar.
Por lo general, si nadie los espera, sus recursos siguen retenidos hasta que el proceso termina, del mismo modo que los procesos zombi ocupan sitio en la tabla de procesos hasta que su padre lee su estado de salida.
Cuando el resultado del hilo no interesa, se lo puede marcar como separado —o detached—.
Un hilo separado sigue ejecutándose con normalidad y el sistema libera sus recursos automáticamente cuando termina, pero ya no se puede esperar por él ni conocer su estado de terminación.
En C++ los objetos std::jthread se destruyen al salir del ámbito donde se declararon.
Si en ese momento el hilo no ha sido unido —no hemos llamado a join()— ni separado —no hemos llamado a detach()—, el destructor lo une por nosotros.
Además, esta clase incorpora un mecanismo de cancelación, que veremos en «Cancelación cooperativa en los lenguajes de alto nivel».
La cancelación es la operación de terminar un hilo antes de que termine su trabajo.
Por ejemplo, en un navegador web un hilo se puede encargar de la interfaz de usuario mientras otros hilos se encargan de descargar las páginas y las imágenes de estas.
Si el usuario pulsa el botón «Cancelar», es necesario que todos los hilos que intervienen en la descarga sean cancelados.
Esto puede ocurrir de dos maneras:
En la cancelación asíncrona el hilo termina inmediatamente, en cualquier instrucción, por lo que no tiene oportunidad de liberar los recursos que tuviera reservados ni de terminar las tareas pendientes.
En la cancelación diferida el hilo puede terminar en puntos específicos del código llamados puntos de cancelación.
En ambos casos se pueden producir fugas de memoria y otros problemas si el hilo termina mientras tiene recursos reservados que no están siendo controlados también por otros hilos, porque no se liberan al terminar el hilo sino que se quedan retenidos hasta que el proceso termina.
Igualmente, si el hilo estaba modificando datos compartidos con otros hilos, estos cambios podrían quedar a medias y dejar las estructuras de datos compartidas en un estado inconsistente.
La diferencia entre ambos tipos de cancelación es que en la cancelación diferida el desarrollador conoce de antemano los puntos donde podría terminar el hilo, lo que da la oportunidad de introducir mecanismos de control para evitar los problemas anteriores.
Sin embargo, requiere que el desarrollador tenga cuidado de no introducir puntos de cancelación en lugares donde no convenga que el hilo pueda terminar, y que tampoco se olvide de liberar los recursos cuando el hilo termine.
Windows API únicamente ofrece TerminateThread(), que usa cancelación asíncrona y que la propia documentación de Microsoft desaconseja salvo en casos extremos por los motivos mencionados anteriormente.6
POSIX Threads sí soporta la cancelación diferida, y además es la que usa por defecto, pero a cambio hay que saber en qué puntos del código puede cancelarse el hilo.
Solo puede hacerlo en los llamados puntos de cancelación, que son casi todas las llamadas al sistema capaces de dejarlo en estado esperando, como open(), read(), write() o sleep(), entre muchas otras.
Eso deja al programador con dos problemas delicados:
Un bucle dedicado al 100% a calcular no llama al sistema, así que no tiene ningún punto de cancelación y el hilo es incancelable durante todo ese tiempo, por largo que sea el cálculo.
Para evitarlo el programador puede insertar puntos de cancelación manualmente con pthread_testcancel(), como hace pthreads-cancel-factorial.cpp dentro del bucle que calcula el factorial.
Una llamada a printf() —o cualquier otra función que llame al sistema— en mitad de la actualización de una estructura de datos mete un punto de cancelación justo donde no interesa que el hilo pueda terminar.
Para evitarlo, POSIX Threads ofrece la función pthread_setcancelstate(), que permite desactivar temporalmente la cancelación mientras se ejecuta un código crítico.
Con ambos sistemas, liberar los recursos que el hilo tuviera reservados corre por cuenta del programador: POSIX Threads ofrece para ello una pila de manejadores de limpieza —pthread_cleanup_push() y pthread_cleanup_pop()—, mientras que Windows API no ofrece nada similar.
Por eso la documentación de Microsoft, en lugar de TerminateThread(), recomienda que sea el propio programa el que se construya su mecanismo de cancelación: una variable compartida —o un evento, con CreateEvent() y SetEvent()— que el hilo consulte periódicamente para terminar por sí mismo.
Esta es exactamente la misma solución a la que han llegado diferentes lenguajes de programación, y de la que hablaremos en el siguiente apartado.
Cancelación cooperativa en los lenguajes de alto nivel
El mecanismo de cancelación diferida funciona razonablemente bien en C, pero no con lenguajes de más alto nivel, como C++, Java o C#.
Las librerías de hilos suelen ser librerías en C, que no conocen nada de objetos ni de otras particularidades de esos lenguajes.
Por ejemplo, en C++, antes de terminar un hilo, deberían ser llamados todos los destructores de los objetos locales, para evitar fugas de memoria y de otros recursos, datos sin escribir y otros problemas derivados de tener objetos que no se destruyen adecuadamente.
Lamentablemente, ni el mecanismo de cancelación de POSIX Threads ni el de Windows API saben hacer nada de eso.
Por tanto, cada lenguaje debe implementar su propia solución.
Java y C# empezaron ofreciendo una forma de cancelación similar a la de los sistemas operativos, que permitía terminar un hilo desde fuera, pero que usaba excepciones para liberar los recursos de los objetos locales.
Sin embargo, esto también resultó ser inseguro, porque la excepción podía llegar en cualquier momento y el funcionamiento seguro dependía de que los programadores escribieran código que la manejara correctamente.
Lo que todos han adoptado en su lugar es la cancelación cooperativa, que va en la línea de lo que actualmente recomienda Microsoft para Windows API.
En vez de terminar el hilo desde fuera, se le avisa de que debe terminar y es él quien lo hace ordenadamente, retornando de su función principal.
El hilo se puede enterar de ese aviso comprobándolo él mismo, cada cierto tiempo, en los puntos donde le resulta seguro terminar.
La forma más simple de ese aviso es usar una variable compartida de tipo bool, que el hilo consulta con frecuencia para saber si debe terminar retornando.
Según el lenguaje, hay que declararla de manera que el compilador no la guarde en un registro, o el hilo podría no llegar a ver nunca el cambio que hace el otro, por ejemplo, como volatile en Java y C#, y como una variable atómica en C++.
Esta solución sigue siendo válida pero, por fortuna, los lenguajes han integrado algún mecanismo de cancelación cooperativa.
En Java se usa un indicador que cada hilo lleva consigo: Thread.interrupt() lo activa, Thread.isInterrupted() sirve para consultarlo y, si el hilo está esperando en alguna operación bloqueante cuando llega la petición de cancelación, se lanza la excepción InterruptedException para iniciar la terminación.
En C# es un objeto aparte, el CancellationToken, que se pasa a todo aquello que deba poder cancelarse, y que ofrece ambas formas de reaccionar —consultarlo o pedirle que lance la excepción OperationCanceledException—.
C++ introdujo la cancelación cooperativa en C++20 con la clase std::jthread, que pasa a la función principal del hilo un token de cancelación de tipo std::stop_token —el equivalente del CancellationToken de C#— que el código del hilo puede usar para consultar si se ha pedido la cancelación.
Sin embargo, el estándar de C++ no define ninguna forma de lanzar una excepción para detener operaciones bloqueantes, como sí hacen Java y C#.
Por el momento, solo std::condition_variable_any::wait() acepta un token de cancelación para detener la espera cuando se ha pedido la cancelación del hilo.
Para otros casos, la solución es utilizar std::stop_callback para registrar una función de callback7 que se ejecute cuando se pida la cancelación, y que haga que la operación bloqueante termine.
Por ejemplo, si se está esperando con recv() a recibir un mensaje a través de un socket, la función de callback puede cerrar la conexión.
Mientras que si se está esperando en la lectura de la entrada estándar, la función de callback puede cerrar el descriptor de la entrada estándar.
En ambos casos, la operación bloqueante termina y el hilo puede comprobar el token de cancelación para terminar ordenadamente.
Los dos ejemplos siguientes muestran en un programa completo las operaciones que hemos visto: la creación de los hilos, la espera por su terminación y su cancelación.
El código fuente completo de este ejemplo está disponible en threads.cpp.
En threads-factorial.cpp se puede examinar un ejemplo más interesante donde los hilos se utilizan para dividir el cálculo del factorial de un número, con el objetivo de calcularlo en menos tiempo.
voidthread_function(intthread_id)
{
std::println( "[Hilo {}] Creado", thread_id );
for(int i =0; i <10; ++i)
{
// Dormir el hilo para simular que hace trabajo
// ...
}
}
intmain()
{
// Crear 3 hilos dentro del proceso
std::jthread thread1( thread_function, 1 );
std::jthread thread2( thread_function, 2 );
std::jthread thread3( thread_function, 3 );
std::println( "[Main] Hilo 1 - Id: {}, Manejador del sistema: 0x{:x}",
thread1.get_id(),
thread1.native_handle() );
// ...
thread1.join();
thread2.join();
thread3.join();
return EXIT_SUCCESS;
}
Un objeto std::jthread no es el hilo, sino el objeto que sirve para gestionar un hilo creado en el sistema.
El identificador que guarda ese objeto es propio de C++ y no tiene por qué coincidir con el que usa el sistema operativo.
El método std::jthread::native_handle() devuelve el manejador usado internamente por el sistema.
Antes de terminar esperamos a que los hilos terminen.
Esto es opcional porque el destructor de cada objeto std::jthread une su hilo al salir de main(), pero se indican para mostrar cómo se hace de forma explícita.
El mismo programa escrito directamente sobre POSIX Threads —sin la librería estándar de C++ de por medio— está en pthreads.cpp.
En pthreads-factorial.cpp está la versión con POSIX Threads del ejemplo del factorial.
Ejemplo Creación y cancelación cooperativa de hilos en C++
El ejemplo anterior usa std::jthread sin recoger el token de cancelación, que es lo que corresponde cuando a los hilos se les va a dejar hacer su tarea hasta el final.
El siguiente ejemplo, en cambio, reparte el cálculo del factorial de un número entre dos hilos que sí recogen el token, para poder detenerlos a mitad de la operación.
El código fuente completo del ejemplo está disponible en threads-cancel-factorial.cpp.
Windows API se diseñó desde un primer momento para soportar hilos, así que no presenta inconsistencias.
Sin embargo, la API POSIX es anterior a la aparición de los hilos y al desarrollo de POSIX Threads, por lo que se tuvieron que tomar decisiones sobre cómo encajarlos con las llamadas al sistema existentes.
El estándar POSIX establece que si se utiliza fork() en un programa multihilo, el nuevo proceso debe ser creado con un solo hilo, que será una réplica del que hizo la llamada, así como un duplicado completo del espacio de direcciones del proceso.
El motivo es que muchas veces se hace un fork() para ejecutar un nuevo programa con exec(), y en ese caso no tendría sentido el coste de duplicar todos los hilos del proceso padre.
Que el hijo nazca con un solo hilo tiene una consecuencia que no es evidente: en el hijo de un fork() hecho desde un programa multihilo solo se pueden utilizar funciones seguras en señales, hasta que se llame a exec().
El motivo es que los mutex y otros mecanismos de sincronización que usan los hilos —incluidos los que la librería del sistema usa por dentro— son en muchas ocasiones variables en la memoria del proceso, que fork() copia en el estado en el que estuvieran en ese instante.
Si un mutex ha sido adquirido por un hilo del padre, en el hijo también aparece adquirido pero por un hilo que allí no existe, así que nadie lo va a liberar nunca.
El caso típico es el del mutex interno que suele proteger la función malloc() de C.
Si otro hilo del padre estaba reservando memoria en el momento del fork(), el hijo se bloqueará para siempre al primer intento de reservar memoria, sin error ni aviso alguno.
Conviene fijarse en que la lista de funciones seguras en señales se aplica aquí por un motivo distinto de aquel para el que se definió en el apartado «Señales POSIX».
Allí el peligro es volver a entrar en una función interrumpida a mitad por una señal, mientras que aquí el problema es encontrarse un mutex que nadie va a liberar.
Tampoco hay que confundir estas funciones con las funciones seguras en hilos (ver el apartado «Seguridad en hilos»), porque de poco sirve que una función proteja sus datos con un mutex si el problema es precisamente dicho mutex en los procesos hijo.
En la práctica, limitarnos a esa lista de funciones entre el fork() y el exec() significa no poder usar muchas de las facilidades que ofrecen C y C++:
Reservar memoria, incluyendo malloc(), new() y, con ellos, clases y funciones que usan memoria dinámica, como std::string, std::vector o std::println(), y toda la E/S basada en flujos.
Lanzar o capturar una excepción, porque la maquinaria que las implementa reserva memoria y consulta al enlazador dinámico para localizar, en cada librería cargada, las tablas usadas para el desenrollado de la pila.
Buscar el ejecutable en PATH con execlp() o execvp(), que no son seguras por eso mismo; aunque versiones más simples como execl() y execv() sí lo sean.
Por eso, para ejecutar otro programa desde un programa multihilo es preferible utilizar posix_spawn(), que crea el proceso y carga en él el nuevo programa sin llegar a ejecutar ni una instrucción del programa del padre en el hijo.
Si aun así se necesita el control que ofrece hacerlo en dos pasos con fork() y exec(), conviene preparar antes de llamar al primero todo lo necesario: resolver la ruta del ejecutable, construir los argumentos y las variables de entorno, reservar memoria y vaciar los búferes de salida.
En el hijo se debe ejecutar solo lo imprescindible: las redirecciones, restaurar la máscara de señales —que se hereda a través de exec()— y terminar con _exit() si exec() falla.
En «Señales POSIX» vimos que las señales son un mecanismo para informar a un proceso del suceso de ciertos eventos.
En el caso de los procesos multihilo, tenemos que preguntarnos qué hilo será interrumpido para atender una señal y cuál es la mejor forma de integrar esta característica en un programa multihilo.
En todo caso, hay que tener en cuenta que el manejo de señales es un recurso del proceso, compartido por todos sus hilos.
Esto quiere decir que si una señal está configurada para ser manejada usando la acción por defecto y dicha acción es terminar, terminará todo el proceso, aunque la señal haya sido dirigida a un hilo en concreto.
En este segundo caso cualquiera de los hilos podrá ser interrumpido para atender la señal y ejecutar el manejador correspondiente.
En un programa de un solo hilo, el proceso bloquea las señales que no quiere recibir de momento con sigprocmask().
En uno multihilo el comportamiento de esa función no está especificado, así que cada hilo debe bloquear las que no quiere atender con pthread_sigmask(), que tiene la misma firma pero solo afecta al hilo que la llama.
De este modo, una señal enviada al proceso interrumpirá a uno de los hilos que no la haya bloqueado.
Las señales enviadas por el sistema se dirigen al proceso o a un hilo en particular, dependiendo de si son síncronas o asíncronas:
Las señales síncronas son causadas por un error en la ejecución, que en un proceso multihilo es debido a la ejecución fallida de una instrucción en un hilo en particular.
Por eso estas señales se dirigen al hilo que las causa.
Ejemplos de señales de este tipo son SIGSEGV, SIGFPE o SIGILL, originadas por accesos ilegales a memoria, divisiones por 0 o ejecutar instrucciones inválidas, respectivamente.
Las señales asíncronas son debidas a acciones externas.
Por eso se dirigen al proceso, pudiendo ser entregadas a uno de los hilos que no las tenga bloqueadas.
Un ejemplo de este tipo de señales es la terminación de procesos con teclas especiales como Ctrl+C o Ctrl+\, que envían al proceso las señales SIGINT y SIGQUIT respectivamente.
En programas multihilo es recomendable no utilizar señales excepto donde sea estrictamente necesario.
Las señales síncronas suelen indicar errores graves de ejecución, por lo que no es recomendable intentar manejarlas.
El comportamiento más seguro es dejar que el proceso termine.
En cambio, es muy probable que queramos manejar señales asíncronas como SIGINT, SIGQUIT, SIGTERM o SIGHUP, para poder terminar el proceso de forma ordenada cuando el usuario o el sistema lo soliciten.
En este caso, la recomendación es crear un hilo en exclusiva para el manejo de señales asíncronas, de tal forma que sea el único que no las tenga bloqueadas.
Como la máscara de señales se hereda al crear un hilo, lo más seguro es bloquearlas en main(), antes de crear el primero.
Así todos nacen con ellas bloqueadas y solo el hilo dedicado a manejarlas las desbloquea.
Si en su lugar cada hilo las bloqueara nada más empezar a ejecutarse, quedaría una ventana en la que podría ser interrumpido por una de ellas.
El hilo encargado de manejar las señales no necesita utilizar manejadores de señal, sino que puede utilizar sigwait() para manejarlas de forma síncrona, en el flujo de ejecución normal del hilo.
Eso nos permite evitar los problemas de seguridad que tienen los manejadores de señal y utilizar cualquier función segura en hilos.
sigwait() permite al hilo bloquearse esperando la llegada de alguna de las señales del conjunto que se le indique.
Cuando esto ocurre, el programa puede determinar la acción a realizar según el número de señal recibido.
Utilizando variables compartidas, tokens de cancelación y mecanismos de sincronización, el hilo puede notificar a los otros hilos la llegada de la señal o la necesidad de cancelar su ejecución.
Espera hasta que una condición sea notificada, liberando mientras tanto el objeto de bloqueo.
A diferencia de std::condition_variable::wait(), acepta cualquier tipo de lock y puede dejar de esperar si se solicita la parada a través de un std::stop_token.
Registra una función que se ejecuta cuando se solicita la detención a través del std::stop_token asociado.
Si la detención ya se había solicitado, la función se ejecuta al construir el objeto.
Examina o cambia la máscara de señales del proceso.
En un proceso multihilo su comportamiento no está definido, por lo que hay que usar pthread_sigmask() en su lugar.
Crea un nuevo hilo preparado para ejecutar código C correctamente.
Llama internamente a CreateThread(), tras inicializar los datos que la librería mantiene por hilo.
Termina el hilo actual, tras liberar los datos que la librería de tiempo de ejecución mantiene por hilo.
Después llama a ExitThread(), que es la verdadera función del sistema para terminar un hilo.
Una convención de llamada fija cómo se pasan los argumentos a una función y quién se encarga de limpiar la pila al retornar.
Con __stdcall los argumentos se meten en la pila de derecha a izquierda y es la función llamada —no quien la llama— la que los extrae de la pila al volver de la llamada, que es lo que esperan las funciones de Windows API. ↩
Microsoft Corporation, «TerminateThread function», Microsoft Learn — Desktop Win32 Apps, 22 de febrero de 2024. ↩
Una retrollamada o función de callback es una función foo() que se pasa como argumento a otra función bar(), de forma que bar() invocará a foo() cuando ocurra un evento determinado. ↩