
18. Almacenamiento secundario
Propiedades físicas de discos magnéticos, discos ópticos y memorias de estado sólido, el archivo como abstracción del almacenamiento y los volúmenes construidos con RAID, particiones y gestores de volúmenes.
Los dispositivos de almacenamiento secundario —como discos duros o memorias de estado sólido— organizan su espacio de almacenamiento en bloques de bytes, a diferencia de la memoria principal, donde se pueden leer y modificar bytes individualmente. No resultaría muy ergonómico que los usuarios y los programas tuvieran que usar ese espacio direccionando bloques directamente, así que el sistema operativo lo abstrae tras el concepto de archivo. En este capítulo veremos primero qué propiedades físicas tienen los dispositivos que hay debajo de esa abstracción y después cómo se organiza su espacio en volúmenes, que es donde en el capítulo siguiente alojaremos los sistemas de archivos.
Dispositivos de almacenamiento
Sección titulada «Dispositivos de almacenamiento»Los ordenadores pueden almacenar información en diferentes soportes de almacenamiento —por ejemplo, en discos magnéticos, DVD o memorias de estado sólido—. Cada uno tiene propiedades físicas diferentes.
Discos magnéticos
Sección titulada «Discos magnéticos»Los discos magnéticos son el tipo principal de almacenamiento secundario, generalmente en la forma de lo que se denominan discos duros.
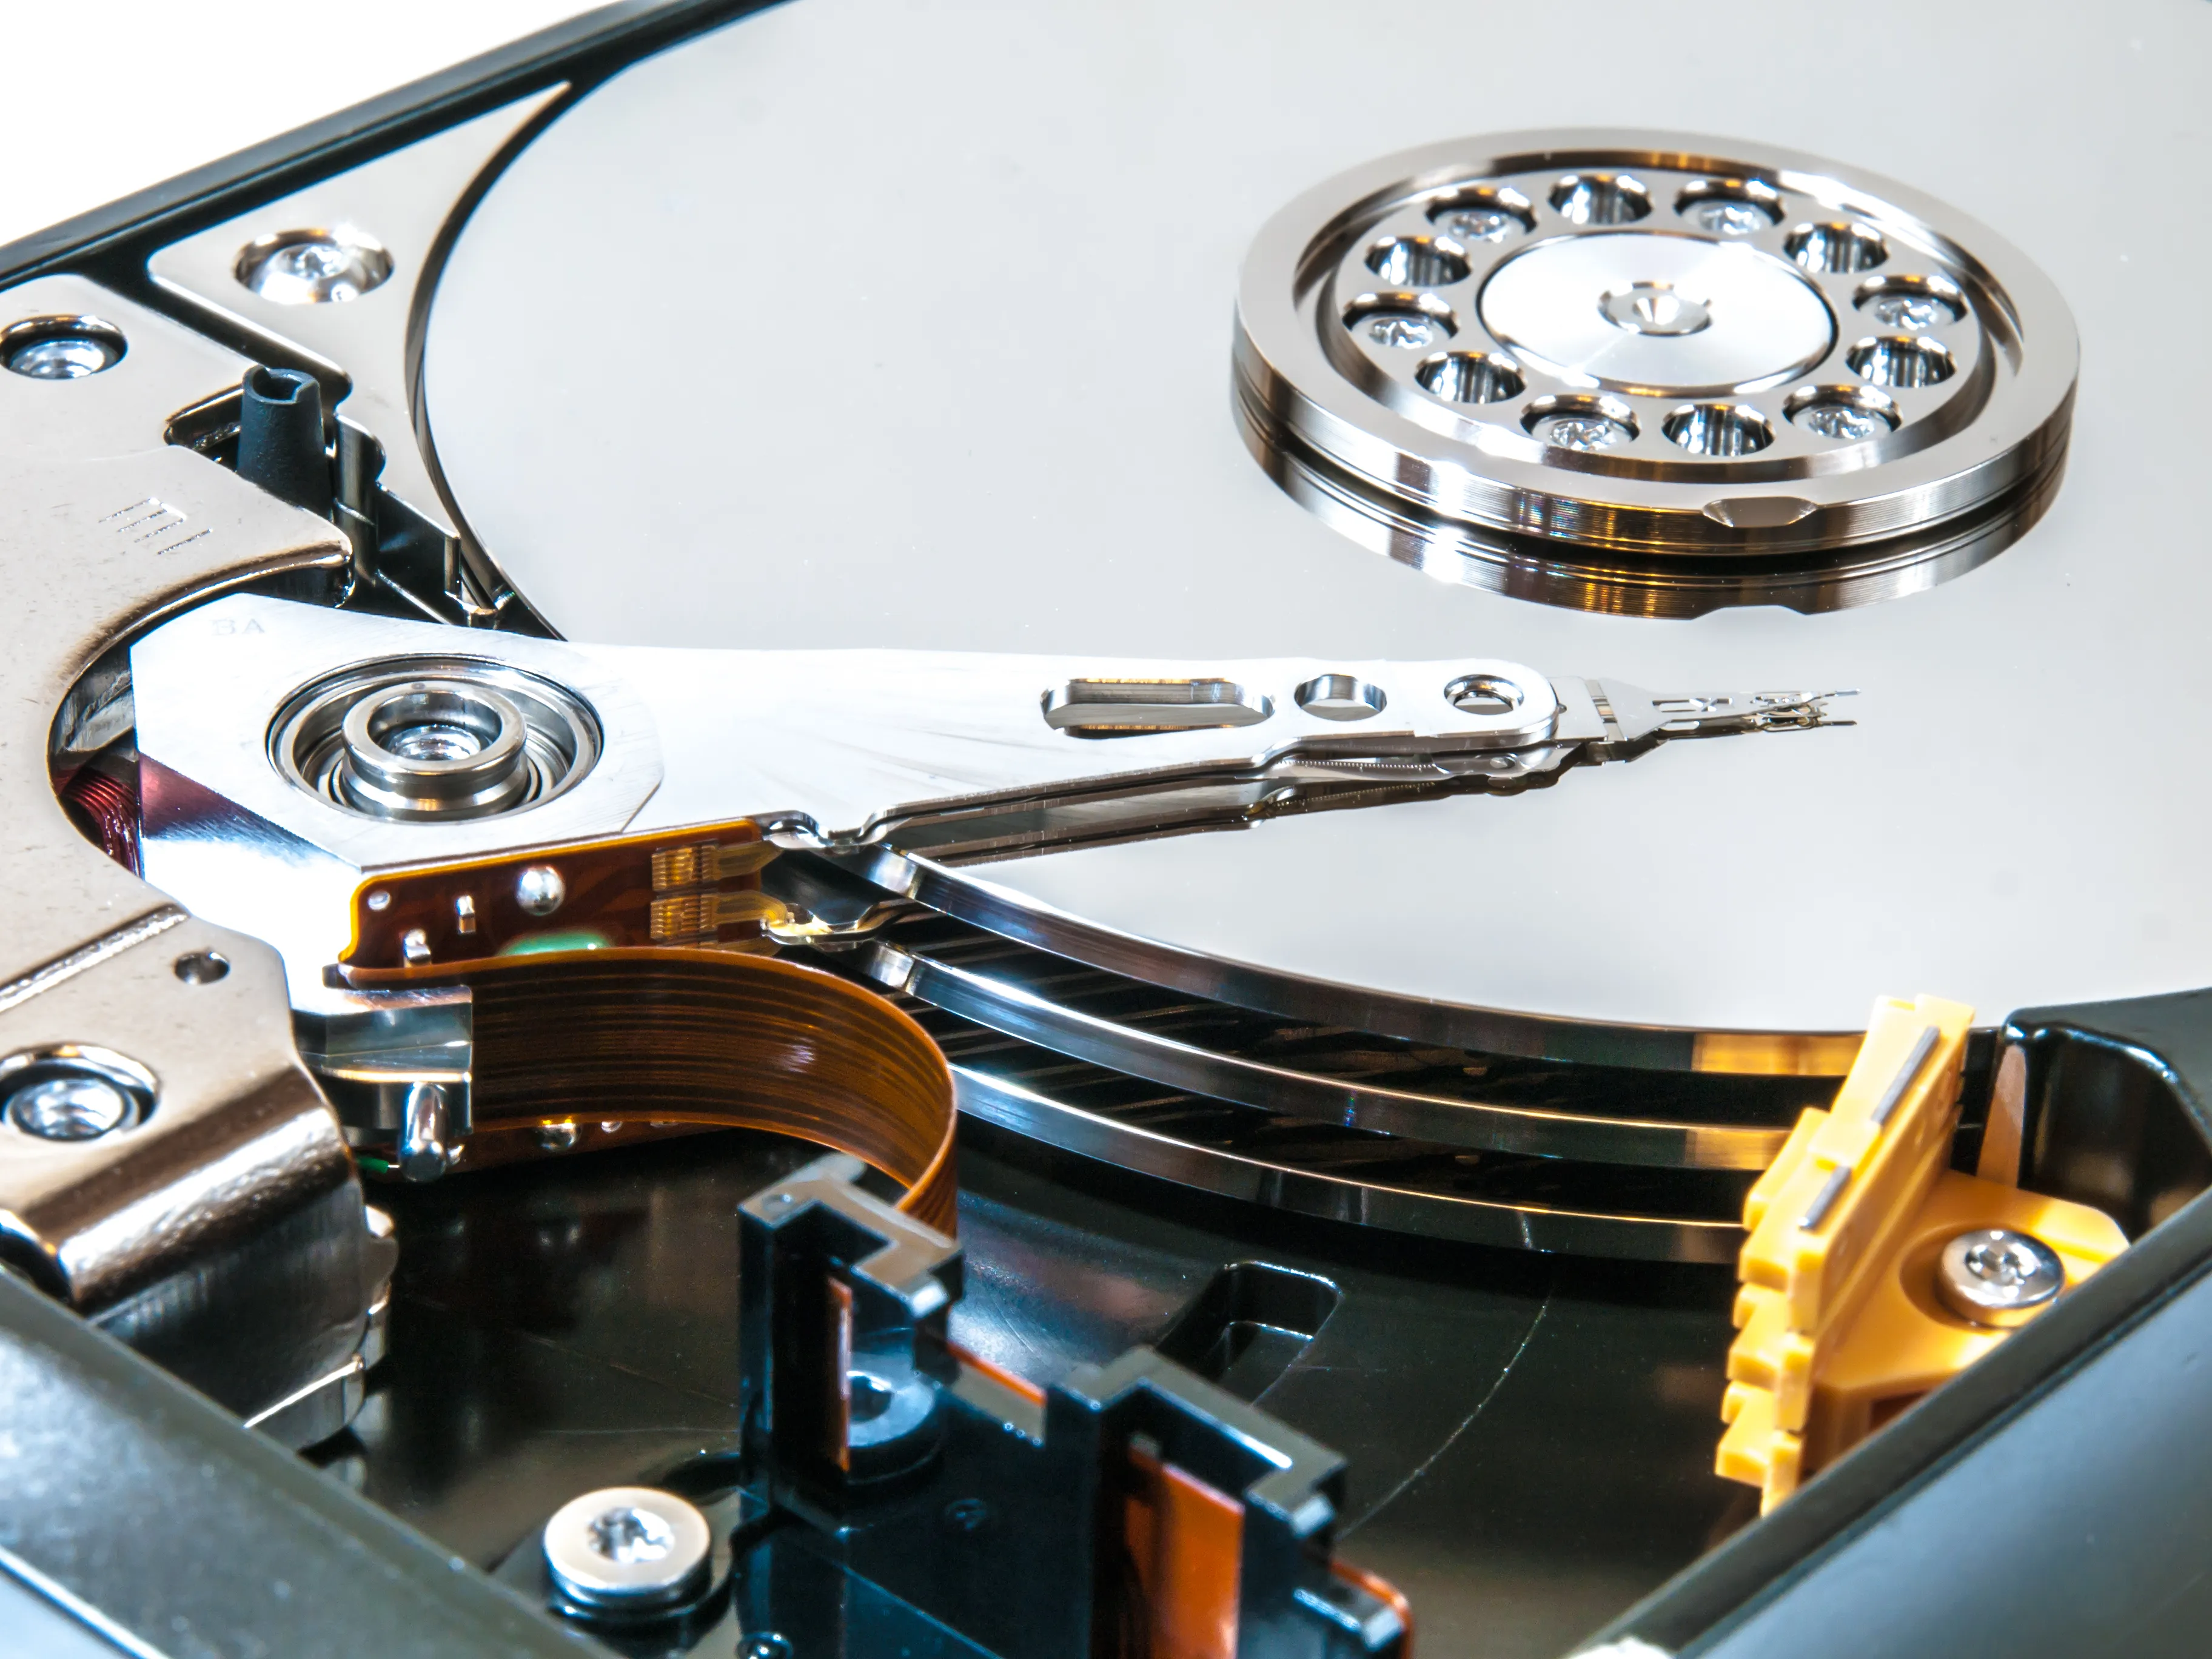
Tal y como se puede apreciar en la figura anterior, cada unidad está compuesta por una serie de platos de forma circular recubiertos de material magnético. La información se almacena grabándola magnéticamente sobre los platos, para lo cual se utilizan unas cabezas de lectura que «flotan» tanto por encima como por debajo de cada plato.
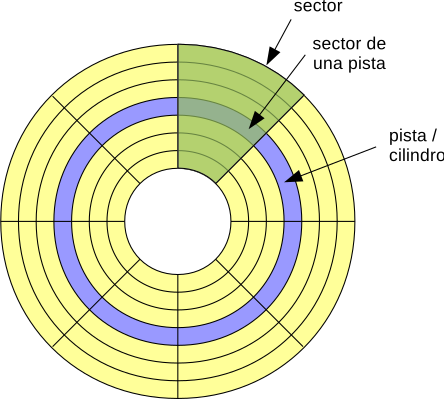
Desde el punto de vista lógico (ver la figura anterior) la superficie de cada plato está dividida en pistas circulares, cada una de las cuales se subdivide en sectores. El conjunto de pistas formado por todas aquellas que están situadas en la misma posición en los distintos platos se denomina cilindro.
En estos dispositivos consume mucho más tiempo mover la cabeza de lectura hasta el sector de interés que la lectura y transferencia de los datos almacenados a la memoria RAM. Por lo tanto, el tiempo de acceso aleatorio al disco es mucho mayor que el de acceso secuencial.
Discos ópticos
Sección titulada «Discos ópticos»Los discos ópticos —CD, DVD, Blu-ray o cualquier otro medio similar— consisten en un disco circular en el cual la información se almacena haciendo uso de surcos microscópicos, que se leen haciendo incidir un láser sobre una de las caras planas que lo componen.
En este tipo de discos la información se almacena siguiendo un recorrido continuo en espiral que cubre la superficie entera del disco, extendiéndose desde el interior hacia el exterior. Dado que el láser siempre debe desplazarse sobre la espiral, el acceso aleatorio a los datos es más lento que con otras tecnologías de disco.
Memorias de estado sólido
Sección titulada «Memorias de estado sólido»Una memoria de estado sólido —una memoria USB o un SSD (Solid-State Drive)— es un dispositivo de almacenamiento que usa una memoria no volátil —como las memorias flash— para almacenar datos, en lugar de utilizar discos ópticos o magnéticos.
En este tipo de memorias la información se almacena como en un vector lineal de bytes, que se puede indexar aleatoriamente con la misma eficiencia con la que se accede secuencialmente —como ocurre con la memoria RAM—. Sin embargo, algunos dispositivos, de cara al resto del sistema informático, emulan una interfaz y un modo de direccionamiento similar al utilizado por los discos magnéticos —es decir, usando pistas, sectores y cilindros— por razones de compatibilidad.
Archivos y sistemas de archivos
Sección titulada «Archivos y sistemas de archivos»Teniendo en cuenta la gran diversidad de dispositivos de almacenamiento que existen, para que el sistema informático sea cómodo de utilizar, el sistema operativo proporciona una visión lógica uniforme de todos los sistemas de almacenamiento. Es decir, abstrae las propiedades físicas de los dispositivos de almacenamiento para definir una unidad de almacenamiento lógico que sea útil para los usuarios. Esta unidad es el archivo.
Un archivo o fichero es una colección de datos relacionados, identificados por un nombre, que es tratada por el sistema operativo como la unidad de información en el almacenamiento secundario. Desde la perspectiva de los usuarios, un archivo es la unidad más pequeña de almacenamiento. Es decir, los usuarios no pueden escribir datos en el almacenamiento secundario a menos que estos se encuentren dentro de un archivo.
El sistema operativo puede ofrecer esta abstracción gracias al sistema de archivos. Este proporciona los mecanismos para el almacenamiento de los datos y programas en archivos, tanto del propio sistema operativo como los de todos los usuarios del sistema informático.
Los sistemas de archivos están compuestos de dos partes claramente diferenciadas:
-
Una colección de archivos, cada uno de los cuales almacena una serie de datos relacionados.
-
Una colección de estructuras de metadatos, que contienen información relativa a los archivos almacenados —nombre, ubicación en el disco, permisos, entre otros— y que se encarga de organizarlos, generalmente haciendo uso de una estructura de directorios.
Volúmenes de datos
Sección titulada «Volúmenes de datos»Un dispositivo de almacenamiento se puede dedicar por completo a un único sistema de archivos. Sin embargo, en ocasiones es interesante hacer divisiones con el objeto de disponer de múltiples sistemas de archivos en el mismo dispositivo. Cada una de esas divisiones es un volumen.
En otros casos interesa combinar divisiones o dispositivos de almacenamiento completos para crear espacios de mayor tamaño —también denominados volúmenes— cada uno de los cuales puede albergar un único sistema de archivos. Así que, en general, utilizaremos el término volumen para referirnos a cualquier espacio de almacenamiento que alberga un sistema de archivos. Da lo mismo que sea una porción de un dispositivo o una estructura mayor compuesta a partir de varios.
A continuación veremos las tecnologías más utilizadas para construir estos volúmenes.
La tecnología RAID (Redundant Array of Inexpensive Disks, hoy más comúnmente Independent) permite combinar varios discos duros para mejorar las prestaciones a través del paralelismo en el acceso o para mejorar la fiabilidad a través del almacenamiento de información redundante. En concreto se definen diversos niveles RAID, de entre los cuales los más comunes son:
-
En un conjunto RAID 0 se distribuyen los datos equitativamente en bloques de tamaño fijo entrelazados entre dos o más discos, sin incluir ningún tipo de información redundante. Esto permite leer y escribir más datos al mismo tiempo, ya que se pueden enviar en paralelo peticiones a los distintos discos. Sin embargo, la fiabilidad empeora conforme se añaden discos, ya que para que el conjunto falle basta con que lo haga cualquiera de ellos. Si los fallos son independientes, el tiempo medio hasta el fallo del conjunto es el de un disco dividido entre el número de discos.
-
En un conjunto RAID 1 se crea una copia exacta —en espejo— de los datos en dos o más discos. Como para perder los datos tienen que fallar todos los discos, la probabilidad de que el conjunto falle es el producto de las de cada uno. Es decir, decae exponencialmente con el número de copias, por tanto, con solo dos discos ya es muchísimo menor que con uno. Adicionalmente, el rendimiento en las operaciones de lectura se incrementa linealmente con el número de copias, ya que los datos están disponibles en todos los discos al mismo tiempo, por lo que se pueden balancear las operaciones de lectura entre todos ellos.
-
En un conjunto RAID 5 se distribuyen los datos equitativamente en bloques de tamaño fijo entrelazados entre dos o más discos y se utiliza uno adicional para almacenar la información de paridad de los bloques de una misma división. En RAID se denomina división o stripe a la serie de bloques consecutivos, escogidos de cada uno de los discos del conjunto. El disco utilizado para almacenar el bloque de paridad cambia de forma escalonada de una división a la siguiente, de ahí que se diga que el bloque de paridad está distribuido. Algunos aspectos adicionales a tener en cuenta son que:
-
Cada vez que se escribe un bloque de datos se debe actualizar el bloque de paridad. Por lo tanto las escrituras en un conjunto RAID 5 son costosas en términos de operaciones de disco y tráfico.
-
Los bloques de paridad no se leen durante las lecturas de datos, ya que eso reduciría el rendimiento. Solo se leen cuando falla la lectura de un sector. Entonces el sector erróneo se reconstruye a partir de los que ocupan la misma posición relativa en los demás bloques de datos de la división y en el bloque de paridad.
-
En un conjunto RAID 5 el fallo de 2 discos provoca la pérdida completa de los datos. Esto significa que aunque se pueden añadir discos de manera ilimitada, eso no suele ocurrir, puesto que a más discos en el conjunto más probabilidad de que fallen dos de ellos.
-
-
En un conjunto RAID 6 se utiliza la misma estrategia que en RAID 5, pero en cada división hay dos bloques de paridad —en lugar de uno— en dos discos diferentes. Esto permite que fallen hasta dos discos sin perder los datos.
-
En un conjunto con niveles anidados se combinan varios niveles RAID básicos como si fueran capas superpuestas. Ejemplos típicos son:
- RAID 0+1, donde se hace un espejo de un conjunto RAID 0.
- RAID 1+0 o RAID 10, donde diversos conjuntos en espejo se combinan en un RAID 0, aumentando la capacidad total.
- RAID 50, donde diversos conjuntos RAID 5 se combinan en un RAID 0, aumentando también la capacidad total.
La implementación de RAID es otra de las áreas donde existen diversas variantes:
-
RAID puede implementarse en el hardware de la controladora de disco, de tal forma que solo los discos conectados a esta pueden formar parte de un conjunto RAID determinado. Esta solución es muy eficiente, especialmente cuando se utilizan niveles que requieren cálculo de la paridad, ya que se evita utilizar tiempo de CPU para ese trabajo. Sin embargo, estas controladoras son notablemente más caras que las que carecen de soporte para RAID.
-
RAID puede implementarse dentro del sistema operativo en lo que se denomina el software de gestión de volúmenes. En este caso las soluciones RAID con paridad son bastante lentas, por lo que normalmente solo se soportan los niveles RAID 0, 1, 10 o 0+1. Algunas controladoras de disco modernas que dicen venir con soporte RAID realmente implementan esta tecnología en software, a nivel del controlador de dispositivo, mientras que en el hardware solo se implementan unas características de apoyo mínimas. En algunos entornos se denomina a este tipo de implementaciones fakeRAID o hostRAID.
Cada conjunto RAID se comporta como una unidad de almacenamiento independiente desde el punto de vista del resto del sistema, por lo que se puede utilizar entero para albergar un único sistema de archivos. Sin embargo, lo más común es dividirlo en regiones con el objeto de utilizar múltiples sistemas de archivos o combinarlo en estructuras de mayor tamaño, para lo cual se puede utilizar alguna de las técnicas que veremos a continuación.
Particiones
Sección titulada «Particiones»Un disco, un conjunto RAID o cualquier otro dispositivo de almacenamiento se puede dividir en regiones para utilizar en cada una de ellas un sistema de archivos diferente. A esas regiones se las conoce comúnmente como particiones, franjas o minidiscos.
Según la plataforma, existen diversas maneras de implementar el soporte de particiones. Entre los sistemas de escritorio las tecnologías más difundidas y utilizadas son la MBR (Master Boot Record) y la GPT (GUID Partition Table). En ambas se almacena, en los primeros sectores del dispositivo de almacenamiento, una tabla con una entrada por partición donde se guardan las direcciones del primer y último sector de cada una de ellas en el dispositivo, así como otra información. Eso es todo lo que necesita el sistema operativo para determinar los límites de la región ocupada por cada sistema de archivos.
Volúmenes dinámicos
Sección titulada «Volúmenes dinámicos»Según la tecnología que se utilice para particionar es posible encontrarse con una serie de restricciones comunes:
- Limitado número de particiones que puede contener un mismo dispositivo.
- Limitaciones o imposibilidad de redimensionar las particiones, especialmente si el sistema operativo está en ejecución.
- La imposibilidad de crear particiones que hagan uso de regiones libres en diferentes dispositivos de almacenamiento.
Para resolverlo, algunos sistemas operativos incluyen un software de gestión de volúmenes que hace uso de tecnología propia para superar estas limitaciones. Estas herramientas generalmente permiten agrupar dispositivos completos, conjuntos RAID, particiones, etc. y sobre ellos construir los volúmenes que sean necesarios. Estos volúmenes dinámicos pueden ser redimensionados —en ocasiones sin tener que detener la ejecución del sistema operativo— y en caso de que haga falta se pueden incluir dinámicamente nuevos dispositivos para incrementar el espacio disponible. Además, como ya hemos comentado, el software de gestión de volúmenes puede incluir alguna funcionalidad propia de conjuntos RAID, con el objeto de mejorar las prestaciones a través del paralelismo en el acceso, o mejorar la fiabilidad a través del almacenamiento de información redundante.