Clasificación de los sistemas operativos según su propósito y el hardware que gestionan, desde los grandes mainframes hasta los sistemas distribuidos y de tiempo real.
·29 min de lectura
Ahora que sabemos que todos los sistemas operativos hacen lo mismo, pero que el «cómo» lo hacen difiere de un tipo de sistema informático a otro, vamos a ver los tipos de sistemas informáticos, las características de los sistemas operativos que los gestionan y cómo han evolucionado a lo largo de la historia.
Los ordenadores centrales o mainframes1 fueron los primeros computadores utilizados en muchas aplicaciones comerciales y científicas.
Se caracterizan no tanto por la potencia de su CPU como por su: gran capacidad de memoria, gran capacidad de almacenamiento secundario, gran cantidad de dispositivos de E/S y rapidez de estos y alta fiabilidad.
Los mainframes pueden funcionar durante años sin problemas ni interrupciones y las reparaciones se realizan sin detener su funcionamiento.
Aparecieron a finales de la década de los 50 del siglo pasado y han seguido evolucionando hasta la actualidad, por lo que dentro de este tipo de sistemas nos encontramos con varias categorías.
Los primeros mainframes eran enormes máquinas operadas desde una consola y conectados a lectores de tarjetas perforadas2, dispositivos de cinta e impresoras.
El trabajo era preparado por cada programador —normalmente en tarjetas perforadas— y entregado al operador del sistema, que era quien tenía acceso al sistema y la responsabilidad de ejecutar los programas y devolver los resultados al programador correspondiente.
No había sistema operativo y el operador debía cargar y ejecutar cada programa de uno en uno.
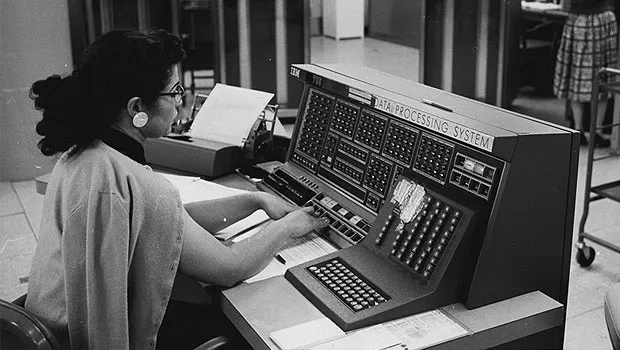
Operadora en la consola de un mainframe IBM 705. Estas consolas se usaban para controlar el ordenaodor y para depurarlo. El IBM 705 fue anunciado en 1954 y como principal innovación utilizaban memorias de núcleos magnéticos en lugar de tubos de vacío para almacenar los datos y los programas, lo que les permitía tener más memoria y más rápida y fiable que sus predecesores. Fotografía cortesía de IBM, ibm.com/history.
Estos sistemas se convirtieron en sistemas de procesamiento por lotes o sistemas en batch cuando se comenzó a utilizar un pequeño programa —llamado monitor del sistema— cuya función era cargar y ejecutar sin interrupción un conjunto —o lote— de programas.
En los sistemas de procesamiento por lotes se automatizó el proceso de ejecución de los programas, de forma que el operador solo tenía que entregar al sistema un conjunto de programas y este se encargaba de ejecutarlos uno tras otro.
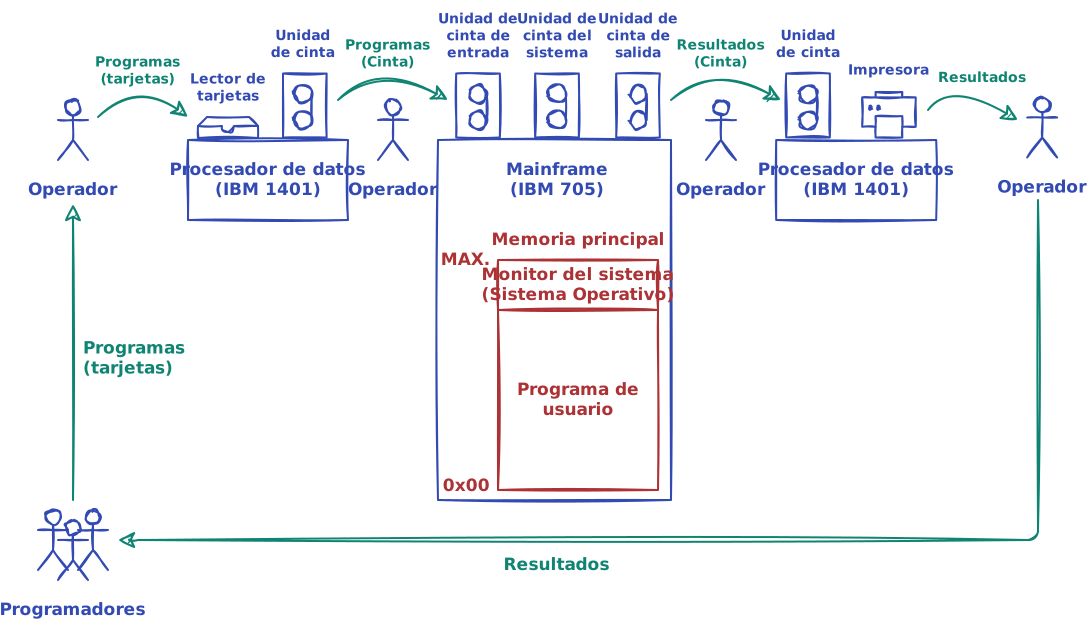
El operador cargaba previamente en cinta magnética el conjunto de programas a partir de las tarjetas perforadas proporcionadas por los programadores. Como se ilustra en la figura siguiente, para ello se utiliza un ordenador autónomo —independiente del mainframe— con lector de tarjetas y unidad de cinta.
Posteriormente, el operador mueve la cinta con el conjunto de programas a la unidad de cinta de entrada del mainframe y lanza la ejecución del monitor del sistema, para que este se encargue de ir leyendo y ejecutando cada uno de los programas.
Para obtener mayor rendimiento, los resultados de los programas se escriben en una unidad de cinta diferente.
Cuando termina la ejecución de todo el conjunto, el operador lleva la cinta a otro ordenador autónomo para leer los resultados e imprimirlos, con el objeto de entregárselos a los programadores.
Gestión de trabajos en sistemas de procesamiento por lotes.
Estos sistemas seguían presentando un inconveniente importante respecto al rendimiento.
Si solo se puede ejecutar un programa la vez, cuando un programa solicita una operación de E/S —por ejemplo, para cargar los datos requeridos para sus cálculos o para guardar o imprimir los resultados— la CPU queda a la espera de que esta termine para continuar con la ejecución del programa, por lo que se pierde tiempo de CPU en no hacer nada. Este desaprovechamiento de la CPU es peor cuanto más rápida es la CPU respecto a los dispositivos de E/S.
Monitor del sistema
En resumen, el monitor del sistema:
Era un predecesor de los sistemas operativos.
Permanece cargado durante todo el tiempo en la memoria del sistema (ver la figura anterior).
Su única tarea es cargar y transferir automáticamente la ejecución de un programa al siguiente cuando el anterior termina.
Como sólo puede ejecutar un programa a la vez, no resuelve el inconveniente de que la CPU permanece mucho tiempo desocupada cuando los programas solicitan operaciones de E/S.
El problema de la CPU desocupada mientras se realizaban operaciones de E/S es especialmente grave porque la CPU es varios órdenes de magnitud más rápida que los dispositivos de E/S.
Y esto solo ha empeorado con el tiempo, ya que la velocidad de las CPU ha ido aumentando mucho más rápido que la de los dispositivos de E/S.
La solución a este inconveniente es que los programas no accedan directamente al dispositivo de E/S, sino que, en su lugar, soliciten la operación al monitor del sistema para que este la solicite, a su vez, al hardware.
Así el sistema operativo —como podemos comenzar a llamarlo— tiene la oportunidad de sustituir el programa en la CPU por otro, mientras la operación de E/S se completa.
Además, con la aparición de la tecnología de los discos magnéticos en la década de los 60 del siglo pasado, los trabajos de los programadores comenzaron a ser almacenados en discos, desde donde eran escogidos por el sistema operativo para su ejecución.
A estos sistemas se los llamó sistemas multiprogramados, porque permitían tener varios programas en memoria al mismo tiempo e intercalar su ejecución en la CPU.
A la cantidad de programas cargados en memoria en un instante dado se la denomina grado de multiprogramación.
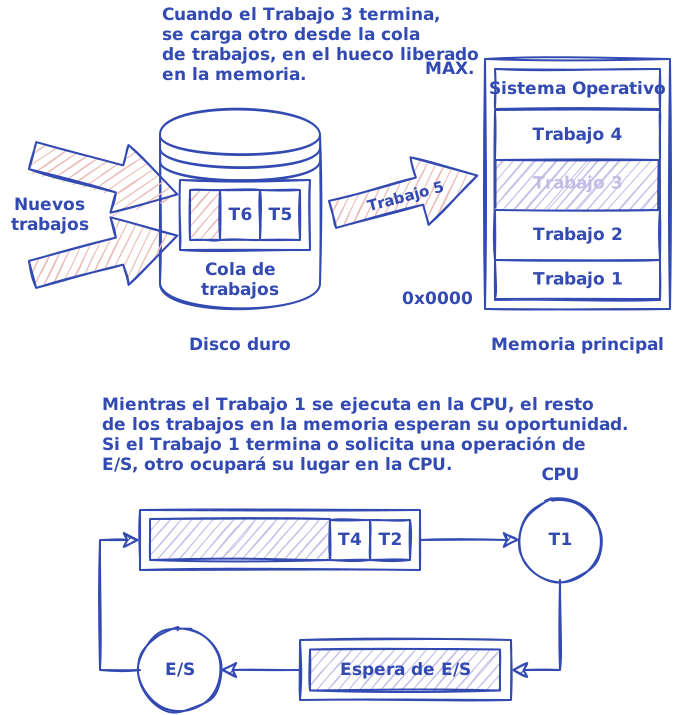
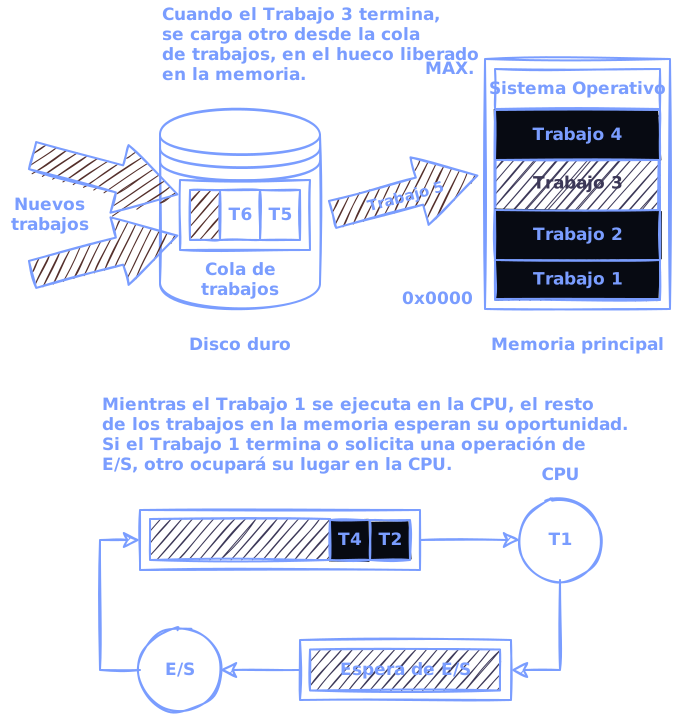
Gestión de trabajos en sistemas multiprogramados.
Como se ilustra en la figura anterior, en los sistemas multiprogramados:
Se almacena en el disco magnético una cola donde se van colocando todos los trabajos que tienen que ser ejecutados.
El sistema operativo carga varios trabajos en memoria del conjunto de trabajos en la cola en el disco magnético.
La ejecución de los trabajos se realiza intercalando su ejecución en la CPU de la siguiente manera:
El sistema operativo cede la CPU a uno de los trabajos cargados en la memoria.
Cuando el trabajo en la CPU requiere usar la E/S se lo pide al sistema operativo y este, en lugar de mantener a la CPU ocupada inútilmente, suspende la ejecución del trabajo, programa la operación de E/S y escoge otro trabajo de entre los que están en memoria para ejecutarlo en la CPU.
Cuando la operación de E/S del anterior trabajo termina, el programa que ocupa la CPU no es interrumpido. En su lugar, debe esperar a una nueva oportunidad de ser escogido para ejecutarse en la CPU, cuando el trabajo actualmente en la CPU termine o solicite una operación de E/S.
Cuando un programa en la CPU termina, sus recursos se liberan, dejando libre la memoria que ocupaba.
Entonces el sistema operativo puede escoger un nuevo trabajo de la cola de trabajos en el disco magnético y lo carga en la memoria.
Todo este proceso se repite mientras haya trabajos que ejecutar en la cola de trabajos en el disco magnético.
Para operar de la forma descrita es necesario que el sistema operativo realice tres tareas esenciales:
La planificación de trabajos, cuya responsabilidad es seleccionar el siguiente trabajo que será cargado en la memoria principal para mantenerla llena.
La planificación de la CPU, cuya responsabilidad es elegir el siguiente trabajo que será ejecutado en la CPU, de entre los disponibles en la memoria principal.
La gestión de la memoria, cuya responsabilidad es repartir la memoria principal entre los trabajos alojados en la misma.
Un ejemplo de este tipo de sistemas operativos es el IBM OS/360, que fue lanzado en 1966 para utilizarlo en los mainframes IBM System/360 (ver el apartado «Segunda generación (1955-64)»).
Los sistemas multiprogramados ofrecían un uso más eficiente de la CPU, pero no eran capaces de proporcionar interacción directa con los usuarios.
Los programadores seguían teniendo que entregar los trabajos al operador y esperar a que este les devolviera los resultados, lo que acabó conviertiéndose en un cuello de botella que limitaba la productividad de los programadores y el aprovechamiento de los mainframes según estos se iban haciendo más rápidos y potentes.
Los sistemas de tiempo compartido se desarrollaron tras observar que al dar acceso a un grupo de usuarios se podía conseguir un uso más eficiente del sistema, en comparación a cuando solo podía ser utilizado por un usuario a la vez.
Esto es debido a que, generalmente, un usuario introduce información de forma continua para luego detenerse durante largos periodos de tiempo, mientras que en un grupo de usuarios, las pausas de uno de ellos se pueden llenar con la actividad de los otros.
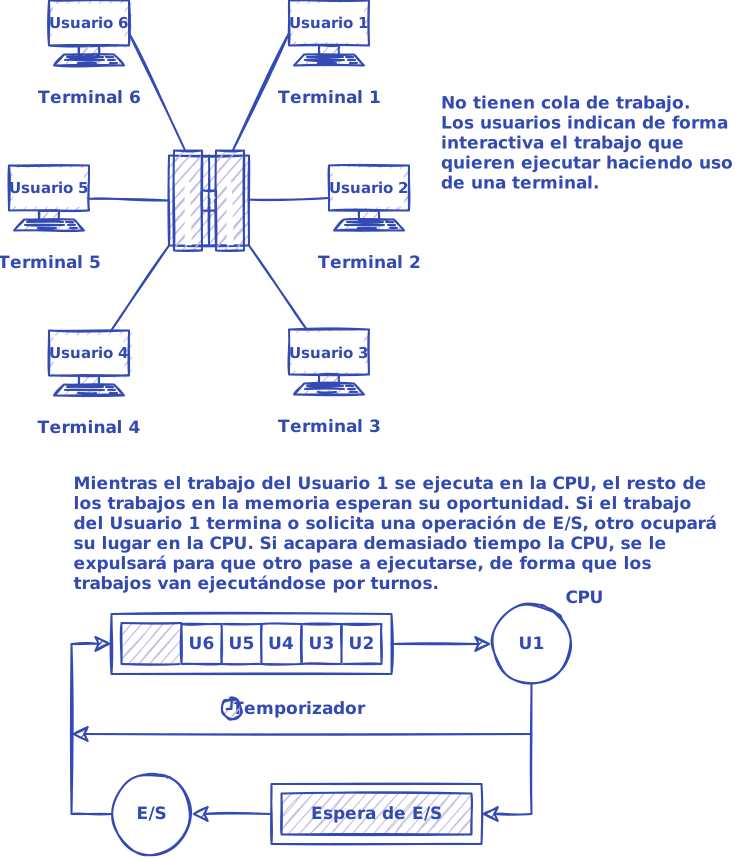
Gestión de trabajos en sistemas de tiempo compartido.
En la figura anterior se ilustra el funcionamiento de los sistemas de tiempo compartido, que se caracterizaban por:
Disponer de terminales, es decir, hardware especializado en hacer de interfaz directa entre los usuarios y el sistema.
A través de estas terminales los usuarios podían enviar comandos al sistema e interactuar con sus trabajos.
Podía haber múltiples usuarios al mismo tiempo, pero cada uno solo podía tener un trabajo en ejecución a la vez.
Usar la multiprogramación para tener varios trabajos en la memoria principal al mismo tiempo e intercambiar el trabajo en la CPU cuando este solicitaba una operación de E/S, como ya se venía haciendo en los sistemas multiprogramados para hacer un uso más eficiente de la CPU.
Repartir el tiempo de CPU entre usuarios.
El sistema operativo asignaba un tiempo de CPU a cada usuario —denominado ventana de tiempo o cuanto de CPU—.
Cuando este tiempo se agotaba, el sistema intercambiaba el trabajo en la CPU por el de otro usuario en el sistema.
La ventana de tiempo era extremadamente pequeña, dando a cada usuario la impresión de que su trabajo nunca se detenía, como si dispusiera de la CPU en exclusiva.
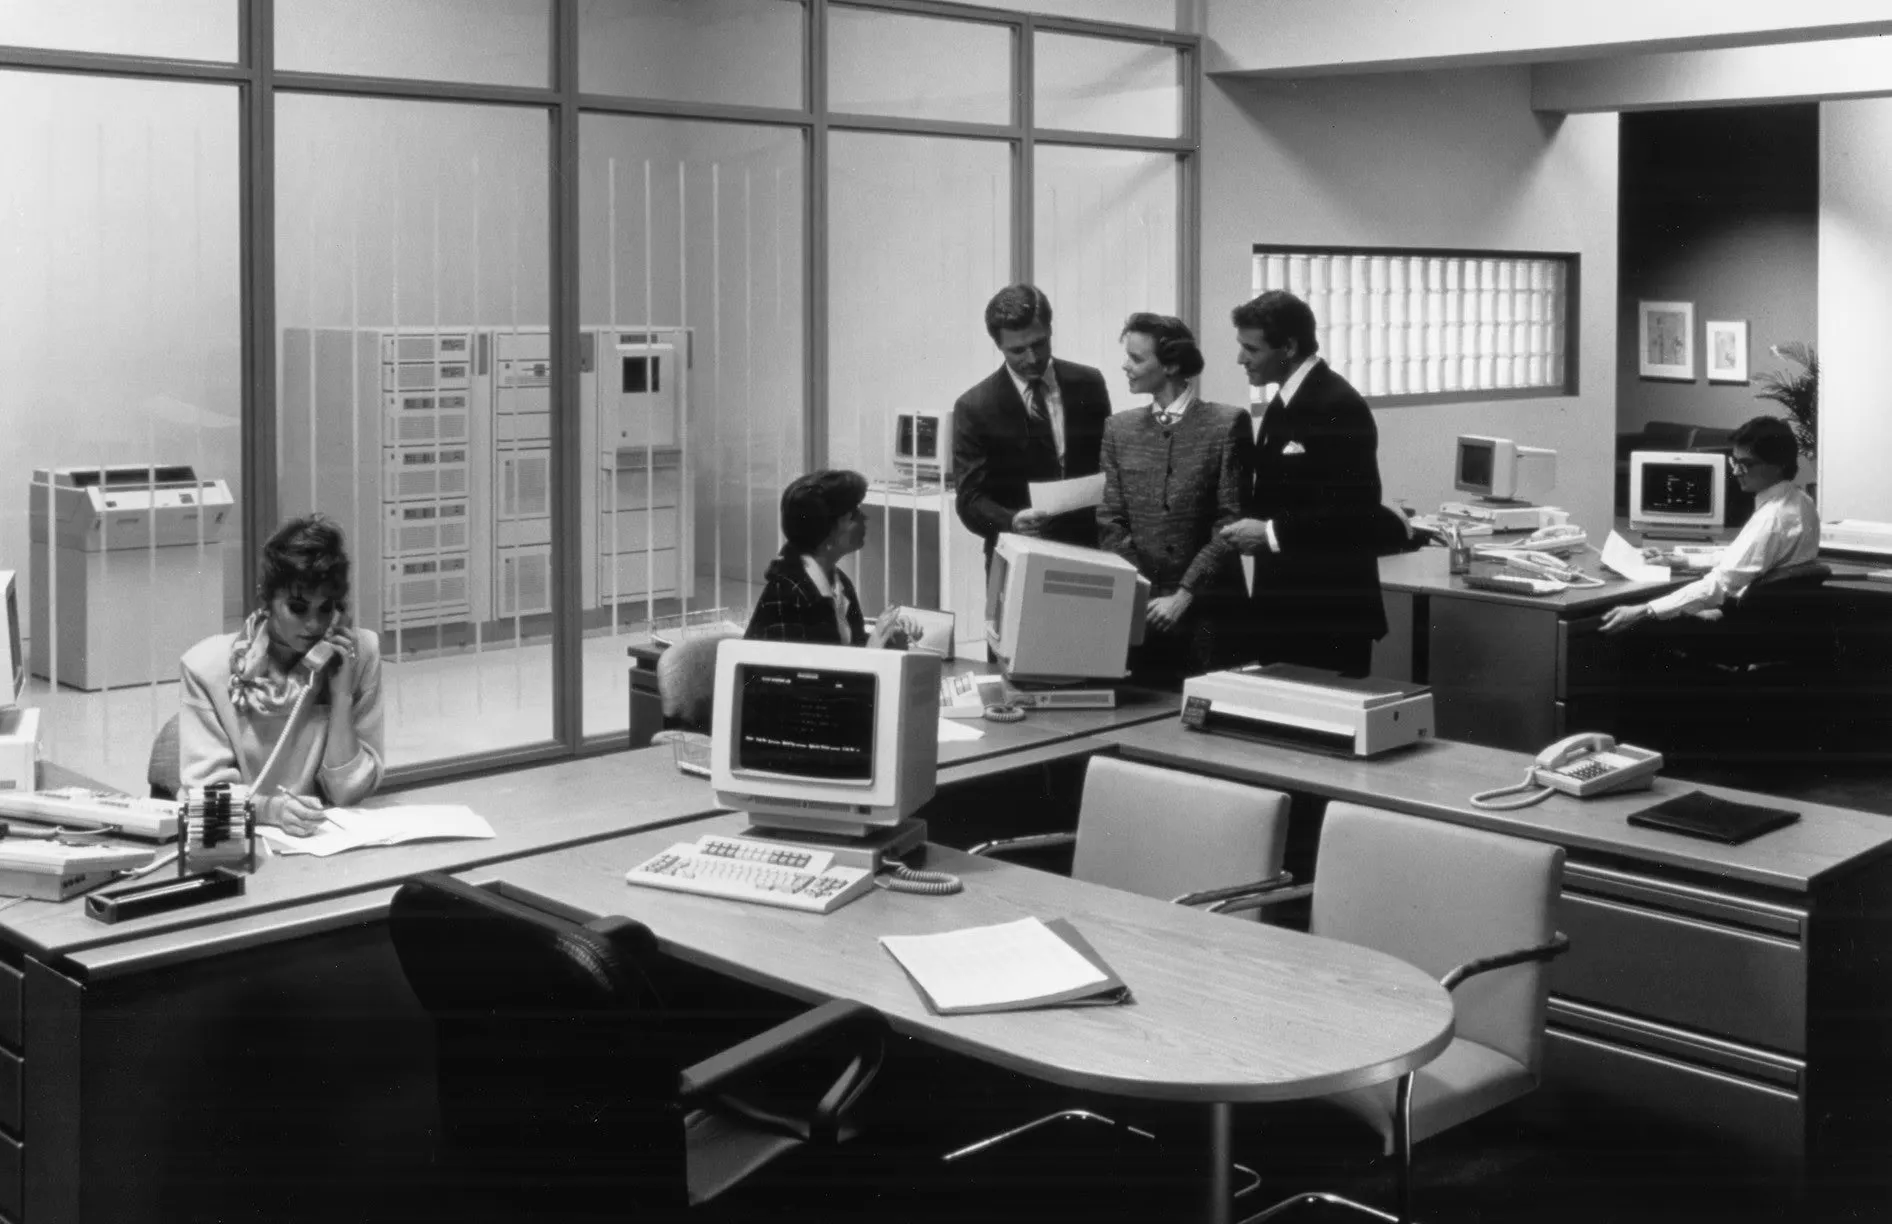
Oficina de finales de los años 80. Empleados operando terminales conectados a un sistema central IBM AS/400, ubicado al fondo en la sala técnica acristalada. Fotografía cortesía de IBM, ibm.com/history.
Los sistemas de tiempo compartido significaron un salto importante en complejidad por diversas razones:
Como varios trabajos están en la memoria principal al mismo tiempo, el sistema operativo requiere mecanismos de gestión de la memoria y protección.
Para tener un tiempo de respuesta razonable, los trabajos deben estar cargados en la memoria principal.
Para que quepan más trabajos de los usuarios en la memoria, el sistema operativo debe utilizar técnicas de memoria virtual para ejecutar trabajos que no están completamente cargados en la memoria principal.
Como la CPU debe ser compartida entre todos los trabajos, el sistema operativo necesita mecanismos de planificación de la CPU.
Como varios trabajos pueden tener la necesidad de cooperar y que su ejecución siga cierto orden, el sistema operativo debe proporcionar mecanismos de sincronización y comunicación.
Como el sistema debe disponer de un sistema de archivos para repartir el espacio en disco y facilitar a los usuarios el acceso y gestión de sus datos, el sistema operativo necesita un componente de gestión de discos.
Las primeras versiones de UNIX —lanzado por primera vez en 1970— el sistema operativo VMS —desarrollado en 1978— para los VAX de Digital Equipment Corporation y el IBM OS/400 —introducido en 1988— utilizado en las minicomputadoras AS/400, son algunos ejemplos de sistemas operativos de tiempo compartido (ver el apartado «Tercera generación (1965-1968)»).
Sistemas de tiempo compartido vs. sistemas multitarea modernos
Es importante tener en cuenta que, estrictamente hablando, el término sistemas de tiempo compartido hace referencia a estos mainframes desarrollados a partir de principios de la década de 1970.
Así que no es común utilizarlo para designar mainframes modernos.
Los mainframes modernos permiten a un mismo usuario ejecutar varios trabajos al mismo tiempo, repartiendo el tiempo de CPU entre todos los trabajos en el sistema y no solo entre los usuarios.
Y lo mismo ocurre en la mayor parte de los sistemas operativos de propósito general actuales —utilizados en ordenadores de escritorio, servidores, portátiles y dispositivos móviles— que con el tiempo han copiado muchas características de los sistemas de tiempo compartido.
Por eso el término que se utiliza actualmente es sistema multitarea, que es mucho más general.
La multitarea es un método para tener varios procesos en memoria y ejecutarlos «al mismo tiempo».
Generalmente requiere de técnicas de multiprogramación, como las empleadas por los antiguos sistemas multiprogramados, y de reparto del tiempo de CPU, como ocurre en los antiguos sistemas de tiempo compartido.
Por eso se puede decir que ambos tipos de sistemas mainframe eran sistemas multitarea, aunque esta estaba mucho más limitada que en los sistemas operativos actuales.
Denominamos sistemas de escritorio a los sistemas operativos que se ejecutan en ordenadores domésticos o personales —que son mucho más pequeños y baratos que los mainframes—.
En la década de los 70 del siglo pasado los mainframes y las minicomputadoras —máquinas multiusuario de rango medio, algo más pequeñas y baratas que los mainframes— siguieron siendo los ordenadores corporativos por excelencia.
Pero en el ámbito personal, el desarrollo de las primeras CPU en microprocesadores —como el Intel 4004 (1971) y el Intel 8080 (1974)— trajo la aparición de los primeros microordenadores o microcomputadoras.
Las primeras microcomputadoras no incluían teclado ni monitor y se programaban usando interruptores y ledes ubicados en el frontal de la unidad, por lo que eran muy difíciles de usar y no se popularizaron.
Pero en torno a 1977 apareció la segunda generación de microcomputadoras, que sí incluían estos periféricos de E/S, por lo que eran más fáciles de usar que sus predecesoras.
Entonces comenzaron a recibir el nombre de ordenadores domésticos y de su mano llegaron los primeros sistemas operativos de escritorio, que simplificaron su uso.
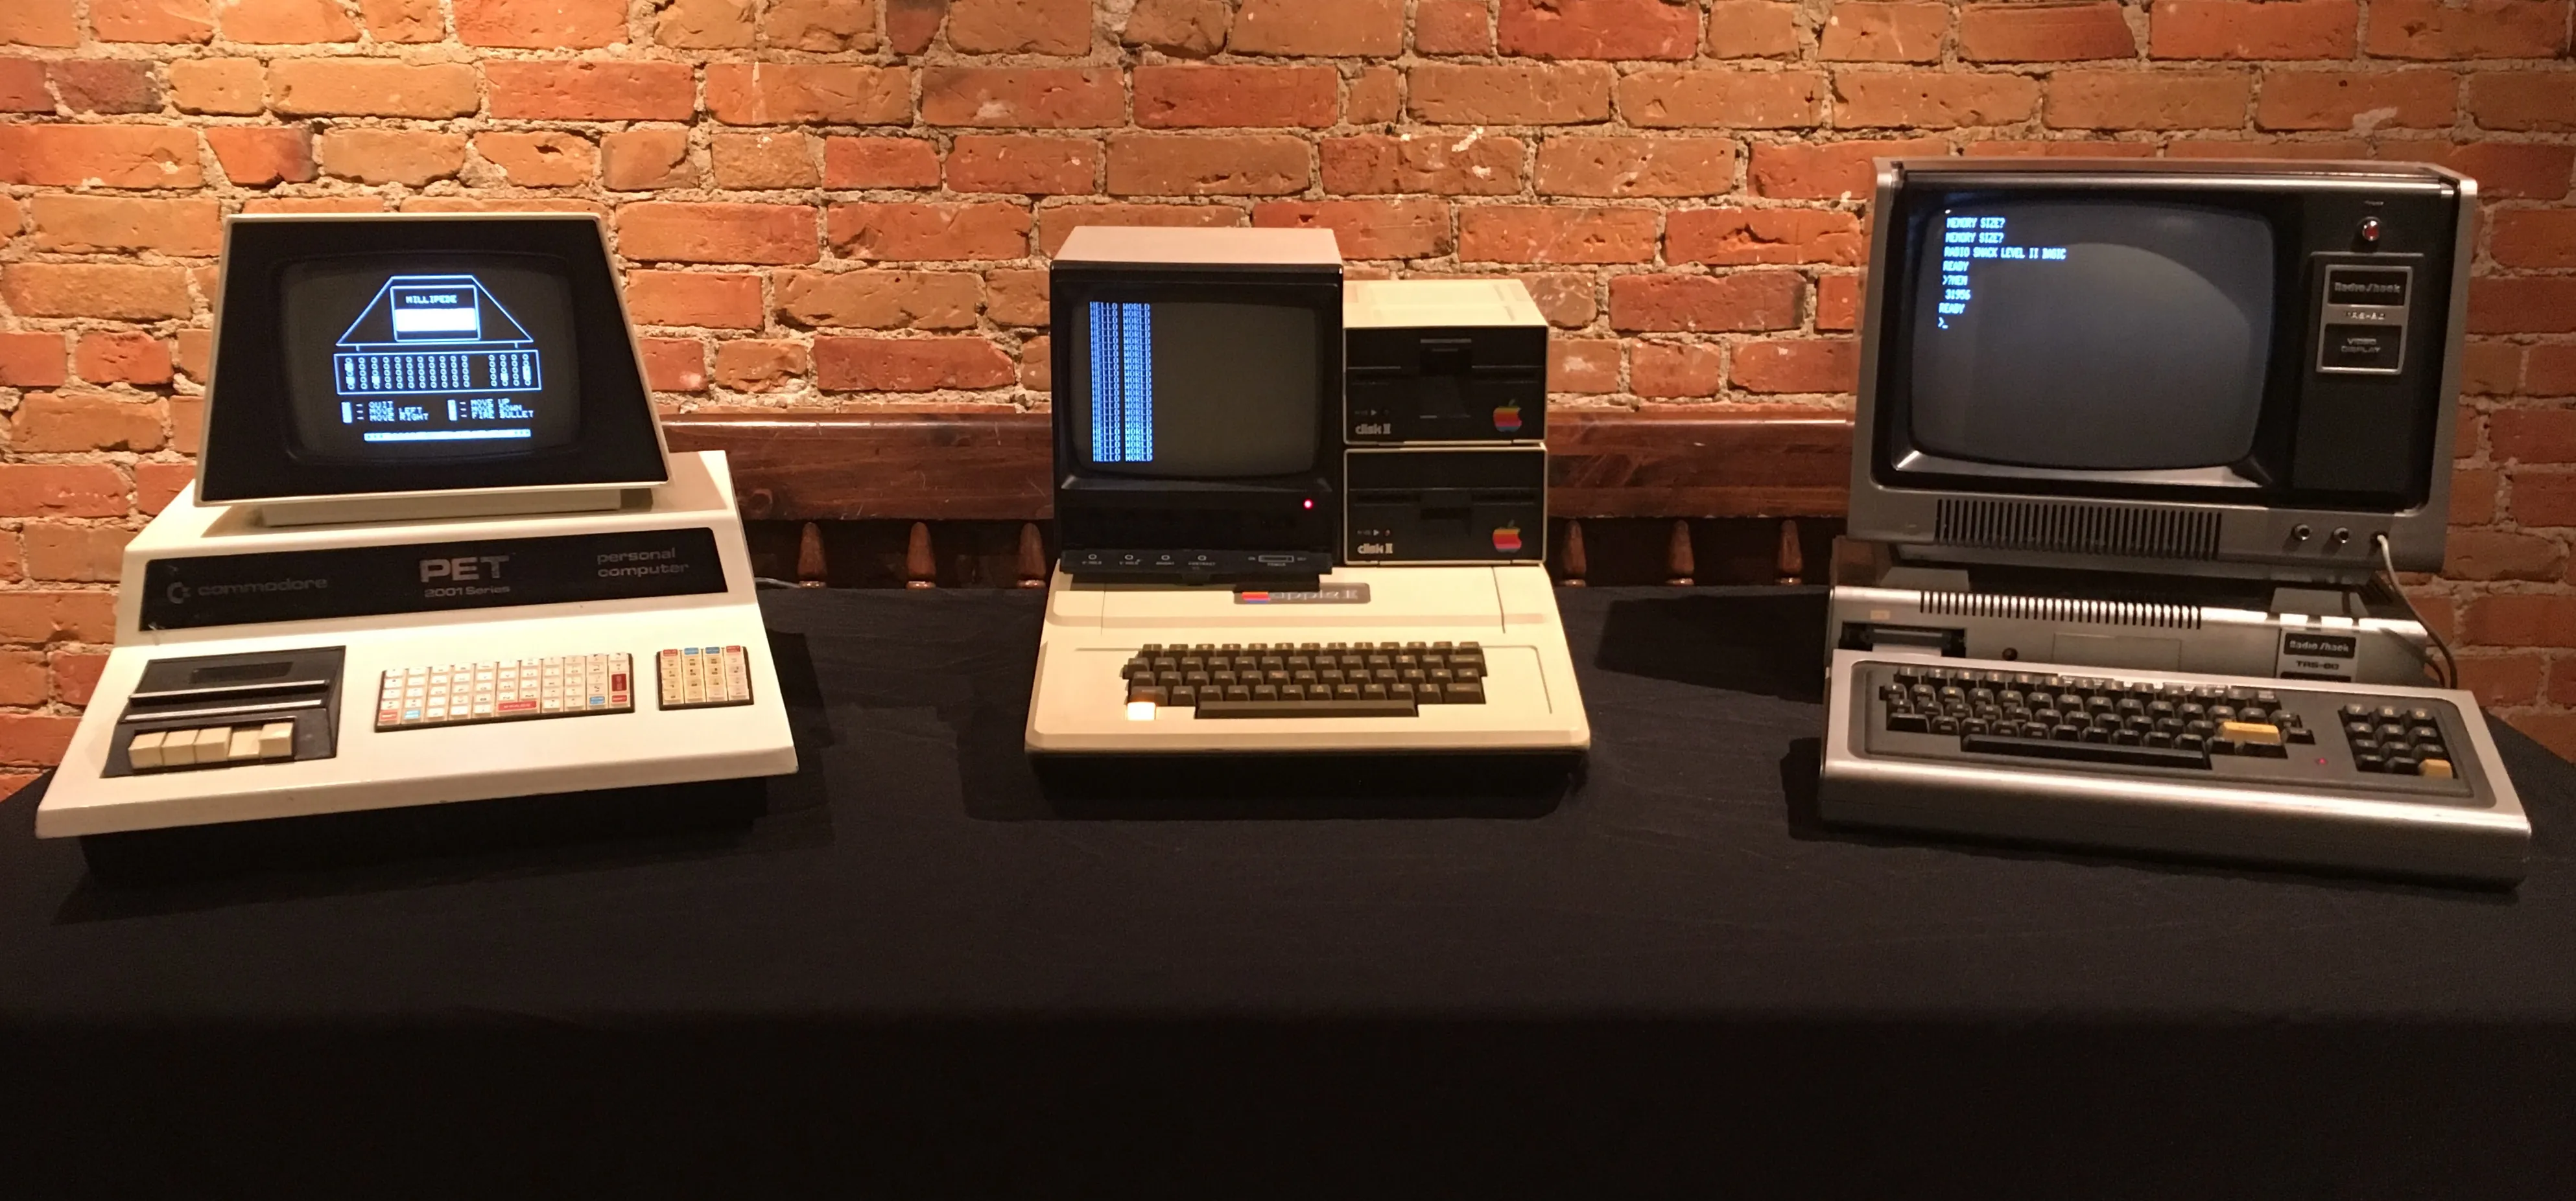
Ordenadores domésticos o personales de 1977: Commodore PET 2001, Apple II, TRS-80 Modelo I. Fueron denominados conjuntamente la ‘Trinidad de 1977’ por la revista Byte en la edición de septiembre de 1995. Fotografía cortesía de Timothy Colegrove, commons.wikimedia.org
Los primeros sistemas operativos de escritorio eran muy básicos.
Por ejemplo, los primeros sistemas operativos de escritorio no eran ni multiusuario ni multitarea, aunque esta característica ya existía en los sistemas de tiempo compartido de la época.
Además, un sistema diseñado para ser utilizado por un único usuario no tiene sentido implementar un sistema de archivos con permisos, por lo que los primeros sistemas operativos de escritorio también carecían de esta y otras características de seguridad que si eran comunes en sistemas corporativos.
Pese a estas diferencias, los sistemas operativos de escritorio se han beneficiado del desarrollo de los sistemas operativos para mainframes.
Los sistemas de escritorio actuales son multiusuario y multitarea; incluyen sistemas de archivos con permisos, autenticación y mecanismos de protección de la memoria —como medidas para proteger los datos de los usuarios— y han incorporado muchas otras características de los sistemas operativos para mainframe.
Aunque con el tiempo los sistemas de escritorio han ido adquiriendo características desarrolladas en los mainframes, no debemos olvidar que ambos tipos de sistemas se diseñan con objetivos diferentes.
Mientras que en los mainframes se persigue maximizar la fiabilidad y utilización eficiente de los recursos del hardware, en los sistemas de escritorio se suele maximizar la facilidad de uso y el tiempo de respuesta3 al usuario, al tiempo que se prioriza en menor medida el rendimiento.
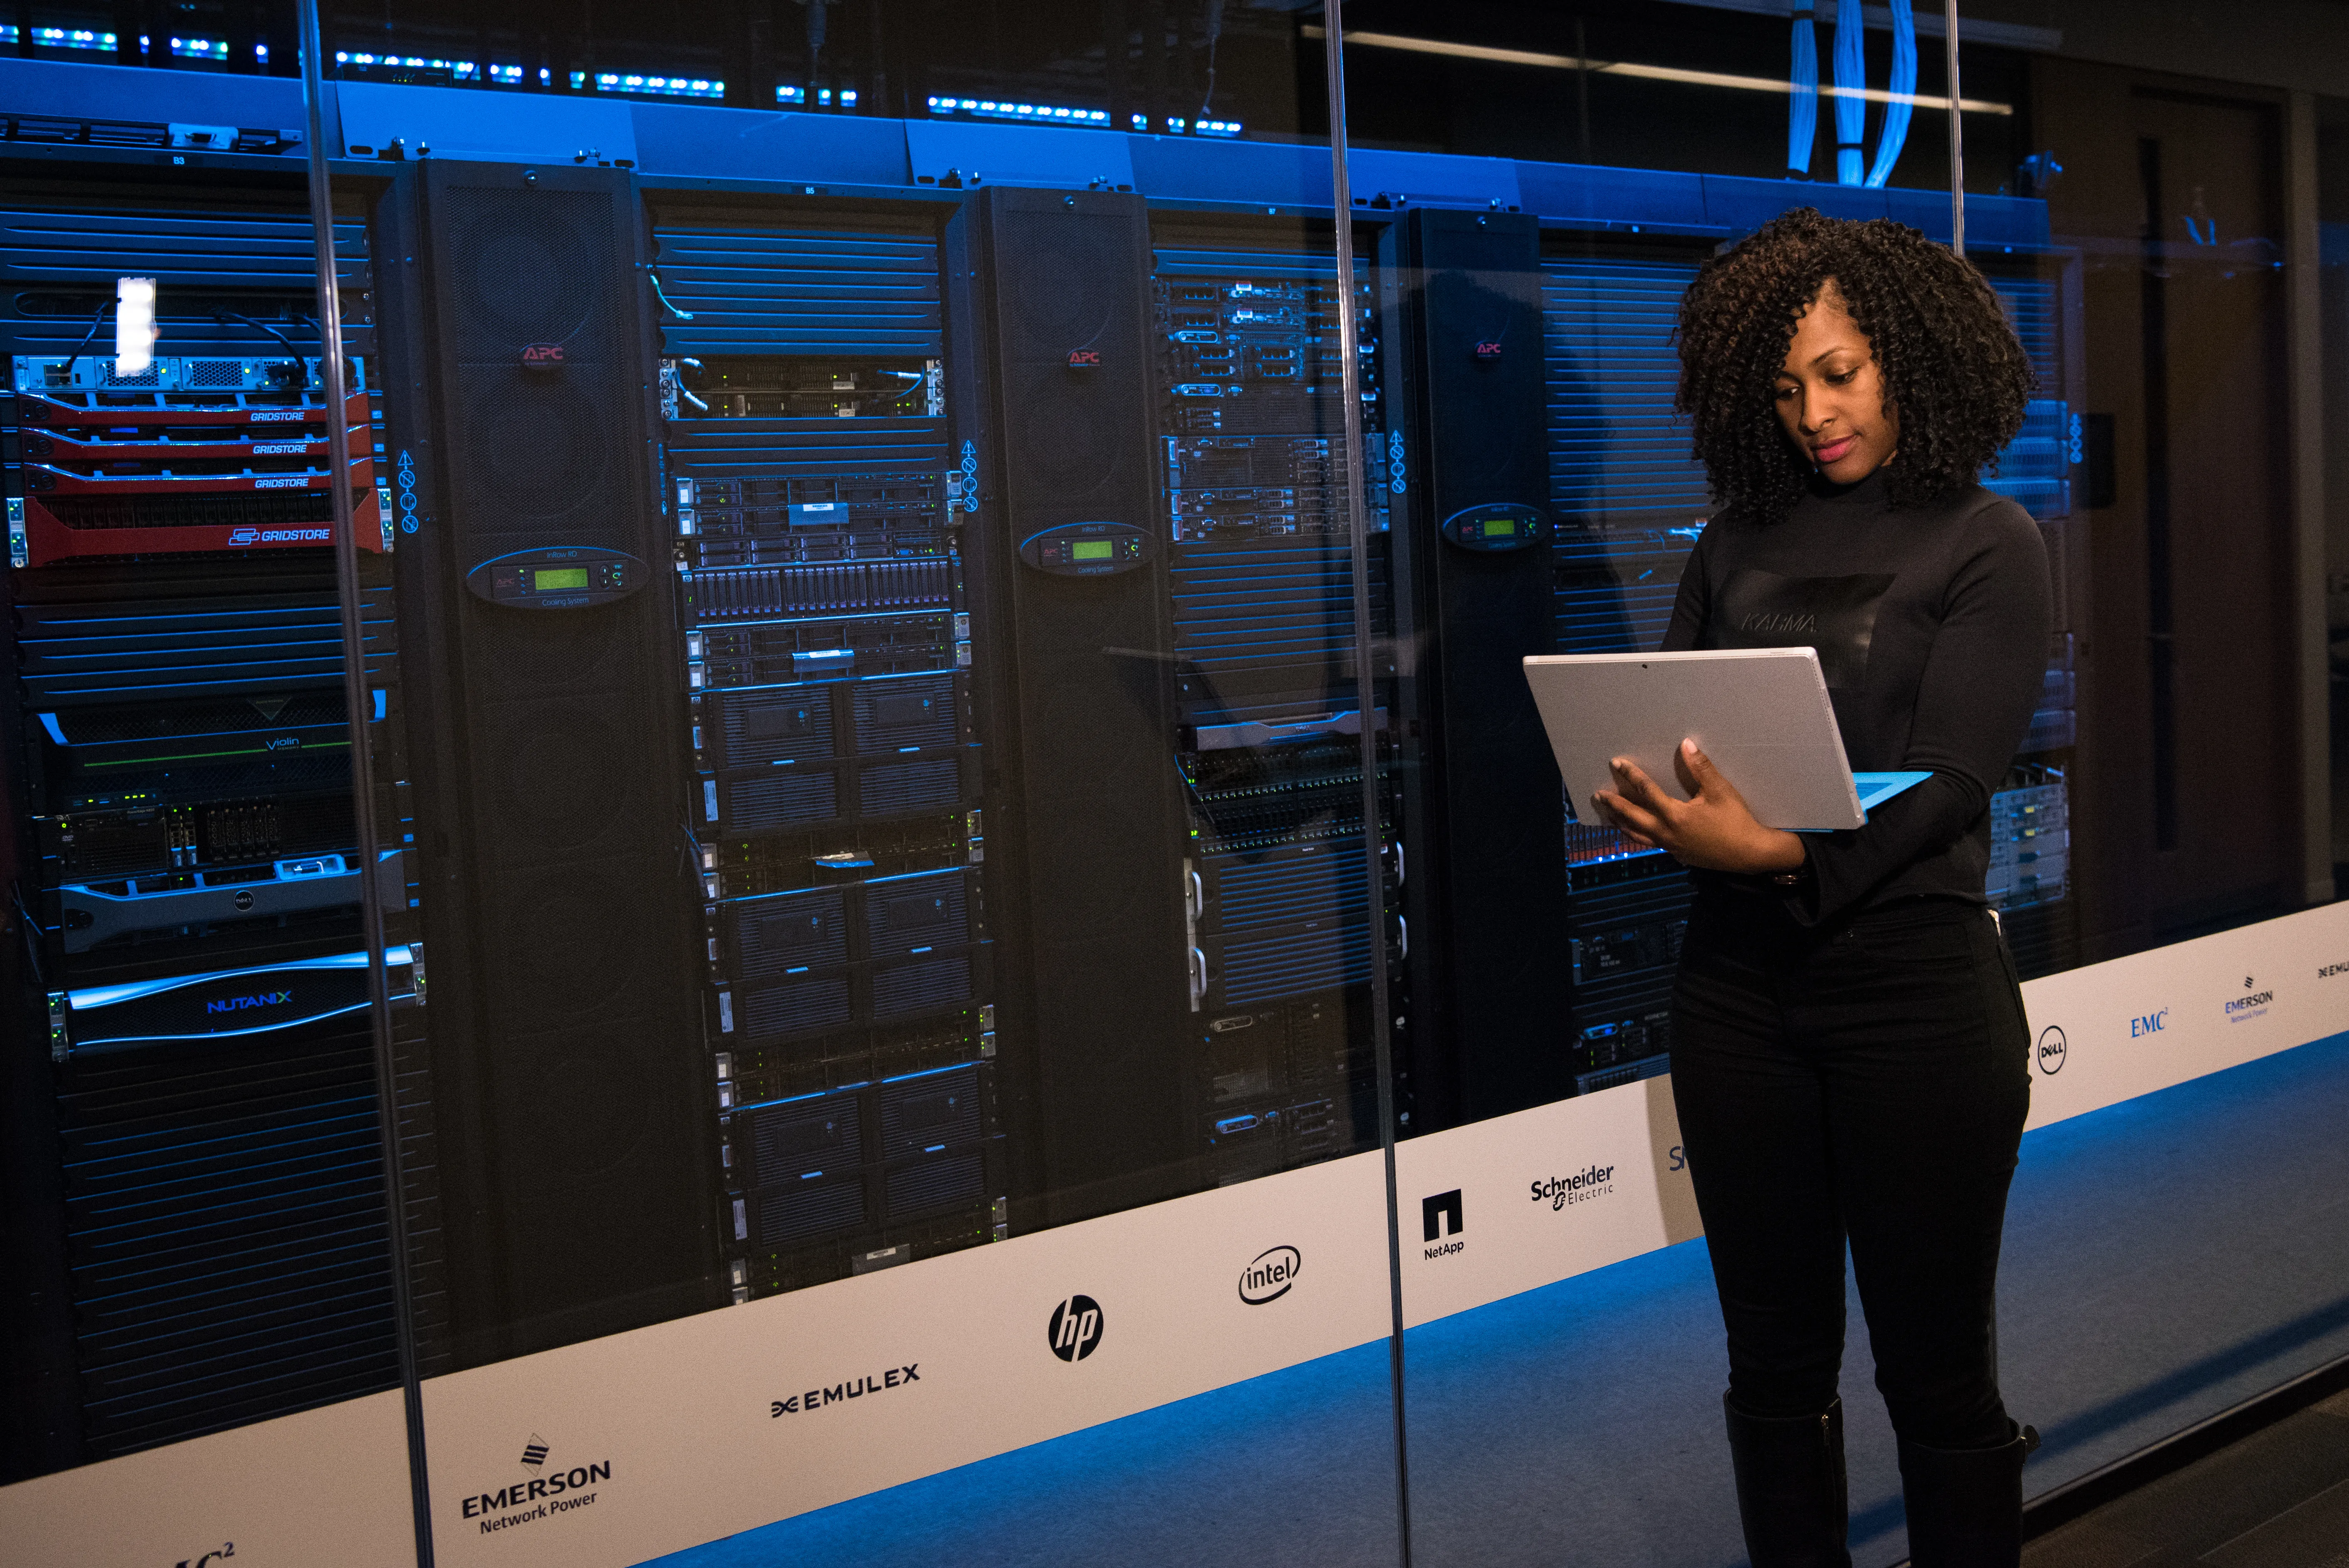
Los sistemas de escritorio han evolucionado desde los primeros ordenadores domésticos de finales de los años 70 hasta los actuales sistemas operativos de propósito general, que se utilizan en ordenadores de escritorio, portátiles, servidores y dispositivos móviles. Fotografía cortesía de Christina @ wocintechchat.com
Por todo ello, son muchos y muy diversos los ejemplos de sistemas operativos en esta categoría, pues van desde CP/M —lanzado en 1977— hasta los actuales GNU/Linux, Microsoft Windows y Apple macOS; pasando por MS-DOS (1981), IBM OS/2 (1987) y todas las versiones anteriores de Microsoft Windows y de Mac OS (ver el apartado «Quinta generación (desde 1980)».
Con el nombre genérico de sistemas de mano —del inglés handheld— hacemos referencia a las tablets, smartphones, lectores de libros electrónicos y otro sistemas móviles y portátiles.
Los desarrolladores de aplicaciones y sistemas de mano deben enfrentarse a diversos desafíos, originados por el tamaño limitado de los dispositivos y la alimentación mediante el uso de baterías.
Debido a esas limitaciones, muchos sistemas de mano tienen poca cantidad de memoria, procesadores lentos —en comparación con sus equivalentes de escritorio— y pantallas más pequeñas.
En el diseño del sistema operativo suele primar la facilidad de uso y buscar un buen equilibrio entre rendimiento y el tiempo de vida de la batería.
Resumen de diferencias en el diseño
En resumen, los sistemas de mainframe, de escritorio y de mano se diferencian principalmente en los objetivos de diseño que persiguen:
Los sistemas de mainframe buscan maximizar la fiabilidad y utilización eficiente de los recursos del hardware.
Los sistemas de escritorio buscan maximizar la facilidad de uso y el tiempo de respuesta al usuario, al tiempo que se prioriza en menor medida el rendimiento.
Los sistemas de mano buscan maximizar la facilidad de uso y el tiempo de vida de la batería, al tiempo que se prioriza en menor medida maximizar el rendimiento.
Pero en todos los casos, la función principal del sistema operativo es la misma: gestionar los recursos del sistema y controlar la ejecución de los programas.
Un sistema multiprocesador es aquel ordenador en el que hay procesadores interconectados que comparten el bus del sistema, el reloj y, en ocasiones la memoria, y los periféricos.
Hace años esto solo se daba en sistemas con varias CPU, lo que era relativamente común en servidores y sistemas de alto rendimiento para trabajos técnicos o científicos.
Sin embargo, en la actualidad cualquier dispositivo digital u ordenador doméstico puede tener una única CPU con múltiples núcleos, lo que los convierte en sistemas multiprocesador.
Las principales ventajas de estos sistemas son:
Aumentan la cantidad de trabajo realizado. A mayor número de procesadores, mayor cantidad de trabajo puede realizar el sistema.
Economía de escala. Un sistema multiprocesador puede costar menos que múltiples sistemas monoprocesadores conectados para hacer un trabajo equivalente, porque comparten periféricos, almacenamiento, alimentación, etc.
Alta disponibilidad. Con el hardware adecuado el sistema puede ser tolerante al fallo de uno de los procesadores.
En caso de fallo el sistema no se detendría, pero sí trabajaría más despacio.
En la actualidad existen dos tipos de sistemas multiprocesador:
En los sistemas de multiprocesamiento asimétrico o AMP (Asymmetric Multiprocessing) hay un procesador principal y varios secundarios a quienes el principal planifica y entrega las tareas que deben ejecutar.
En ocasiones los procesadores secundarios se distinguen del principal por haber sido diseñados para realizar algún tipo concreto de tareas de forma muy eficiente o por estar conectadas a hardware especial.
Ejemplo de moderno de este tipo de sistema multiprocesador son las GPU, que no son sino procesadores diseñados específicamente para el procesamiento de gráficos.
Mientras que antiguamente, para mejorar el rendimiento del acceso a los discos durso, en los equipos de gama alta a veces se instalaban tarjetas de E/S con CPU dedicadas. Estas se encargaban de gestionar las transferencias de datos con los discos duros conectados, evitando dedicar tiempo de la CPU principal a estas tareas.
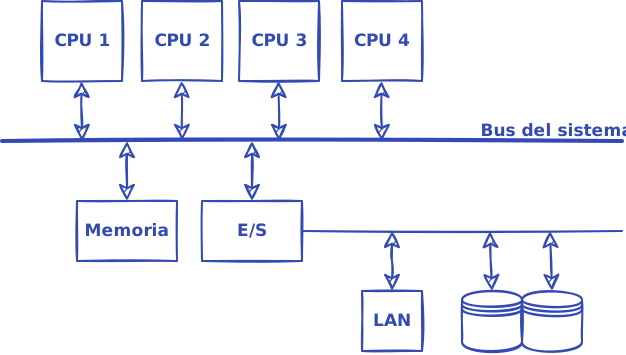
En los sistemas de multiprocesamiento simétrico o SMP (Symmetric Multiprocessing) todos los procesadores son iguales.
Todos comparten los mismos recursos, pueden acceder a los mismos dispositivos —como se ilustra en la siguiente figura— y cada uno ejecuta una copia del núcleo del sistema operativo.
Casi todos los sistemas multiprocesador modernos son de este tipo.
Obviamente, el sistema operativo debe haber sido diseñado para saber repartir el trabajo entre los procesadores y compartir adecuadamente entre tareas y procesadores el resto de recursos del sistema.
Arquitectura de un sistema de multiprocesamiento simétrico.
En la actualidad es común el uso de redes para interconectar ordenadores individuales —por ejemplo Internet o la red de área local de una oficina— cada uno equipado con su procesador, su memoria, sus dispositivos de almacenamiento, su fuente de alimentación, etc.
A diferencia de los sistemas multiprocesador, donde los procesadores comparten la memoria y los periféricos, en las redes de ordenadores los procesadores de los distintos ordenadores se comunican a través de líneas de comunicación, como: redes Ethernet, cables de fibra óptica o WiFi.
Estos sistemas son comúnmente denominados como sistemas distribuidos.
Sin entrar en detalles, los sistemas distribuidos pueden ser clasificados en sistemas cliente-servidor y sistemas de redes entre iguales.
En los sistemas cliente-servidor existen ordenadores que actúan como servidores encargados de satisfacer las peticiones generadas por otros ordenadores que actúan como clientes.
Este tipo de sistemas han sustituido, en la inmensa mayoría de casos, a los terminales conectados a mainframes, debido a que los sistemas de escritorio son cada vez más potentes y baratos, evolucionando hacia sistemas de propósito general que pueden ser utilizados como clientes y servidores al mismo tiempo.
Concretamente:
Los terminales han sido sustituidos por sistemas de escritorio que, al disponer de más recursos de hardware propios, son capaces de realizar muchas de las funcionalidades que anteriormente eran manejadas directamente por los mainframes.
Los mainframes se han reemplazado por servidores, sistemas de propósito general preparados para atender las peticiones de sus clientes, no muy diferentes a los sistemas de escritorio que actúan como clientes, pero con más recursos de hardware y software para poder atender a muchos clientes al mismo tiempo.
Ejemplos de este tipo de sistemas son los servidores de base de datos, que responden a las consultas SQL de los clientes; los servidores de archivos, que proporcionan una interfaz de sistema de archivos con la que los clientes pueden crear, leer, escribir y borrar archivos en el servidor, de forma similar a como si estuvieran almacenados localmente en el propio cliente; o los servidores web, que proporcionan páginas web a los clientes que las solicitan a través de un navegador web.
En los sistemas de redes entre iguales o P2P (peer-to-peer) clientes y servidores no se distinguen los unos de los otros.
Todos los nodos del sistema son iguales y cada uno puede actuar como cliente o servidor, dependiendo de cuándo piden o proporcionan un servicio.
La principal limitación de este tipo de sistemas es que el servidor puede convertirse en el cuello de botella del rendimiento, no solo por su potencia, sino fundamentalmente por el ancho de banda4 de su conexión a la red.
A fin de cuentas, la potencia del servidor es lo de menos cuando se intenta distribuir en Internet archivos de gran tamaño —por ejemplo imágenes de DVD o archivos de vídeo de películas— pues el principal problema es que varias descargas simultáneas pueden consumir el ancho de banda del servidor durante largos periodos de tiempo.
Sin embargo, en los sistemas P2P la carga se distribuye entre todos los nodos de la red.
Este es el motivo por el que estas redes son tan populares para compartir archivos de gran tamaño.
Los sistemas en clúster son un tipo de sistemas distribuidos donde varios ordenadores individuales comparten almacenamiento y se interconectan en una red local para ofrecer un servicio de forma conjunta.
De esta manera, sistemas con hardware convencional, como el de los ordenadores personales, pueden ser utilizados para ofrecer servicios de alto rendimiento y alta disponibilidad, que antes solo podían ser ofrecidos por mainframes.
Por lo general, todos los nodos del clúster se utilizan para dar un mismo servicio.
Un nodo especial, denominado balanceador de carga, tiene la responsabilidad de repartir el trabajo entre el resto de nodos del sistema, que se destinan a ejecutar los programas y dar el servicio solicitado por los clientes.
Los sistemas en clúster se utilizan principalmente para dos propósitos:
Servicios escalables y en alta disponibilidad.
Al disponer de varios nodos que atienden solicitudes, el sistema puede atender a un mayor número de clientes simultáneamente, aumentando la escalabilidad del servicio.
Si los nodos se monitorizan entre sí, de forma que pueden sustituirse unos a otros en caso de fallo, el sistema puede tolerar fallos de uno o varios nodos, aumentando la disponibilidad del servicio.
Este tipo de sistemas son muy utilizados en servidores de Internet —como servidores web, correo electrónico o de mensajería instantánea— o servidores de base de datos, que deben dar servicio a una gran cantidad de clientes simultáneamente.
Computación de alto rendimiento o HPC.
Es un tipo de sistemas en clúster que se utiliza para realizar trabajos de cálculo muy complejos y pesados, como simulaciones —por ejemplo, meteorológica o de partículas—, ejecutar algoritmos de inteligencia artificial o romper sistemas de cifrado.
Por eso también se los conoce como superordenadores.
En este tipo de sistemas el objetivo es maximizar el rendimiento del sistema, no la disponibilidad del servicio, por lo que se utilizan ordenadores con procesadores muy potentes y de alto rendimiento, interconectados mediante redes de alta velocidad y baja latencia.
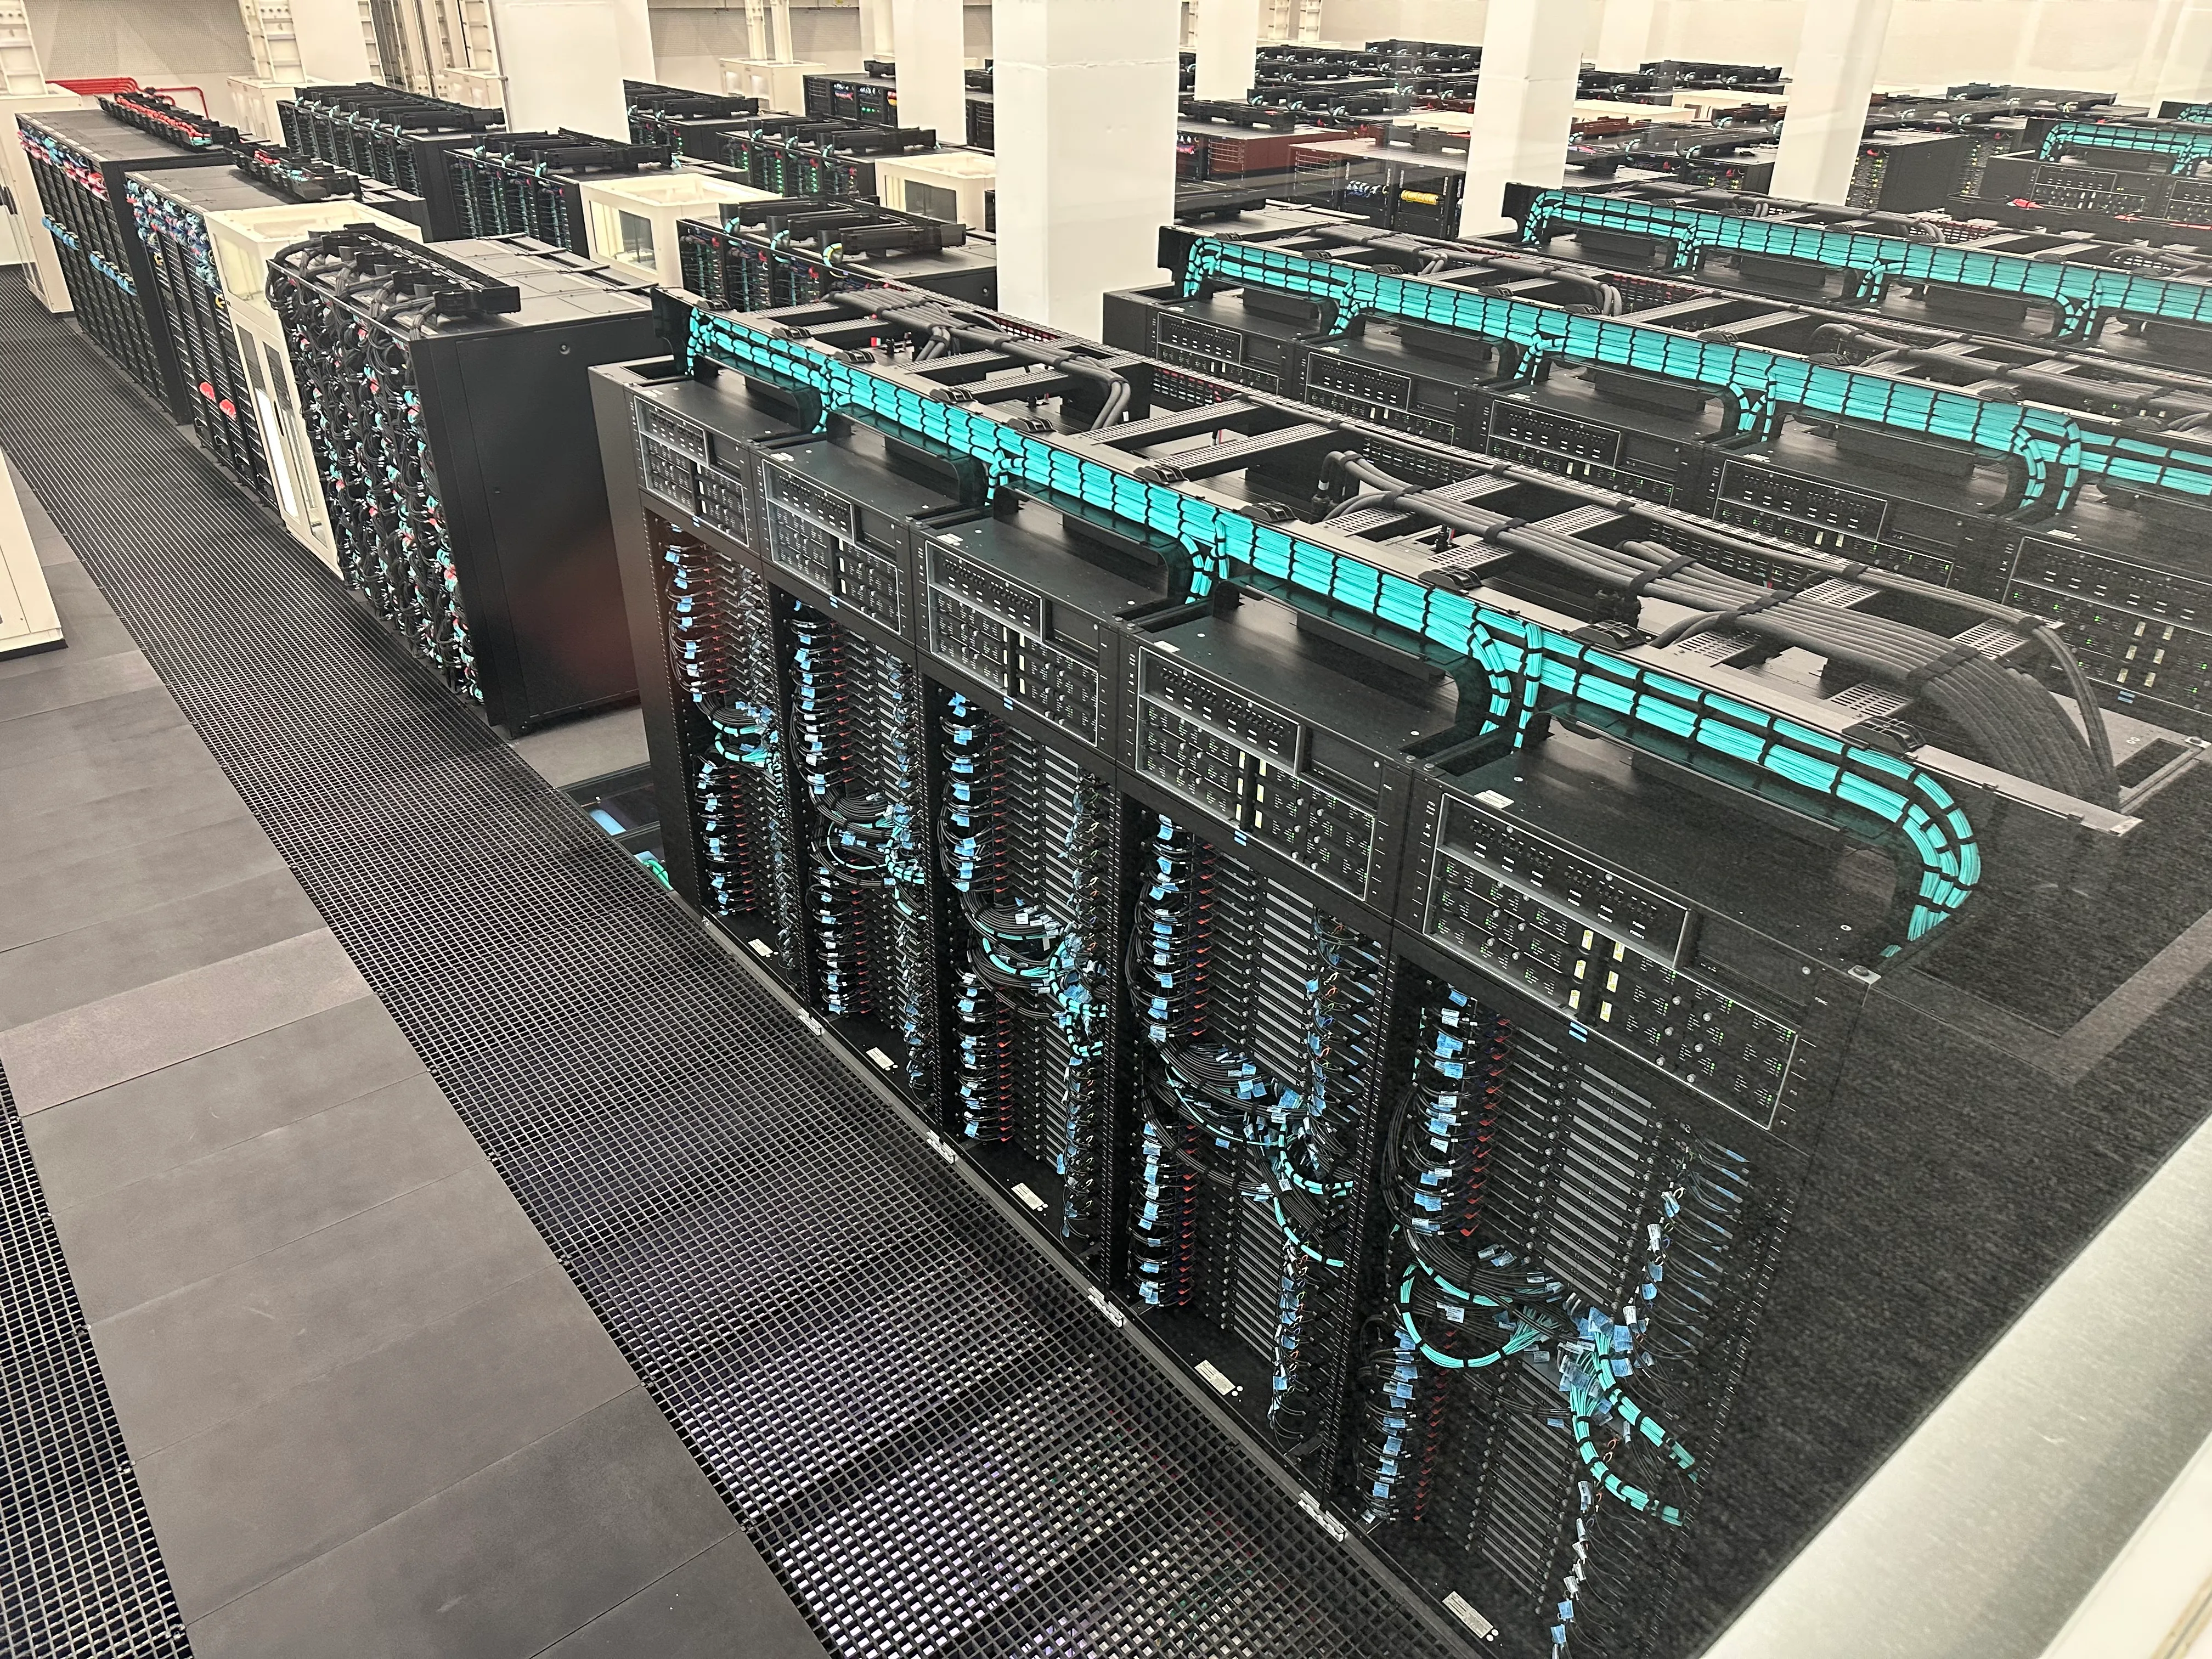
MareNostrum 5 instalado en el Centro de Supercomputación de Barcelona (BSC). Este superodenador está en el TOP500 de supercomputadores más potentes del mundo, con una potencia de 314 PFLOPS. Fotografía cortesía de Steve Jurvetson, flickr.com/photos/jurvetson
Para que los sistemas distribuidos funcionen correctamente, los ordenadores que los componen deben estar equipados con un sistema operativo que ofrezca a las aplicaciones que corren sobre ellos servicios de acceso a la red y mecanismos de comunicación entre los distintos ordenadores de la red.
Hoy en día, la inmensa mayoría de los sistemas operativos incorporan estos servicios y mecanismos, permitiendo a los programas que se ejecutan en un ordenador enviar y recibir mensajes a otros programas y servicios que se ejecutan en otros ordenadores de la red.
A su vez, suelen incorporar la opción de usar o proporcionar algunos servicios de red, como la compartición de archivos, impresoras y otros dispositivos con otros equipos de la misma red.
Sin embargo, en los años 80 y principios de los 90 del siglo pasado, no todos los sistemas operativos ofrecían acceso a la red.
A los sistemas operativos que sí lo hacían se les denominaba sistemas operativos de red.
En particular, a los sistemas operativos para sistemas distribuidos se clasificaban en:
Los sistemas operativos de red, que eran aquellos que, como la inmensa mayoría de los sistemas operativos actuales, ofrecían servicios de acceso a redes de ordenadores.
Los ordenadores con sistemas operativos de red son autónomos, es decir, pueden funcionar sin estar conectados a la red y gracias al sistema operativo de red, conocen la existencia de la red y saben usarla para comunicarse con otros ordenadores de la misma.
Los sistemas operativos distribuidos crean en el usuario la ilusión de que está en una única máquina local, aunque en realidad el sistema operativo controla todos los ordenadores de la red, dando al usuario acceso transparente a los recursos en todos los equipos de la misma.
Es decir, con este tipo de sistemas operativos el usuario no sabe en qué ordenador se ejecutan sus procesos, donde se almacenan sus archivos, ni qué equipo tiene conectado los distintos periféricos a los que tiene acceso.
Los sistemas operativos distribuidos son mucho más complejos que los sistemas operativos de red, ya que deben coordinar la ejecución de los procesos y el acceso a los recursos entre todos los ordenadores de la red, como si fueran un único sistema.
Sin embargo, nunca han sido muy populares, ya que los sistemas operativos de red son mucho más fáciles de implementar y mantener, y en la práctica son suficientes para la mayoría de los casos de uso.
Entre los pocos ejemplos de sistemas operativos distribuidos que han existido, podemos citar a Amoeba, un sistema operativo distribuido de investigación escrito por Andrew S. Tanenbaum en la Universidad de Vrije.
Los sistemas de tiempo real se utilizan cuando existen requerimientos estrictos de tiempo en la ejecución de ciertas tareas o en el procesamiento de flujos de datos.
Se usan frecuentemente en dispositivos de control donde, por ejemplo, dentro de unos márgenes estrictos de tiempo, se deben tomar datos de uno o varios sensores para posteriormente analizarlos y actualizar de alguna forma un mecanismo de control.
Por ejemplo, se suelen utilizar en sistemas de control industrial, domótica, armamento, automoción —en la inyección electrónica de combustible, sistemas de frenado y de control de tracción— o en dispositivos médicos.
Los sistemas de tiempo real están muy relacionados con los sistemas empotrados.
Los sistemas empotrados:
Se diseñan para realizar tareas muy específicas.
No son sistemas de propósito general sino de propósito específico.
Sus sistemas operativos suelen tener características muy limitadas y no tienen que tener necesariamente una interfaz de usuario.
Estos sistemas están tanto en el motor de los automóviles y los robots que los fabrican, como en reproductores de DVD, microondas, TV inteligentes o dispositivos de red.
Los sistemas de tiempo real pueden ser clasificados en:
Los sistemas de tiempo real estricto o hard real-time se utilizan cuando es necesario garantizar que las tareas serán realizadas dentro de unos márgenes estrictos de tiempo.
Para ello, todas las situaciones imprevistas que puedan ocasionar retrasos en el funcionamiento del sistema operativo deben estar perfectamente delimitadas en tiempo.
Por lo tanto, suelen carecer de memoria virtual y de otras abstracciones que aíslen al desarrollador del funcionamiento real del hardware, ya que introducen impredecibilidad.
Los sistemas de tiempo real estricto no son compatibles con los sistemas operativos de propósito general.
Los sistemas de tiempo real flexible o soft real-time son útiles cuando en un sistema operativo de propósito general hay tareas que tienen mayor importancia que el resto, por lo que deben ser realizadas con mayor prioridad.
El tiempo real flexible no sirve cuando se tienen tareas con limitaciones precisas de tiempo, porque no incluye mecanismos para garantizar que dichas restricciones se vayan a cumplir.
Sin embargo sí es útil para tareas relacionadas con la multimedia, la realidad virtual, los videojuegos, etc. y es compatible con la memoria virtual y otras características presentes en los sistemas de propósito general.
Por eso la mayor parte de los sistemas de escritorio actuales soportan tareas de tiempo real flexible.
El tiempo de respuesta es el tiempo que transcurre entre que un usuario realiza una acción y el sistema responde a dicha acción.
Para más información, ver la @sec-criterios-planificacion. ↩
El ancho de banda es la cantidad de información que puede ser transmitida a través de un canal de comunicación en un tiempo determinado.
Por ejemplo, si nuestra conexión a Internet tiene un ancho de banda de 1 Gbps, significa que como máximo podemos transmitir 125 megabytes por segundo. ↩