
11. Comunicación mediante paso de mensajes
Cómo los procesos cooperativos intercambian información mediante paso de mensajes: características y su implementación en colas de mensajes POSIX, tuberías y sockets.
Procesos cooperativos
Sección titulada «Procesos cooperativos»Cuando varios procesos se ejecutan en un sistema, a menudo necesitan intercambiar información entre ellos o coordinar sus acciones para completar una tarea conjunta. Esta necesidad de comunicación es la que motiva distinguir entre dos tipos de procesos según su grado de interacción:
-
Los procesos independientes, que no afectan o pueden ser afectados por otros procesos del sistema. Cualquier proceso que no comparte datos —temporales o persistentes— con otros procesos es independiente.
-
Los procesos cooperativos, que pueden afectar o ser afectados por otros procesos ejecutados en el sistema. Los procesos que comparten datos, sea cual sea la forma en la que lo hacen —archivos, memoria compartida, mecanismos de comunicación, etc.—, siempre son cooperativos.
Motivaciones para la colaboración entre procesos
Sección titulada «Motivaciones para la colaboración entre procesos»Hay diversos motivos para proporcionar un entorno que permita la cooperación de los procesos:
-
Compartición de información. Dado que varios usuarios pueden estar interesados en los mismos bloques de información —por ejemplo, en un archivo compartido— el sistema operativo debe proporcionar un entorno que permita el acceso concurrente a este tipo de recursos.
-
Velocidad de cómputo. Para que una tarea se ejecute más rápido se puede partir en subtareas que se ejecuten en paralelo. Es importante destacar que la mejora en la velocidad solo es posible si el sistema tiene varios componentes de procesamiento como procesadores —si se quiere acelerar la ejecución en la CPU— o canales E/S —si se quieren acelerar las operaciones de E/S—.
-
Modularidad. Podemos querer crear nuestro software de forma modular, dividiendo las funciones del programa en procesos separados que se comunican entre sí.
-
Conveniencia. Incluso un usuario individual puede querer hacer varias tareas al mismo tiempo. Por ejemplo, editar, imprimir y compilar al mismo tiempo.
La ejecución simultánea de procesos cooperativos requiere mecanismos tanto para comunicar unos con otros como para sincronizar sus acciones (ver el capítulo «Sincronización»).
Tipos de comunicación entre procesos
Sección titulada «Tipos de comunicación entre procesos»Para comunicar procesos cooperativos existen diversas aproximaciones, que en general se pueden encajar en alguna de las siguientes estrategias:
-
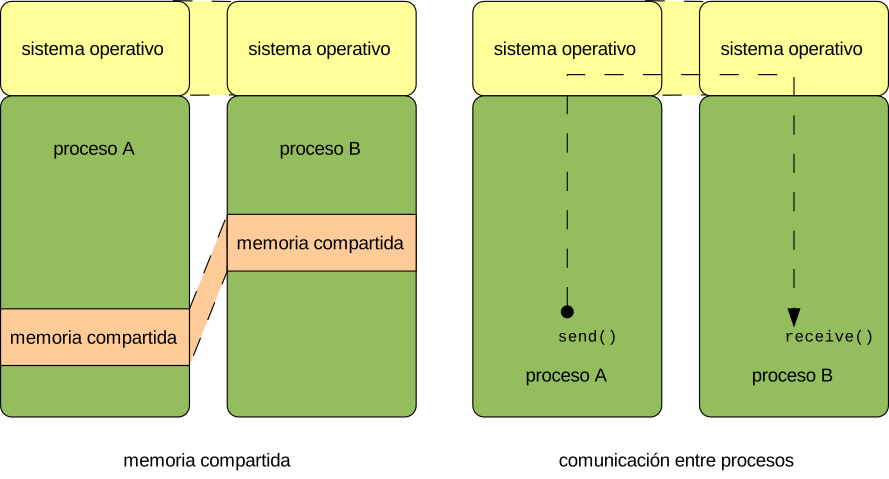
Memoria compartida. Método de comunicación en el que los procesos utilizan regiones compartidas de la memoria principal para compartir información.
-
Paso de mensajes. Método en el que los procesos utilizan funciones del sistema operativo para enviarse mensajes entre ellos, compartiendo información y sincronizando acciones, sin necesidad de compartir memoria.
Veremos cada una en detalle en el capítulo «Memoria compartida» y en este mismo capítulo, respectivamente.
Propiedades del paso de mensajes
Sección titulada «Propiedades del paso de mensajes»El paso de mensajes es un mecanismo que permite a los procesos compartir información y sincronizar sus acciones sin necesidad de compartir recursos —compartir memoria, archivos, etc.—
Esto lo hace especialmente útil en entornos distribuidos, donde los procesos a comunicar residen en ordenadores diferentes conectados a una red, por lo que tiene muy difícil —o incluso imposible— compartir memoria u otros recursos para comunicarse. En este caso, el sistema operativo es el encargado de codificar los mensajes y enviarlos a través de la red para hacerlos llegar a su destinatario. La web —donde un navegador se conecta a un servidor web para obtener contenido— y el resto de servicios de Internet son ejemplos de sistemas de paso de mensajes.
El sistema de paso de mensajes debe ser proporcionado por el sistema operativo que, a diferencia de cuando se usa memoria compartida, se encarga de la sincronización —ya que no existen riesgos en el envío y recepción de mensajes al mismo tiempo— y de establecer el formato que deben tener los datos del mensaje.
Los sistemas de paso de mensaje de cualquier sistema operativo debe proporcionar al menos dos funciones similares a las siguientes:
- send( message ) para mandar mensajes a otro proceso.
- receive( &message ) para recibir mensajes de otro proceso y copiarlo en message.
Para que estas llamadas puedan enviar y recibir mensajes entre dos procesos es necesario que haya un enlace de comunicaciones entre ambos. No trataremos aquí la implementación física del enlace —que por ejemplo puede ser mediante memoria compartida, un bus hardware o una red de ordenadores— sino de su implementación lógica, es decir, las características de la interfaz que usan las aplicaciones para comunicarse con sus correspondientes operaciones de envío y recepción.
Tamaño del mensaje
Sección titulada «Tamaño del mensaje»Los diseñadores del sistema operativo deben escoger entre implementar un sistema de paso de mensajes con mensajes de tamaño fijo o mensajes de tamaño variable:
-
Mensajes de tamaño fijo. La implementación del sistema operativo es muy sencilla, pero el uso de la interfaz por parte de las aplicaciones es mucho más compleja.
Por ejemplo, para comunicar procesos en un mismo ordenador cada enlace puede tener un búfer de tamaño fijo donde se copia el mensaje enviado y de donde se extrae el mensaje al recibirlo. Esto es muy sencillo de implementar en el sistema operativo. Sin embargo, si el desarrollador de la aplicación quiere enviar algo de mayor tamaño que el tamaño del mensaje, debe trocearlo en varios mensajes para enviarlo y reconstruirlo al recibirlo.
-
Mensajes de tamaño variable. La implementación del sistema operativo es más compleja, ya que ahora tiene que gestionar la memoria para almacenar mensajes de tamaño variable hasta que son recibidos. Sin embargo, la programación de aplicaciones es más simple, puesto que el programador puede mandar mensajes de cualquier tamaño sin ninguna preocupación
Comunicación orientada a flujos
Sección titulada «Comunicación orientada a flujos»La comunicación orientada a flujos o streams es un tipo de comunicación con mensajes de tamaño variable donde no se preserva la separación entre mensajes al recibirlos. Es decir, que cuando los procesos leen un número arbitrario de bytes, en ellos puede haber parte de un mensaje o varios mensajes al mismo tiempo. Por ejemplo, en esos sistemas el transmisor puede mandar tres mensajes de 16000, 3200 y 100 bytes, pero el receptor leer la secuencia de bytes en bloques de 512 bytes.
Si usamos este tipo de sistema pero para nuestro caso de uso es importante conservar la separación entre los mensajes recibidos, será nuestra responsabilidad escoger un formato de mensaje adecuado que permita al receptor recuperar dónde comienza y termina un mensaje dentro de la secuencia de bytes.
Referenciación
Sección titulada «Referenciación»Los procesos que se quieran comunicar deben tener una forma de señalarse el uno al otro. Para ello el diseñador del sistema puede elegir que el sistema de paso de mensajes sea con comunicación directa o indirecta.
Comunicación directa
Sección titulada «Comunicación directa»En la comunicación directa cada proceso debe nombrar explícitamente al proceso destinatario o receptor de la información —por ejemplo, a través de su PID—. Si tanto el proceso transmisor como el receptor se nombran entre sí, se dice que es comunicación directa con direccionamiento simétrico:
- send( A, message ) para mandar un mensaje al proceso identificado como «A».
- receive( A, &message ) para recibir un mensaje del proceso identificado como «A», copiándolo en «message».
Si, por el contrario, el proceso receptor no tiene que nombrar al proceso transmisor, sino que puede recibir mensajes de cualquier proceso y es el sistema operativo el que se encarga de identificar al remitente del mensaje recibido, se dice que se trata de comunicación directa con direccionamiento asimétrico:
- send( A, message ) para mandar un mensaje al proceso identificado como «A»
- receive( &pid, &message ) para recibir un mensaje de cualquier proceso, recibiendo en «message» una copia del message y en «pid» la identidad del remitente.
Un enlace de comunicaciones que respalde un sistema con comunicación directa debe tener las siguientes características:
-
Un enlace se establece automáticamente entre cada par de procesos cuando quieren comunicarse. Por tanto, los procesos solo necesitan conocer la identidad de los otros para comunicarse.
-
Cada enlace se asocia exactamente a dos procesos.
-
Entre cada par de procesos solo hay un enlace.
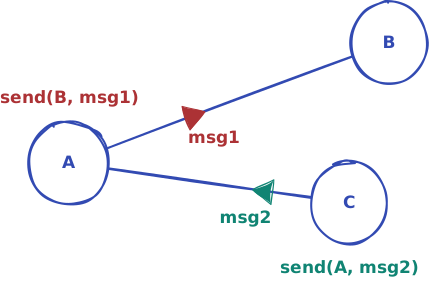
La principal desventaja de este tipo de comunicación es que si cambia el identificador de un proceso hay que actualizar todas las referencias en todos los procesos que se comunican con él. En general cualquier técnica que requiera que los identificadores de los procesos sean establecidos explícitamente en el código de los programas no es deseable, puesto que en la mayoría de los sistemas los identificadores de los procesos cambian de una ejecución a otra. Por lo tanto, lo mejor sería disponer de una solución con un nivel adicional de indirección que evite que los procesos usen sus identificadores para comunicarse.
Ejemplo Colas de mensajes en Windows API
Sección titulada « Colas de mensajes en Windows API»En Windows API un hilo puede comunicarse con otro hilo usando PostThreadMessage() con el identificador del hilo destinatario y el mensaje.
BOOL PostThreadMessage(
    DWORD  idThread,
    UINT   Msg,
    WPARAM wParam,    LPARAM lParam);
Como se puede observar, en las colas de mensajes de Windows API el tamaño del mensaje es fijo y con una estructura muy bien definida: un identificador del mensaje y dos enteros que sirven de parámetros opcionales del mensaje.
Para recibir el mensaje el proceso llama a GetMessage() que recibe un puntero a una estructura MSG donde se devuelve el identificador del mensaje recibido y sus parámetros:
BOOL GetMessage(
    LPMSG lpMsg,    HWND  hWnd,    UINT  wMsgFilterMin,    UINT  wMsgFilterMax);
Como se puede observar, no se indica de qué hilo o proceso se quiere recibir el mensaje, por lo que se trata de un caso de comunicación directa asimétrica.
De hecho, si se quiere conocer la identidad del remitente, este tendría que poner su identificador en alguno de los parámetros del mensaje —wParam o lParam—, porque el sistema no proporciona esa información.
El sistema de colas de mensajes de Windows API es una pieza fundamental del entorno gráfico de Microsoft Windows.
Con ese fin, el sistema trae un conjunto de mensajes predefinidos, cada uno con un identificador entero único, pero podemos definir nuestros propios mensajes para comunicar unos hilos o procesos con otros.
Por ejemplo, WM_PAINT es un mensaje predefinido que indica que una ventana necesita ser repintada, mientras que WM_QUIT es un mensaje que indica que la aplicación debe terminar.
Comunicación indirecta
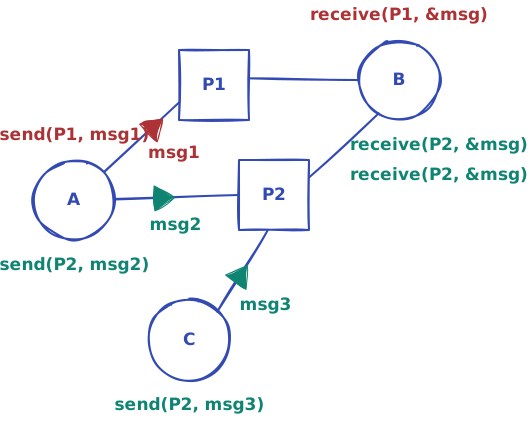
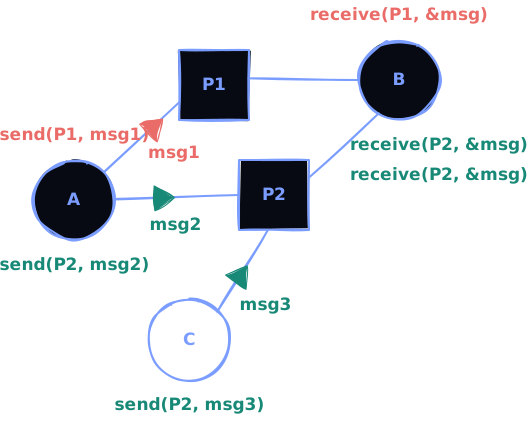
Sección titulada «Comunicación indirecta»En la comunicación indirecta los mensajes son enviados a objetos donde los procesos pueden dejar y recoger mensajes, denominados buzones, mailbox o puertos.
- send( P, message ) para mandar un mensaje al puerto «P»
- receive( P, &message ) para recibir un mensaje del puerto «P».
Un enlace de comunicaciones según este esquema tiene las siguientes características:
- Un enlace se establece entre un par de procesos solo si ambos comparten un mismo puerto, dado que cada enlace corresponde con un puerto.
- Un enlace puede estar asociado a más de dos procesos, puesto que múltiples procesos pueden compartir el mismo puerto.
- Entre cada par de procesos en comunicación puede haber varios enlaces, cada uno de los cuales corresponde a un puerto diferente.
Ejemplo Colas de mensajes en sistemas POSIX
Sección titulada « Colas de mensajes en sistemas POSIX»El estándar POSIX también define un sistema de colas de, pero es bastante diferente a la solución en Windows API ya que fue diseñado para ser más versátil.
Para usarlo, lo primero es abrir o crear —si aún no existe— la cola de mensajes llamando a mq_open(). Como con los archivos y otros recursos, para que varios procesos puedan acceder a la misma cola y comunicarse deben indicar el mismo nombre.
mqd_t mqueue = mq_open(
    "/foo-mqueue",
    O_CREAT | O_RDWR,
    0644,    NULL);
La cola es el objeto que permite a los procesos comunicarse entre sí, ya que permite que varios procesos puedan enviar y recibir mensajes a través de ella. El valor devuelto por mq_open() es el descriptor de la cola de mensajes y se utiliza como primer argumento en operaciones posteriores para indicar sobre qué cola queremos actuar. Como otros descriptores, se hereda de padres a hijos al usar fork().
Para enviar un mensaje se utiliza mq_send(). Los mensajes con mayor prioridad se entregarán antes.
struct MyTestMessage message = {  // Inicialización de los campos del mensaje};
int mq_send(
    mqueue,
    (const char*)&message,
    sizeof(message),
    0);
Mientras que para recibir un mensaje se utiliza mq_receive().
struct MyTestMessage message;unsigned int msg_prio;
int mq_receive(
    mqueue,
    (char*)&message,
    sizeof(message),
    &msg_prio);
Como los mensajes no se dirigen directamente a los procesos, sino a estas entidades llamadas colas de mensajes, se trata de un caso de comunicación indirecta. Además, el tamaño de los mensajes es variable, aunque limitado por defecto a 8 KiB, si no se configura de otra manera. Si varios procesos intentan recibir de una misma cola de mensajes al mismo tiempo, queda en manos del sistema operativo decidir cuál recibirá el siguiente mensaje que llegue. Por lo general lo recibe el primero en ser escogido por el planificador de la CPU para seguir ejecutándose.
Recepción concurrente
Sección titulada «Recepción concurrente»La comunicación indirecta da lugar a algunas situaciones que deben ser resueltas durante el diseño.
Por ejemplo, ¿qué ocurre si los procesos A, B y C comparten el puerto P1; A manda un mensaje y B y C invocan receive() en el puerto P1 al mismo tiempo?
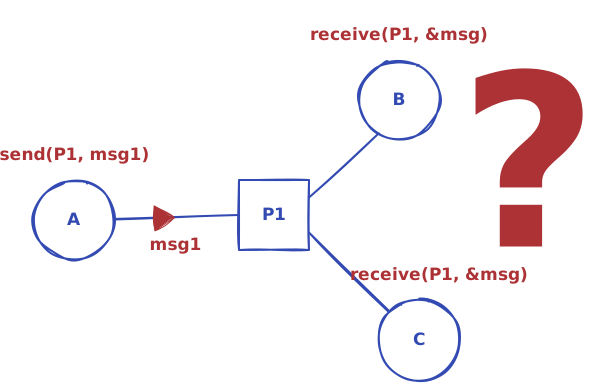
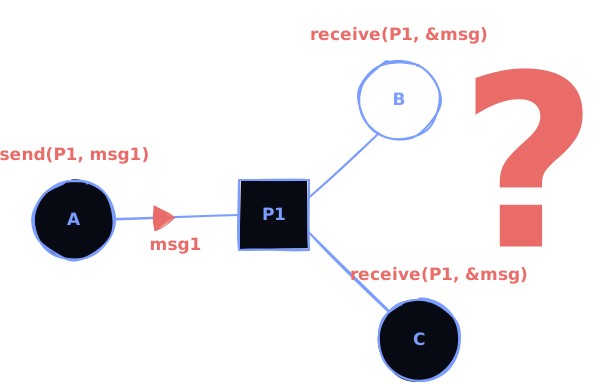
La respuesta correcta dependerá de la elección de los diseñadores del sistema:
-
Limitar el enlace a dos procesos. No permitir que un enlace de comunicación —y por tanto un puerto— esté asociado a más de dos procesos.
-
Limitar la recepción a un solo proceso. No permitir que más de un proceso pueda ejecutar
receive()al mismo tiempo. Por ejemplo, en algunos sistemas solo el proceso que crea el puerto tiene permisos para recibir de él. Los sistemas que optan por esta solución suelen disponer de algún mecanismo para que un proceso pueda transferir el permiso de recibir a otros procesos. -
Dejar la elección al sistema operativo. Permitir que escoja arbitrariamente quién recibe el mensaje si dos o más procesos ejecutan
receive()al mismo tiempo. La elección puede ser aleatoria o mediante algún algoritmo, por ejemplo, por turnos o el siguiente proceso en obtener la CPU, a criterio del planificador de la CPU. Esto es lo que ocurre con las colas de mensajes POSIX.
Buffering
Sección titulada «Buffering»Los mensajes intercambiados por un enlace de comunicación se almacenan en una cola temporal a la espera de ser enviados o, tras recibirlos, a la espera de que los reclame el proceso receptor. Básicamente hay tres formas de implementar dicha cola:
- Con capacidad cero o sin buffering la cola tiene una capacidad máxima de 0 mensajes, por lo que no puede haber ningún mensaje esperando en el enlace. En este caso el proceso transmisor se bloquea en espera hasta que el receptor recibe el mensaje.
- Con buffering automático, donde existe dos opciones:
-
Con capacidad limitada la cola tiene una capacidad máxima de N mensajes, por lo que si la cola se llena el proceso transmisor se bloquea a la espera de que haya espacio en la cola. Obviamente, mientras la cola no se llene en transmisor puede seguir metiendo mensajes sin bloquearse.
-
Con capacidad ilimitada la cola es de longitud potencialmente infinita, lo que permite que el transmisor nunca espere.
Este tipo de buffering es imposible, puesto que los recursos son limitados. En realidad este término hace referencia a colas de longitud variable cuyo máximo viene determinado por la memoria principal disponible, que suele ser lo suficientemente grande como para que podamos considerar que las colas son infinitas.
-
Ejemplo Buffering en las colas de mensajes POSIX
Sección titulada « Buffering en las colas de mensajes POSIX»Las colas de mensajes en sistemas POSIX tienen capacidad limitada. Los límites se configuran al crear la cola, a través del último argumento de mq_open():
struct mq_attr attr = {
    .mq_maxmsg = 5,
    .mq_msgsize = 2049};
mqd_t mqueue = mq_open(    "/foo-queue",    O_CREAT | O_RDWR,    0644,
    &attr);
Estos límites tienen unos valores por defecto por si en el lugar de attr en mq_open() se indica NULL.
El estándar POSIX indica que esos valores por defecto dependen de cada sistema operativo, por lo que es necesario ir a la documentación para desarrolladores de cada sistema para conocer los detalles en cada caso concreto.
Por ejemplo, en Linux los valores por defecto son 10 mensajes y 8 KiB por mensaje, siendo estos, además, los valores máximos que admiten esas propiedades.
Estos valores máximos y por defecto se pueden cambiar para todo el sistema, por si tuviéramos interés en valores globales más altos.
Operaciones síncronas y asíncronas
Sección titulada «Operaciones síncronas y asíncronas»Ahora que sabemos que los mecanismos de comunicación usan búferes para almacenar temporalmente los mensajes, podemos analizar cómo se comportan las llamadas de envío y recepción de mensajes cuando el búfer está lleno o vacío. Por lo general, cuando un proceso intenta enviar un mensaje a otro proceso con send y el búfer de recepción está lleno, el proceso transmisor se bloquea hasta que haya espacio para depositar el mensaje. De manera similar, cuando un proceso intenta recibir un mensaje con receive de otro proceso y la cola de mensajes está vacía, el proceso receptor se bloquea hasta que llegue un mensaje.
Sin embargo, en lugar de bloquearse, puede que a un proceso le interese ejecutar otras tareas en la CPU. A fin de cuentas las comunicaciones son bastante lentas, por lo que en caso de bloquearse podría estar dejando de aprovechar el tiempo de CPU que tienen asignado. Incluso puede darse el caso de que un proceso tenga conexión con múltiples procesos y que no quiera bloquearse para poder seguir comunicándose con el resto. Por lo general, la programación asíncrona es más compleja que la programación síncrona, pero permite aprovechar mejor el tiempo de CPU disponible.
Por eso existen diferentes opciones de diseño a la hora de implementar las llamadas anteriores en función de si se pueden bloquear o no. Concretamente, el paso de mensajes puede ser síncrono —con bloqueo— o asíncrono —sin bloqueo—.
En el envío la diferencia se aprecia cuando la cola de mensajes está llena:
-
Envío asíncrono. El proceso transmisor nunca se bloquea. Si se llama a send con la cola llena, lo más común es que retorne un código de retorno específico: el proceso debe reintentar el envío más tarde. La otra opción es que el sistema operativo llame a una función de callback1, especificada en los argumentos de send, para avisar de cuándo se pudo enviar el mensaje.
-
Envío síncrono. El proceso transmisor se bloquea hasta que pueda depositar el mensaje en la cola.
Y en la recepción, cuando está vacía:
-
Recepción asíncrona. El receptor nunca se bloquea. El sistema operativo puede indicarle que lo intente más tarde con un código de retorno, o devolverle un mensaje vacío. También puede usar una función de callback1 para avisar de que ha llegado un mensaje y ha sido recibido.
-
Recepción síncrona. El receptor se bloquea hasta que llegue algún mensaje.
Algunos sistemas de paso de mensajes son claramente síncronos o asíncronos. Mientras que otros permiten activar un modo u otro según las necesidades de la aplicación. E incluso los hay que soportan que la transmisión y recepción sean síncronas o asíncronas de manera totalmente independiente.
Ejemplo Comunicaciones asíncronas con colas de mensajes POSIX
Sección titulada « Comunicaciones asíncronas con colas de mensajes POSIX»Por defecto las colas de mensajes son síncronas, tanto en envío como en recepción. Es decir, si al enviar un mensaje la cola está llena, el proceso transmisor quedará bloqueado en estado esperando hasta que haya un hueco libre para depositar el nuevo mensaje. Si al recibir un mensaje la cola está vacía, el receptor quedará bloqueado hasta que otro proceso deposite un mensaje.
Sin embargo, si en el argumento oflag de mq_open() un proceso indica la opción O_NONBLOCK estas operaciones para ese proceso en esa cola serán asíncronas:
mqd_t mqueue = mq_open( "foo-mqueue", O_RDONLY | O_NONBLOCK, 0644, &attr);Eso quiere decir que las funciones mq_send() y mq_receive(), en lugar de bloquear el proceso en estado de esperando, devolverán -1 y el valor de errno será EAGAIN.
Esto debe interpretarse como que la operación no se pudo completar y que el proceso debe volver a intentarlo más tarde.
int return_code = mq_receive(mqueue, &message, sizeof(message), &msg_prio);if ( return_code > 0 ){ // Aquí va código para usar el mensaje recibido...}else if ( return_code < 0 && errno == EAGAIN ){ // Aquí el código en caso de que no haya mensajes en la cola...}else if ( return_code < 0 ){ // Aquí va el código para manejar errores de mq_receive()...}Si un proceso debe comunicarse mediante varias colas de mensajes, la comunicación asíncrona también sirve para intentar recibir y enviar de varias colas sin bloquearse en ninguna. Para este caso algunos sistemas ofrecen una alternativa más sencilla y eficiente usando funciones como poll().
Aunque el estándar POSIX no lo especifica así, en Linux los descriptores de colas de mensajes son descriptores de archivo, como también lo son los descriptores de sockets, tuberías y los de archivos abiertos con open(), entre otros. Esta particularidad implica que mediante las funciones select(), poll() o epoll() se pueden monitorizar al mismo tiempo varios descriptores de colas de mensajes, para así saber cuándo se puede enviar o recibir por ellas de forma asíncrona, sin que el proceso se bloquee.
A continuación se puede ver un ejemplo específico con poll(), aunque las tres funciones se utilizan empleando un patrón similar:
-
Abrir o crear las colas que se van a utilizar.
mqd_t mqueue1 = mq_open( "/foo-queue", /* ... */ );mqd_t mqueue2 = mq_open( "/bar-queue", /* ... */ );Resultado Se obtienen los descriptores de las colas de mensajes que se van a monitorizar. En este caso son dos, pero podría ser muchos más, dependiendo de las necesidades de la aplicación.
-
Crear un array de la estructura
pollfd, con un elemento por cola que se quiere monitorizar.struct pollfd fds[] ={{.fd = mqueue1,.events = POLLIN,.revents = 0}, {.fd = mqueue2,.events = POLLIN | POLLOUT,.revents = 0}};Resultado Cada elemento de
fdsqueda asociado a una cola distinta a través del descriptor asignado en el campofde indicando qué eventos interesa vigilar en ella a través deevents. Por ejemplo, paramqueue1solo interesa saber cuándo hay mensajes para recibir, por lo que solo se activaPOLLINen suevents. Mientras que paramqueue2interesa saber tanto cuándo hay mensajes para recibir como cuándo hay hueco para enviar sin bloqueos, por lo que se activanPOLLINyPOLLOUT. -
Llamar iterativamente a poll() —mientras no queramos que termine la aplicación—.
int return_code = poll( fds, 2, -1 );A poll() se le pasa el array
fds, el número de elementos enfds, y el tiempo máximo de espera. Con un número negativo en este último argumento, se indica que queremos que espere indefinidamente.Resultado El proceso queda en estado esperando hasta que ocurra alguno de los eventos señalados en
eventsen alguna de las colas. -
Comprobar si poll() ha detectado algún evento o ha fallado.
if (return_code > 0){// Continúa en el siguiente paso...}else if (return_code < 0){// Error en poll().// Aquí va código para leer errno y manejar el error...// Salir del bucle que llama a poll() o terminar la aplicación, según convenga.}Resultado Si
return_codees positivo, indica en cuántos descriptores se ha detectado un evento. Si es negativo, ha ocurrido algún error, que se puede diagnosticar comprobando el valor de la variable global errno. -
Comprobar en el
reventsde cada cola enfdsqué eventos se han detectado exactamente, y actuar en consecuencia.if (fds[0].revents & POLLIN){// Se ha detectado que hay un mensaje para recibir en la cola mqueue1,// por lo que podemos leerlo sin bloqueos.mq_receive( fds[0].fd, /* ... */ );// Aquí va código para usar el mensaje recibido en mqueue1...}if (fds[1].revents & POLLIN){// Se ha detectado que hay un mensaje para recibir en la cola mqueue2,// por lo que podemos leerlo sin bloqueos.mq_receive( fds[1].fd, /* ... */ );// Aquí va código para usar el mensaje recibido en mqueue2...}if (fds[1].revents & POLLOUT){// Se ha detectado que hay hueco para enviar un mensaje en la cola// mqueue2, por lo que podemos enviar un mensaje sin bloqueos.mq_send( fds[1].fd, /* ... */ );}Resultado
reventsenfdses una máscara de bits similar aevents, pero al retornar de poll() indica qué eventos se han detectado realmente, para cada cola. SiPOLLINestá activo, sabemos que podemos leer un mensaje con mq_receive() sin que se bloquee. SiPOLLOUTestá activo, sabemos que podemos enviar un mensaje con mq_send() sabiendo que tampoco se bloqueará. -
Saltar al paso 3 para seguir monitorizando las colas de mensajes.
Por lo general, poll() se llama en un bucle indefinido que solo termina cuando ya no es necesario que siga monitorizando las colas de mensajes.
Implementaciones de sistemas de paso de mensajes
Sección titulada «Implementaciones de sistemas de paso de mensajes»En este apartado vamos a ver algunos ejemplos de sistemas de paso de mensajes que se utilizan en sistemas operativos reales.
Colas de mensajes POSIX
Sección titulada «Colas de mensajes POSIX»Como hemos comentado a lo largo del capítulo y visto en múltiples ejemplos, las colas de mensajes POSIX son un caso de comunicación indirecta, con tamaño de mensaje variable, buffering con capacidad limitada y que soporta operaciones asíncronas.
Las colas de mensajes son útiles para enviar mensajes de pequeño tamaño entre procesos que se ejecutan en el mismo sistema. Además tienen la posibilidad de asociar a cada mensaje una prioridad, de tal forma que se reciban primero los mensajes de prioridad más alta. Su uso es relativamente común en sistemas de tiempo real, aunque lo más frecuente en los sistemas de propósito general es usar sockets.
Señales POSIX
Sección titulada «Señales POSIX»En los sistemas POSIX, una forma más sencilla de comunicar dos procesos del mismo sistema es mediante el envío de una señal de uno al otro. Los procesos pueden mandar señales utilizando la llamada al sistema kill(), que solo requiere el identificador del proceso de destino y el número que identifica la señal.
kill(pid, SIGTERM);Como se usa el identificador del proceso, estamos hablando de un mecanismo de comunicación directa. Mientras que el tamaño y formato del mensaje es fijo, puesto que las señales solo pueden portar la información de que ha ocurrido un evento, indicando qué evento es a través del número que identifica la señal.
Cada señal tiene un efecto particular por defecto, que por lo general es matar al proceso que las recibe. Sin embargo, cada proceso puede declarar un manejador de señal: una función del programa que será invocada por el sistema operativo para tratar una señal determinada, interrumpiendo lo que esté haciendo el proceso en ese momento. En ese sentido las señales en POSIX puede interpretarse como una forma de interrupción por software.
La forma recomendada por el estándar de configurar un manejador de señal es usando la llamada al sistema sigaction(), que recibe como argumento una estructura de tipo sigaction que describe cómo tratar la señal cuando llega al proceso.
void my_sigterm_handler(int sig) {    // Aquí va el código que se ejecutará cuando llegue la señal SIGTERM...}
struct sigaction act = {
    .sa_handler = &my_sigterm_handler,    .sa_sigaction = NULL,    .sa_mask = 0,
    .sa_flags = SA_RESTART,};
En el ejemplo se usa la opción SA_RESTART, que indica que si la señal llega durante una llamada al sistema, la llamada debe continuar una vez se haya salido del manejador de señal.
El comportamiento por defecto, sin esta opción, es que la llamada al sistema interrumpida falle con el error EINTR en errno.
Una vez configurada la estructura, se pasa a sigaction() junto con el identificador de la señal que se quiere manejar:
sigaction(
    SIGTERM,
    &act,    NULL);
A partir de este momento, cuando el proceso reciba la señal SIGTERM, el sistema operativo interrumpirá lo que esté haciendo y llamará a la función my_sigterm_handler().
Las señales fueron diseñadas originalmente como un mecanismo para que el sistema operativo notificase a los programas ciertos errores y sucesos críticos (ver la siguiente figura). Por ejemplo:
-
SIGHUP—o simplementeHUP— es enviada a cada proceso iniciado desde una sesión de terminal cuando la sesión termina. En el caso de los servicios del sistema —que, como no son interactivos, no están conectados a ninguna terminal— suele usarse para indicarles que deben reiniciarse, volviendo a leer sus archivos de configuración, o para que guarden su estado interno en algún sitio conocido del almacenamiento. -
SIGINT—oINT— es enviada al proceso que está enganchado a la consola cuando el usuario pulsa el carácter de interrupción —frecuentemente la combinación de teclas Ctrl+C—. -
SIGTERM—oTERM— es enviada al proceso cuando debe terminar. Por ejemplo, el sistema operativo envía esta señal a todos los procesos cuando se está apagando el sistema. -
SIGSEGV—oSEGV— es enviada a un proceso cuando intenta acceder a una zona de memoria a la que no tiene permiso. Si no se maneja esta señal, el programa termina con el conocido mensaje de violación de segmento.
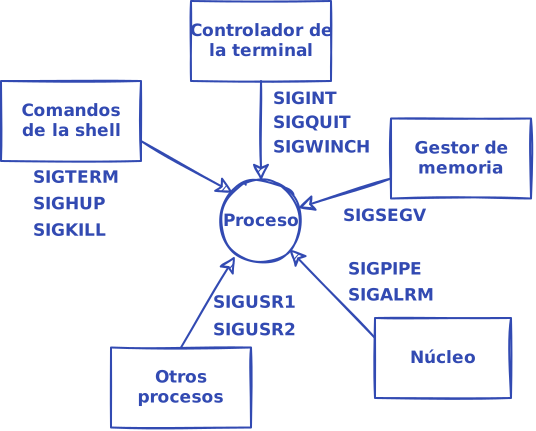
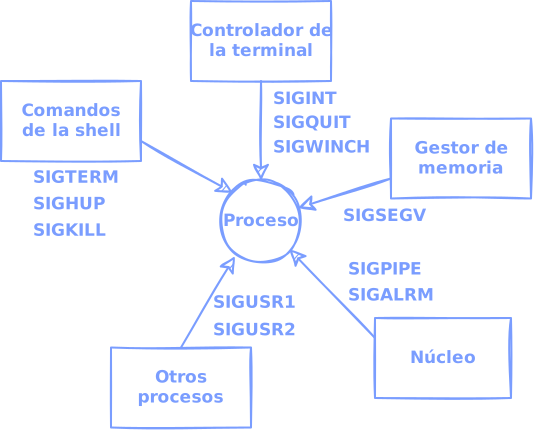
Obviamente hay muchas más señales.
Entre todas, el estándar POSIX incluye dos señales —USR1 y USR2— especialmente indicadas para usarlas con el significado que nosotros queramos.
En la siguiente tabla se muestran las señales POSIX más comunes:
| Señal | Número | Significado |
|---|---|---|
SIGHUP | 1 | Se ha cerrado la terminal o ha terminado el proceso de control |
SIGINT | 2 | Interrupción desde el teclado (Ctrl+C) |
SIGQUIT | 3 | Solicitud de terminación con volcado de memoria (Ctrl+\) |
SIGILL | 4 | Instrucción ilegal |
SIGTRAP | 5 | Se ha alcanzado un punto de ruptura o de traza (depuración) |
SIGABRT | 6 | Abortar el proceso, por ejemplo al llamar a abort() |
SIGBUS | 7 | Error de bus —acceso a memoria incorrecto— |
SIGFPE | 8 | Operación aritmética inválida |
SIGKILL | 9 | Terminación forzosa del proceso —no se puede capturar, bloquear ni ignorar— |
SIGUSR1 | 10 | Señal definida por el usuario 1 |
SIGSEGV | 11 | Referencia a una zona de memoria inválida —violación de segmento— |
SIGUSR2 | 12 | Señal definida por el usuario 2 |
SIGPIPE | 13 | Escritura en una tubería sin procesos leyendo del otro extremo |
SIGALRM | 14 | Se ha cumplido un temporizador programado con alarm() |
SIGTERM | 15 | Solicitud de terminación del proceso |
SIGCHLD | 17 | Un proceso hijo se ha detenido, terminado o continuado |
SIGCONT | 18 | Continuar la ejecución si el proceso estaba detenido |
SIGSTOP | 19 | Detener el proceso —no se puede capturar, bloquear ni ignorar— |
SIGTSTP | 20 | Detener el proceso, solicitado desde el terminal (Ctrl+Z) |
SIGTTIN | 21 | Un proceso en segundo plano intenta leer del terminal |
SIGTTOU | 22 | Un proceso en segundo plano intenta escribir en el terminal |
SIGURG | 23 | Condición urgente en un socket |
SIGXCPU | 24 | Se ha superado el límite de tiempo de CPU |
SIGXFSZ | 25 | Se ha superado el límite de tamaño de archivo |
SIGVTALRM | 26 | Se ha cumplido un temporizador de reloj virtual |
SIGPROF | 27 | Se ha cumplido un temporizador de profiling |
SIGWINCH | 28 | La ventana del terminal ha cambiado de tamaño |
SIGPOLL | 29 | Ha ocurrido un evento monitorizable en un descriptor de archivo |
SIGSYS | 31 | Llamada al sistema incorrecta |
Los ejemplos de colas de mensajes, tuberías y de este capítulo utilizan señales para mostrar la hora periódicamente. El código dedicado a eso está en timeserver.cpp y se comparte entre esos ejemplos.
Además, el siguiente ejemplo en GitHub reúne todo lo visto en esta sección: instala manejadores para SIGTERM, SIGINT y SIGHUP que muestran un mensaje por pantalla cuando llega una de esas señales.
También instala un manejador para SIGSEGV que termina el proceso de forma controlada con _exit(), en lugar de dejar que ocurra la terminación abrupta por defecto.
Tuberías
Sección titulada «Tuberías»Las tuberías son un mecanismo de paso de mensajes de comunicación indirecta, orientada a flujos, capacidad limitada y, generalmente, comunicación síncrona —aunque en algunos sistemas operativos también puede soportar asíncrona—.
Conceptualmente, cada tubería tiene dos extremos en los que opera utilizando la misma interfaz que generalmente empleamos para manipular archivos.
Es decir, usando funciones como read(), write() y close(), entre otras.
Un extremo permite a los procesos en ese extremo escribir en la tubería, mientras el otro extremo permite a los procesos leer de la tubería los datos escritos desde el otro extremo.
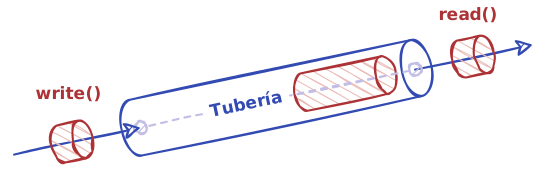
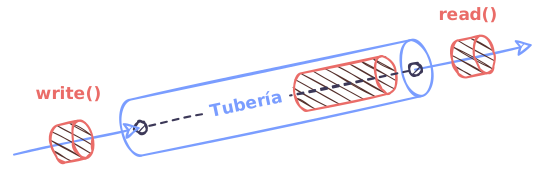
El que cada extremo imite ser un archivo, facilita que se puedan usar en muchas de las llamadas al sistema que aceptan un archivo como argumento. Los procesos pueden leer o escribir en un archivo sin saber realmente si están accediendo a un archivo real o se están comunicando con otro proceso mediante una tubería.
Existen dos tipos de tuberías:
- Las tuberías anónimas que solo existen en el espacio de direcciones del proceso que las crea, de tal forma que debe heredarse de padres a hijos para que otros procesos puedan tener acceso.
- Las tuberías con nombre —o FIFO en sistemas POSIX— son públicas al resto del sistema, por lo que teóricamente cualquier proceso con permisos puede abrir una para comunicarse con otros procesos. Por eso se suele utilizar en aplicaciones cliente-servidor, donde un proceso servidor ofrece algún servicio a otros procesos cliente a través de la tubería.
Estas son algunas de las funciones de la API que permiten manipular tuberías en sistemas POSIX y Microsoft Windows:
| Operación | POSIX API | Windows API |
|---|---|---|
| Crear tubería anónima | pipe() | CreatePipe() |
| Crear tubería con nombre | mkfifo() | CreateNamedPipe() |
| Abrir tubería con nombre | open() | CreateFile() |
| Leer | read() | ReadFile() |
| Escribir | write() | WriteFile() |
| Cerrar | close() | CloseHandle() |
| Destruir tubería con nombre | unlink() | Automático |
Con fork() es muy sencillo lanzar otros procesos para que ejecuten tareas en paralelo. El proceso hijo tiene acceso a los datos del padre por la forma en la que funciona fork() y gracias a las tuberías anónimas puede comunicar los resultados al padre. En fork-pipe.cpp se puede observar un ejemplo de esto.
Además, el hecho de que cada extremo se comporte como un archivo —uno en modo solo lectura y el otro en modo solo escritura— hace posible redirigir la E/S estándar del proceso hijo.
Es decir, conectar la entrada, la salida estándar o la salida de error a una tubería, desde la que leer lo que el proceso intenta imprimir por la pantalla de la terminal o proporcionarle lo que debe leer, como si fuera desde el teclado.
En fork-redir.cpp se puede ver un ejemplo de cómo ejecutar el comando ls y redirigir su salida al proceso padre para contar el número de líneas en lo que el comando quería mostrar por pantalla.
Por otro lado, las tuberías con nombre permiten que un proceso se comunique con cualquier otro, solo con conocer la ruta de la tubería. En fifo.cpp tenemos un ejemplo de un programa que muestra la hora del sistema de forma periódica, mientras espera órdenes de una tubería que sirve de canal de control remoto. El programa en fifo-control.cpp puede conectarse a esa tubería y mandar el comando que hace terminar fifo.cpp.
Sockets
Sección titulada «Sockets»Mientras que las tuberías son conceptualmente un enlace de comunicación unidireccional que tiene dos extremos, un socket representa un solo extremo en un enlace de comunicación bidireccional. Para que una pareja de procesos se pueda comunicar son necesarios dos sockets —uno en cada proceso— de manera que cada uno de ellos es el medio por el que el proceso accede al enlace de comunicación.
Los sockets son un mecanismo de paso de mensajes de comunicación indirecta, que admite tanto comunicación orientada a flujos como mensajes de tamaño variable, buffering de capacidad limitada y tanto comunicación síncrona como asíncrona, aunque el comportamiento real final de la interfaz depende de la tecnología de red utilizada.
La API de sockets fue creada por la Universidad de Berkeley para abstraer el acceso a la familia de protocolos de Internet en el UNIX desarrollado por esa misma universidad. Sin embargo, rápidamente se convirtió en el estándar de facto para la comunicación en red, por lo que todos los sistemas operativos modernos —incluidos los sistemas POSIX y Microsoft Windows— tienen una implementación de la misma.
Pese a sus orígenes en Internet, los sockets se diseñaron para ser independientes de la tecnología de red subyacente con la que se implementa el enlace de comunicación. En Linux, por ejemplo, se puede utilizar como interfaz de programación para utilizar dos decenas de familias de protocolos y tecnologías diferentes.
Para crear un socket se utiliza la llamada al sistema socket() —o socket() en Windows API, con una interfaz prácticamente idéntica—:
int sockfd = socket( AF_UNIX, SOCK_DGRAM, 0)En Windows se debe llamar a WSAStartup() antes de usar cualquier función de la API de sockets, pero en este ejemplo no se muestra por simplicidad.
SOCKET sockfd = socket( AF_UNIX, SOCK_DGRAM, 0)-
En sistemas POSIX la función devuelve un
intcon el descriptor del socket —o un valor negativo si falla—, mientras que en Windows API devuelve un valor de tipoSOCKET—oINVALID_SOCKETsi falla—. Esto es así porque el estándar no especifica que los sockets tengan que ser descriptores de archivo, aunque los sistemas POSIX los tratan como tales. -
En el primer argumento se especifica la familia de protocolos.
AF_UNIXson un tipo de socket que solo sirve para comunicar procesos en el mismo sistema, denominado socket de dominio UNIX. Otras familias muy comunes sonAF_INET, que corresponde a la familia de protocolos TCP/IP yAF_INET6para los protocolos IPv6. -
En el segundo argumento se especifica el tipo del socket. Cada tipo suele corresponde con un protocolo concreto de la familia elegida. Por ejemplo, los sockets
SOCK_DGRAMson «no orientados a conexión», no fiables y de longitud máxima fija, así que en la familiaAF_INETestos sockets utilizan UDP. Mientras que los socketsSOCK_STREAMson orientados a conexión, fiables, bidireccionales y orientados a flujo, por lo que en la familiaAF_INETutilizan TCP.
Un socket recién creado no tiene un nombre que otro proceso pueda usar para identificarlo y comunicarse con él. Si se va a usar este socket solo para enviar mensajes a otro socket, esto no es un problema. Pero para recibir mensajes, el remitente tiene que poder identificar al destinatario. Para asignar un nombre o dirección a un socket se utiliza bind(). La dificultad es que cada familia de protocolos tiene un formato de direcciones diferente, por lo que la interfaz es un poco compleja y hay que tener cuidado de usar el formato adecuado.
Por ejemplo, para un socket de dominio UNIX las direcciones son rutas del sistema de archivos, por lo que se usa una estructura de tipo sockaddr_un donde se almacena dicha ruta:
struct sockaddr_un addr = {
    .sun_family = AF_UNIX,
    .sun_path = "/tmp/foo-socket"};
Para otras familias, las direcciones se indican de otra manera, por lo que es necesario consultar la documentación.
Por ejemplo, para un socket de la familia AF_INET la dirección se indica mediante una estructura de tipo sockaddr_in, que contiene la dirección IP y el número de puerto.
Una vez construida la dirección, se asigna al socket con bind():
int result_code = bind(
    sockfd,
    (struct sockaddr*) &addr,
    sizeof(addr))
Como en el resto de llamadas al sistema, en caso de error bind() devuelve un número negativo y errno contendrá el código del error.
La API de sockets incluye muchas otras funciones:
-
listen(), para poner sockets tipo
SOCK_STREAMa la espera de conexiones. -
connect(), para conectar un socket tipo
SOCK_STREAMcon otro que esté a la espera de conexiones. -
accept(), para que un socket tipo
SOCK_STREAMa la espera de conexiones acepte una solicitud de conexión. -
shutdown(), para cerrar uno de los sentidos de una conexión.
-
close(), para destruir un socket.
-
send(), sendto() y sendmsg(), para enviar mensajes. De las tres, send() solo se puede utilizar con sockets conectados. Mientras que sendto() y sendmsg() permiten indicar la dirección del socket de destino, por lo que son útiles en sockets no orientados a conexión
SOCK_DGRAM. -
recv(), recvfrom() y recvmsg(), para recibir mensajes. De las tres, recvfrom() permite obtener la dirección del socket del que llegó el mensaje. Por eso es útil en sockets no orientados a conexión
SOCK_DGRAM.
Por ejemplo, así podemos usar recvfrom() para recibir un mensaje de un socket:
struct sockaddr_un addr;socklen_t addrlen;
int result_code = recvfrom(
    sockfd,
    &message,
    sizeof(message),    0,
    (struct sockaddr*) &addr,
    &addrlen)
En caso de éxito, recvfrom() devuelve el número de bytes del mensaje recibido. En caso de error, devuelve un -1 y errno contiene el código del error.
Las operaciones con sockets son síncronas por defecto.
Sin embargo, es posible configurarlos en modo asíncrono, para que así cualquiera de estas funciones falle, retornando -1 y código de error EAGAIN o EWOULDBLOCK, antes de poner el proceso en estado esperando.
En este caso se pueden utilizar las funciones select() y poll() para monitorizar varios sockets al mismo tiempo, de forma similar a como se hace para colas de mensajes POSIX.
Referencias de las API
Sección titulada «Referencias de las API»POSIX
Termina el proceso inmediatamente, sin ejecutar las operaciones de cierre registradas ni vaciar los búferes de E/S.
void _exit(int status);Termina el proceso de forma anómala, enviando la señal SIGABRT.
void abort(void);Acepta una conexión entrante en un socket.
int accept(int sockfd, struct sockaddr* addr, socklen_t* addrlen);Programa el envío de la señal SIGALRM al proceso transcurridos los segundos indicados.
unsigned int alarm(unsigned int seconds);Asocia una dirección local a un socket.
int bind(int sockfd, const struct sockaddr* addr, socklen_t addrlen);Establece una conexión con un socket remoto.
int connect(int sockfd, const struct sockaddr* addr, socklen_t addrlen);Interfaz de E/S multiplexada de alto rendimiento para Linux.
int epoll_create1(int flags);int epoll_ctl(int epfd, int op, int fd, struct epoll_event* event);int epoll_wait(int epfd, struct epoll_event* events, int maxevents, int timeout);Variable global que contiene el código del último error ocurrido.
extern int errno;Marca un socket como pasivo, preparado para aceptar conexiones.
int listen(int sockfd, int backlog);Crea un archivo especial FIFO (pipe con nombre).
int mkfifo(const char* pathname, mode_t mode);Abre o crea una cola de mensajes POSIX.
mqd_t mq_open(const char* name, int oflag);mqd_t mq_open(const char* name, int oflag, mode_t mode, struct mq_attr* attr);Recibe un mensaje de una cola de mensajes POSIX.
ssize_t mq_receive(mqd_t mqdes, char* msg_ptr, size_t msg_len, unsigned int* msg_prio);Envía un mensaje a una cola de mensajes POSIX.
int mq_send(mqd_t mqdes, const char* msg_ptr, size_t msg_len, unsigned int msg_prio);Abre o crea un archivo y devuelve un descriptor de archivo.
int open(const char* pathname, int flags);int open(const char* pathname, int flags, mode_t mode);Crea una tubería anónima unidireccional entre dos descriptores.
int pipe(int pipefd[2]);Espera a que uno o varios descriptores de archivo estén listos para E/S.
int poll(struct pollfd* fds, nfds_t nfds, int timeout);Lee datos de un descriptor de archivo.
ssize_t read(int fd, void* buf, size_t count);Recibe datos de un socket conectado.
ssize_t recv(int sockfd, void* buf, size_t len, int flags);Recibe datos de un socket y obtiene la dirección del remitente.
ssize_t recvfrom(int sockfd, void* restrict buf, size_t len, int flags, struct sockaddr* restrict src_addr, socklen_t* restrict addrlen);Recibe un mensaje de un socket con control detallado.
ssize_t recvmsg(int sockfd, struct msghdr* msg, int flags);Espera a que uno o varios descriptores de archivo estén listos para E/S.
int select(int nfds, fd_set* readfds, fd_set* writefds, fd_set* exceptfds, struct timeval* timeout);Envía datos a través de un socket conectado.
ssize_t send(int sockfd, const void* buf, size_t len, int flags);Envía un mensaje a través de un socket con control detallado.
ssize_t sendmsg(int sockfd, const struct msghdr* msg, int flags);Envía datos a un socket indicando la dirección de destino.
ssize_t sendto(int sockfd, const void* buf, size_t len, int flags, const struct sockaddr* dest_addr, socklen_t addrlen);Cierra parcialmente una conexión de socket.
int shutdown(int sockfd, int how);Examina o cambia la acción asociada a una señal.
int sigaction(int signum, const struct sigaction* act, struct sigaction* oldact);Crea un endpoint de comunicación (socket).
int socket(int domain, int type, int protocol);Windows API
Cierra un handle abierto del sistema.
BOOL CloseHandle(HANDLE hObject);Crea o abre un archivo, dispositivo, directorio o tubería.
HANDLE CreateFile(LPCTSTR lpFileName, DWORD dwDesiredAccess, DWORD dwShareMode, LPSECURITY_ATTRIBUTES lpSecurityAttributes, DWORD dwCreationDisposition, DWORD dwFlagsAndAttributes, HANDLE hTemplateFile);Crea una instancia de una tubería con nombre.
HANDLE CreateNamedPipe(LPCTSTR lpName, DWORD dwOpenMode, DWORD dwPipeMode, DWORD nMaxInstances, DWORD nOutBufferSize, DWORD nInBufferSize, DWORD nDefaultTimeOut, LPSECURITY_ATTRIBUTES lpSecurityAttributes);Crea una tubería anónima.
BOOL CreatePipe(PHANDLE hReadPipe, PHANDLE hWritePipe, LPSECURITY_ATTRIBUTES lpPipeAttributes, DWORD nSize);Recupera un mensaje de la cola de mensajes del hilo.
BOOL GetMessage(LPMSG lpMsg, HWND hWnd, UINT wMsgFilterMin, UINT wMsgFilterMax);Envía un mensaje a una cola de mensajes de un hilo.
BOOL PostThreadMessage(DWORD idThread, UINT Msg, WPARAM wParam, LPARAM lParam);Lee datos de un archivo o dispositivo.
BOOL ReadFile(HANDLE hFile, LPVOID lpBuffer, DWORD nNumberOfBytesToRead, LPDWORD lpNumberOfBytesRead, LPOVERLAPPED lpOverlapped);Crea un socket asociado a un proveedor de transporte específico.
SOCKET socket(int af, int type, int protocol);Escribe datos en un archivo o dispositivo.
BOOL WriteFile(HANDLE hFile, LPCVOID lpBuffer, DWORD nNumberOfBytesToWrite, LPDWORD lpNumberOfBytesWritten, LPOVERLAPPED lpOverlapped);Inicia el uso de la biblioteca Winsock por parte de un proceso.
int WSAStartup(WORD wVersionRequired, LPWSADATA lpWSAData);Notas al pie
Sección titulada «Notas al pie»-
Una retrollamada o función de callback es una función
foo()que se pasa como argumento a otra funciónbar(), de forma quebar()invocará afoo()cuando ocurra un evento determinado. ↩ ↩2 -
El estándar POSIX define las funciones seguras en señales de la API en el apartado «2.4.3 Signal» de la especificación. En Linux, la página de manual
signal-safety(7)recoge la misma lista, con las extensiones propias del sistema. ↩