
15. Memoria principal
Etapas por las que pasa un programa hasta que se ejecuta, reubicación de sus direcciones, enlazado dinámico, espacio de direcciones virtual, asignación contigua, fragmentación e intercambio.
La memoria es un recurso central para el funcionamiento de un sistema operativo moderno, puesto que es el único medio de almacenamiento al que la CPU puede acceder directamente. Por ello, para que un programa pueda ser ejecutado, debe ser cargado en la memoria desde el disco y creadas o modificadas las estructuras internas del sistema operativo necesarias para convertirlo en un proceso. Además, según cómo se gestione la memoria, los procesos —o partes de ellos— pueden moverse de la memoria al disco y viceversa durante su ejecución. Así se ajustan las necesidades de memoria para mantener el uso de la CPU lo más alto posible.
Como comentamos en «Sistemas multiprogramados», en los sistemas multiprogramados existe una cola de entrada, que se define como aquella formada por el conjunto de procesos en disco que esperan para ser cargados en la memoria para su ejecución.
Por tanto, el procedimiento normal de ejecución de un programa en dichos sistemas es:
- Seleccionar un proceso de la cola de entrada y cargarlo en la memoria.
- Mientras el proceso se ejecuta, este accede a instrucciones y datos de la memoria.
- Finalmente, el proceso termina y su espacio en memoria es marcado como disponible.
En los sistemas de propósito general modernos —desde los sistemas de tiempo compartido y los primeros sistemas de escritorio— no existe cola de entrada, por lo que los programas se cargan inmediatamente en memoria cuando los usuarios solicitan su ejecución. Excepto por eso, el procedimiento normal de ejecución de un programa es similar al de los sistemas multiprogramados.
Etapas de un programa de usuario
Sección titulada «Etapas de un programa de usuario»En la mayor parte de los casos, un programa de usuario debe pasar por diferentes etapas —algunas de las cuales son opcionales— antes de ser ejecutado (ver la siguiente figura).
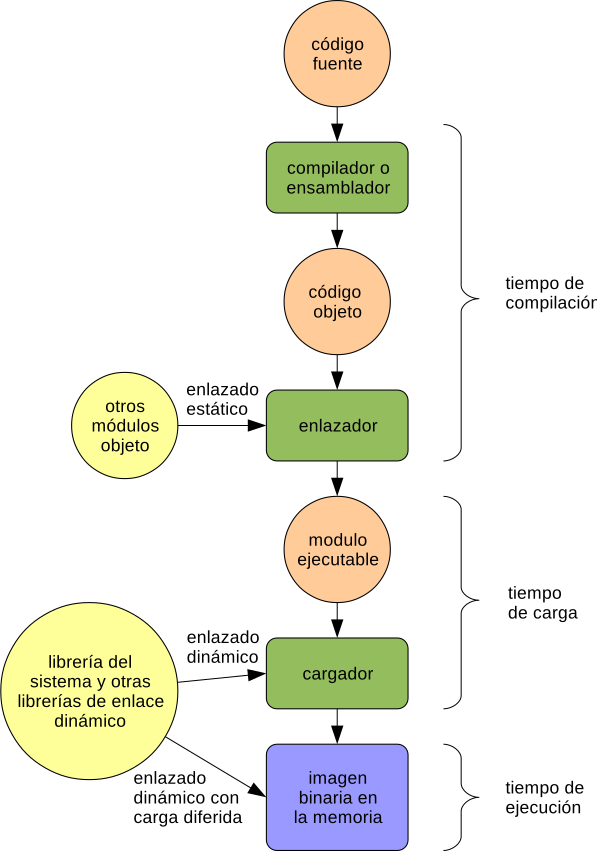
Los archivos de código fuente del programa son compilados por el compilador, generando un archivo de código objeto —con extensiones .o u .obj— para cada uno.
Todos los archivos de código objeto son unidos por el enlazador para crear el archivo ejecutable, en una fase que se denomina enlazado estático.
En esta fase también se pueden incorporar al ejecutable librerías de enlace estático —con extensiones .a o .lib— con código objeto que ha sido empaquetado para ser reutilizado en múltiples ejecutables.
Al crear el ejecutable se pueden guardar en él dependencias respecto a librerías que se enlazarán posteriormente, durante la carga o ejecución del programa, en una fase denominada enlazado dinámico.
El sistema operativo examina esas dependencias cuando va a ejecutar el programa, mientras construye la imagen binaria del proceso en la memoria.
Entonces carga las librerías de enlace dinámico indicadas —con extensiones .so, .dylib o .dll— y resuelve las referencias del programa a sus variables y funciones.
Las librerías de enlace dinámico contienen código objeto, enlazado en un formato especial de ejecutable diseñado para contener partes compartidas entre archivos ejecutables.
Este proceso puede ocurrir mientras se carga el ejecutable —como se ha descrito— o cuando el programa usa por primera vez un elemento de las librerías de enlace dinámico. También es común que el sistema ofrezca funciones para que los programas puedan cargar manualmente e invocar funciones de librerías de enlace dinámico. Esto es muy útil para crear programas que se puedan mejorar por medio de extensiones o plugins.
| Linux y otros sistemas tipo UNIX | macOS | Microsoft Windows | |
|---|---|---|---|
| Código objeto | .o | .o | .obj |
| Librería de enlace estático | .a | .a | .lib |
| Ejecutable | (Sin extensión) | (Sin extensión) | .exe |
| Librería de enlace dinámico | .so | .so, .dylib | .dll |
| Formato de ejecutables y librerías de enlace dinámico | Executable and Linkable (ELF) | Portable (PE) |
Reubicación de las direcciones
Sección titulada «Reubicación de las direcciones»La mayor parte de los sistemas permiten que un proceso de usuario resida en cualquier parte de la memoria física.
Así, aunque el espacio de direcciones del sistema comience en 0x00000000, la primera dirección del proceso de usuario no tiene por qué ser esa.
En cada una de las etapas vistas en «Etapas de un programa de usuario» las direcciones pueden representarse de formas distintas, por lo que en cada paso es necesario reasignar las direcciones usadas en una etapa en direcciones de la siguiente.
Por ejemplo, en el código fuente de un programa las direcciones son generalmente simbólicas, como los nombres de las variables y las funciones.
A continuación, un compilador suele reasignar esas direcciones simbólicas en direcciones reubicables del estilo de «120 bytes desde el comienzo del módulo».
Finalmente, el enlazador —que genera el ejecutable— o el cargador —que carga el programa en la memoria— convierte esas direcciones reubicables en direcciones absolutas, como 0x00210243.
Por tanto, en cada etapa se traducen las direcciones de un espacio de direcciones en el siguiente. Sin embargo, para que al final el programa pueda ser ejecutado, tanto los datos como las instrucciones deben reasignarse en algún momento a direcciones absolutas de la memoria. Esto puede ocurrir en tiempo de compilación, tiempo de carga o tiempo de ejecución.
Reubicación en tiempo de compilación
Sección titulada «Reubicación en tiempo de compilación»Si durante la compilación o el enlazado se conoce el lugar de la memoria donde va a ser ejecutado el proceso, se puede generar directamente código con direcciones absolutas o código absoluto.
Eso significa que si en algún momento la dirección de inicio donde es cargado el programa cambia, es necesario recompilar el código fuente del programa para poder ejecutarlo en la nueva ubicación.
Reubicación en tiempo de carga
Sección titulada «Reubicación en tiempo de carga»Si no se conoce durante la compilación el lugar donde va a residir un programa cuando sea ejecutado, el compilador y el enlazador deben generar ejecutables con código reubicable.
En este tipo de código se utilizan direcciones reubicables, de manera que se retrasa su asignación a direcciones absolutas hasta el momento de la carga del programa. Esto permite que un programa pueda residir en cualquier parte de la memoria física, cargando los procesos donde más convenga para maximizar el aprovechamiento de la misma.
Para generar código reubicable, por lo general, el compilador genera código independiente de la posición o PIC (Position-Independent Code). Este tipo de código se puede ejecutar adecuadamente y sin modificaciones independientemente del lugar de la memoria donde esté ubicado, porque utiliza direcciones relativas.
Lamentablemente, esto puede limitar las características de la CPU que puede utilizar el compilador o, a veces, las instrucciones que usan direcciones absolutas son más rápidas que las que usan direcciones relativas, aunque en los procesadores modernos la diferencia apenas es perceptible.
Por ejemplo, las CPU x86-64 soportan un modo de direccionamiento en el que las direcciones son relativas a la dirección en el contador de programa. Esto simplifica generar código reubicable eficiente. Sin embargo, en las CPU x86 anteriores, las instrucciones de salto podían ser relativas al contador de programa, pero no ocurría así con aquellas destinadas a acceder a los datos del programa.
Cuando no se puede o no es eficiente generar código independiente de la posición se puede recurrir al uso de tablas de reubicación en tiempo de carga. En este caso el compilador y el enlazador generan:
-
Código con direcciones relativas a cierta dirección fija del ejecutable, como el comienzo de la sección de código. También puede llevar direcciones absolutas, calculadas suponiendo que el ejecutable se cargará en una dirección concreta de la memoria, que suele guardarse en su cabecera.
-
Una tabla de reubicaciones que se almacena en el mismo ejecutable. Esta tabla contiene punteros a las ubicaciones en el código del ejecutable de las direcciones que deben reubicarse al cargarlo.
Durante la carga, el cargador del sistema operativo, una vez ha copiado a la memoria el contenido del ejecutable y conoce la ubicación definitiva del programa, recorre la tabla de reubicaciones para buscar las direcciones reubicables y actualizarlas.
Extra Direcciones en el código objeto en Linux x86-64
Sección titulada « Direcciones en el código objeto en Linux x86-64»Supongamos que en un sistema Linux x86-64 tenemos el siguiente código en un archivo de nombre test.c:
long i = 10;
int test(){    i = 12;    return 0;}
int main(){    i = 11;    return test();}
En lugar de compilarlo para generar el ejecutable final, podemos usar la opción -c del compilador para que solo genere el archivo de código objeto correspondiente.
Después podemos usar el comando para examinar el código objeto:
$ gcc -c test.c$ objdump -d test.o
test.o:     file format elf64-x86-64

Disassembly of section .text:
0000000000000000 <test>:   0:   f3 0f 1e fa             endbr64   4:   55                      push   %rbp   5:   48 89 e5                mov    %rsp,%rbp   8:   48 c7 05 00 00 00 00    movq   $0xc,0x0(%rip)        # 13 <test+0x13>   f:   0c 00 00 00  13:   b8 00 00 00 00          mov    $0x0,%eax  18:   5d                      pop    %rbp  19:   c3                      ret
000000000000001a <main>: 1a: f3 0f 1e fa endbr64 1e: 55 push %rbp 1f: 48 89 e5 mov %rsp,%rbp 22: 48 c7 05 00 00 00 00 movq $0xb,0x0(%rip) # 2d <main+0x13> 29: 0b 00 00 00 2d: b8 00 00 00 00 mov $0x0,%eax 32: e8 00 00 00 00 call 37 <main+0x1d> 37: 5d pop %rbp 38: c3 ret- El archivo de código objeto se divide en varias secciones o segmentos.
En el segmento de código o
.textse almacenan las funciones compiladas del código original. Cada función tiene una ubicación, que es relativa a su posición dentro del segmento de código en el archivo. Obviamente, estas no son las direcciones definitivas en las que se ejecutarán estas funciones cuando el ejecutable sea cargado en la memoria, por lo que este código objeto generado por el compilador debe ser código reubicable. calles la instrucción encargada de invocar atest()desdemain(), pero si ejecutamos este código en su estado actual, la ejecución saltaría a la instrucción en0x37, es decir, a la siguiente trascall. Esto no es un error del compilador, sino que el compilador no ha puesto la dirección correcta porque aún desconoce cuál será la ubicación definitiva detest(). En x86-64 las instrucciones de salto comocallhacen saltos relativos al contador de programa —almacenado en un registro llamadorip—. Todas estas instrucciones llevan un desplazamiento que se suma al valor actual derip, que contiene la dirección en la memoria de la siguiente instrucción. Como el compilador no sabe dónde estarátest(), deja este desplazamiento a 0 —por eso los bytes00 00 00 00en la codificación de la instruccióncall— por lo que el salto será a la siguiente instrucción.- En el acceso a la variable
ipara cambiar su valor, ocurre algo parecido. La dirección se escribe relativa al contador de programarip, pero como el compilador no sabe la posición definitiva de la variable, deja el desplazamiento a 0. Por eso el desensamblado indica lo de0x0(%rip), que quiere decir: dirección desplazada 0 respecto arip.
Durante el enlazado, para generar el ejecutable definitivo, es necesario saber dónde están en el código las direcciones que se deben reubicar. Para eso el archivo de código objeto lleva una tabla de reubicación, que también se puede leer con :
$ objdump -r -j .text test.o
test.o:     file format elf64-x86-64
RELOCATION RECORDS FOR [.text]:OFFSET           TYPE              VALUE000000000000000b R_X86_64_PC32     i-0x00000000000000080000000000000025 R_X86_64_PC32     i-0x00000000000000080000000000000033 R_X86_64_PLT32    test-0x0000000000000004
En nuestro ejemplo la tabla contiene tres entradas, dos para las dos instrucciones que modifican la variable i y una para la instrucción call que sirve para invocar test().
La primera columna indica la ubicación en .text de la dirección que se debe reubicar.
Mientras la segunda columna especifica el tipo de reubicación y la tercera contiene información adicional que hace falta para realizar la reubicación.
Por ejemplo, la primera entrada del ejemplo indica que debe desplazarse en 0x08 la dirección a reubicar en 0x0b —el acceso a i en test()— para que apunte a la dirección de la variable i.
Reubicación en tiempo de ejecución
Sección titulada «Reubicación en tiempo de ejecución»Si un proceso puede ser movido durante su ejecución de un lugar de la memoria a otro, la reubicación de direcciones debe ser retrasada hasta el momento de la ejecución de cada instrucción del programa.
Para que esto sea posible, necesitamos disponer de hardware especial que suele estar presente en la mayor parte de las CPU modernas, por lo que la inmensa mayoría de los sistemas operativos de propósito general modernos utilizan este método. De él hablaremos en «Espacio de direcciones virtual frente a físico».
Espacio de direcciones virtual frente a físico
Sección titulada «Espacio de direcciones virtual frente a físico»En «Protección de la memoria» vimos que en los sistemas operativos modernos, como medida de protección, los procesos no tienen acceso libre a la memoria física.
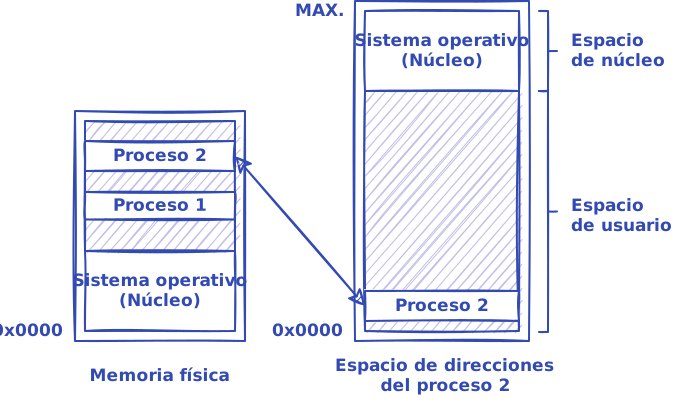
En lugar de eso el sistema operativo —asistido por la MMU (Memory-Management Unit)— proporciona a cada proceso un espacio de direcciones virtual. Cada proceso obtiene así una «vista» privada de la memoria, similar a la que tendría si se estuviera ejecutando en solitario (ver la figura anterior). Es durante los accesos a la memoria principal en tiempo de ejecución cuando estas direcciones virtuales son convertidas por la MMU en las direcciones físicas, con las que realmente se accede a la memoria. El espacio de direcciones físico es el conjunto de direcciones físicas que corresponden a todas las direcciones virtuales de un espacio de direcciones virtual dado.
El mecanismo de protección descrito es una forma muy común de reubicación de las direcciones en tiempo de ejecución, que está presente en la mayor parte de los sistemas operativos de propósito general modernos. Pero, aparte de la protección de la memoria, algunas otras características de dicho mecanismo son:
-
Los procesos pueden ser cargados en cualquier zona libre de la memoria física e incluso movidos de una región a otra durante la ejecución, puesto que la transformación de las direcciones virtuales en direcciones físicas se realiza durante la ejecución de cada instrucción.
-
El código generado por el compilador puede ser código absoluto, puesto que de antemano se sabe que todas las ubicaciones del espacio de direcciones virtual van a estar disponibles. Lo común es que los programas se ubiquen en una dirección fija en la parte baja del espacio de direcciones virtual. Por ejemplo, empezando en la dirección
0x00400000, dejando libres los primeros 4 MiB del espacio de direcciones virtual. -
Se puede reducir el consumo de memoria principal compartiendo las regiones de memoria física asignadas al código y los datos de solo lectura de los procesos de un mismo programa.
El código de un programa suele contener direcciones tanto para los saltos como para el acceso a los datos. Al ubicar los programas en las mismas regiones de los espacios de direcciones virtuales de sus procesos, el código en memoria de todos los procesos de un mismo programa resulta idéntico, porque todos usan las mismas direcciones virtuales absolutas. Por eso se puede compartir la memoria física que ocupan.
Extra Direcciones en ejecutables en Linux x86-64
Sección titulada « Direcciones en ejecutables en Linux x86-64»En Linux cada proceso tiene su propio espacio de direcciones virtual, por lo que los ejecutables pueden generarse para ser cargados en una dirección fija, ya que es seguro que no habrá otro ocupando la misma dirección.
Si la dirección donde se va a ejecutar el programa puede fijarse de antemano, los ejecutables pueden contener código absoluto. Por eso en Linux x86-64 el enlazador coge el código objeto que va a formar parte del ejecutable, lo reubica asumiendo que el ejecutable se cargará en cierta dirección de la memoria y genera un ejecutable con código absoluto, sin tablas de reubicación.
Por ejemplo, si compilamos completamente el test.c anterior y preguntamos por la tabla de reubicación, veremos que está vacía:
$ gcc -o test test.c$ objdump -r test
test:     file format elf64-x86-64
Si desensamblamos el código, veremos que han cambiado algunas cosas en main() y en test() respecto a lo que había en el código objeto.
$ objdump -d test
test:     file format elf64-x86-64

Disassembly of section .text:
...
0000000000001129 <test>:    1129:       f3 0f 1e fa             endbr64    112d:       55                      push   %rbp    112e:       48 89 e5                mov    %rsp,%rbp    1131:       48 c7 05 d4 2e 00 00    movq   $0xc,0x2ed4(%rip)        # 4010 <i>    1138:       0c 00 00 00    113c:       b8 00 00 00 00          mov    $0x0,%eax    1141:       5d                      pop    %rbp    1142:       c3                      ret
0000000000001143 <main>:    1143:       f3 0f 1e fa             endbr64    1147:       55                      push   %rbp    1148:       48 89 e5                mov    %rsp,%rbp    114b:       48 c7 05 ba 2e 00 00    movq   $0xb,0x2eba(%rip)        # 4010 <i>    1152:       0b 00 00 00    1156:       b8 00 00 00 00          mov    $0x0,%eax    115b:       e8 c9 ff ff ff          call   1129 <test>    1160:       5d                      pop    %rbp    1161:       c3                      ret
...- Las instrucciones que acceden a la variable
iahora tienen el desplazamiento adecuado respecto al contador de programarippara acceder a dicha variable. - La instrucción de salto tiene un desplazamiento que sumado al valor de
riplleva directamente al comienzo del código de la funcióntest().
Enlazado dinámico y librerías compartidas
Sección titulada «Enlazado dinámico y librerías compartidas»Como hemos comentado anteriormente, fundamentalmente existen dos tipos de enlazado:
-
En el enlazado estático, las librerías del sistema y otros módulos son combinados por el enlazador para formar la imagen binaria del programa que es almacenada en disco. Algunos sistemas operativos —como MS-DOS— solo soportan este tipo de enlazado.
-
En el enlazado dinámico, este se pospone hasta la carga o la ejecución (ver la figura de las etapas de un programa).
Generalmente el enlazado dinámico ocurre durante la carga del programa:
- Durante la carga del ejecutable se comprueban las dependencias del mismo. Estas se almacenan en el mismo archivo en disco que dicho ejecutable.
- Las librerías a enlazar se cargan y ubican en el espacio de direcciones virtual creado para el nuevo proceso.
- Finalmente, las referencias del programa a las funciones de cada una de las librerías cargadas se actualizan con la dirección en memoria de las mismas. Así la invocación de las funciones por parte del programa se puede realizar de forma transparente, como si siempre hubieran formado parte del mismo.
Cuando el enlazado se va a realizar en tiempo de ejecución se habla de enlazado dinámico con carga diferida. En ese caso el procedimiento es el siguiente:
- Durante el enlazado estático del ejecutable se pone un stub a cada referencia a alguna función de la librería que va a ser enlazada dinámicamente.
- Si durante la ejecución del programa alguna de dichas funciones es invocada, se ejecuta el stub. El stub es una pequeña pieza de código que sabe cómo cargar la librería, si no ha sido cargada previamente, y cómo localizar la función adecuada en la misma.
- Finalmente, el stub se sustituye a sí mismo con la dirección de la función y la invoca. Esto permite que la siguiente ejecución de la función no incurra en ningún coste adicional.
Sin esta habilidad, cada programa en el sistema debería tener, por ejemplo, una copia de la librería del sistema incluida en su ejecutable. Esto significa un desperdicio de espacio libre en disco y de memoria principal. Además, este esquema facilita la actualización de las librerías, puesto que los programas pueden utilizar directamente las versiones actualizadas sin necesidad de volver a ser enlazados.
Reubicación de las direcciones
Sección titulada «Reubicación de las direcciones»Durante la compilación de una librería dinámica no se conoce la región que va a ocupar, dentro de los espacios de direcciones virtuales de los distintos procesos que la van a utilizar, por lo que es necesario generar código reubicable.
Atendiendo a lo visto en «Reubicación en tiempo de carga» existen fundamentalmente dos estrategias:
-
El compilador puede generar código independiente de la posición (PIC). Esto permite reducir el consumo de memoria principal compartiendo las regiones de memoria física asignadas al código de una misma librería en los distintos procesos que la utilizan, pues en todas el código será exactamente el mismo.
-
En los sistemas operativos donde no se usa código PIC, el compilador debe generar código reubicable con tablas de reubicación, para que la reubicación de las direcciones virtuales se haga en tiempo de carga. Esto aumenta el tiempo de carga de las librerías y solo permite que compartan memoria física partes de la librería que sigan siendo iguales tras la reubicación de las direcciones.
Librerías compartidas
Sección titulada «Librerías compartidas»Habitualmente las librerías incluyen información acerca de su versión. Esta información puede ser utilizada para evitar que los programas se ejecuten con versiones incompatibles de las mismas, o para permitir que haya más de una versión de cada librería en el sistema. Así los viejos programas se pueden ejecutar con las viejas versiones de las librerías —o con versiones actualizadas aunque compatibles— mientras los nuevos programas se ejecutan con las versiones más recientes e incompatibles con los viejos programas.
A este sistema se lo conoce como librerías compartidas.
Para establecer correctamente la compatibilidad entre librerías y programas, es conveniente y bastante común que los desarrolladores de las librerías compartidas utilicen versionado semántico. El versionado semántico es un convenio por el cual el número de versión suele venir indicado por tres números separados por puntos —como, por ejemplo, 5.3.4— de tal forma que:
-
El primer número es incrementado cuando ocurre un cambio drástico en la librería, de tal forma que seguramente los programas hechos para versiones anteriores no van a ser compatibles con la nueva versión.
-
El segundo número es incrementado cuando se añade alguna nueva característica o se modifica alguna ya existente, pero el cambio no debe romper los programas hechos para la versión anterior.
-
El último número es incrementado al corregir errores, pero no se rompe la compatibilidad con versiones previas.
De esta forma, los desarrolladores pueden enlazar sus programas contra la versión 5 de la librería, sabiendo que funcionarán con cualquier versión actualizada o corregida, como la 5.1, la 5.2.9 o la 5.10.1. En cambio, nunca se ejecutarán con versiones que traen cambios mayores y posiblemente incompatibles, como la 6.1 o la 2.10.
Extra Enlazado dinámico en Linux x86-64
Sección titulada « Enlazado dinámico en Linux x86-64»Volviendo al programa de ejemplo test.c, podemos obtener fácilmente las librerías compartidas de las que depende usando el comando :
$ ldd testlinux-vdso.so.1 (0x00007fffd833e000)libc.so.6 => /lib/x86_64-linux-gnu/libc.so.6 (0x00007f47c20c9000)/lib64/ld-linux-x86-64.so.2 (0x00007f47c22cf000)- El ejecutable tiene que estar enlazado con la librería del sistema —llamada
libcen los sistemas POSIX— para que pueda acceder a los servicios del sistema.libc.so.6es el nombre por el que se buscará el archivo que contiene la librería compartida de la librería del sistema. Si se hubiera usado solamentelibc.so, el ejecutable podría intentar usar cualquier versión delibc, pero al incluir el primer número de versión en el nombre, nos aseguramos de que el ejecutable solo usará versiones 6 de la librería del sistema. Así se evita ejecutar el programa con versiones que pueden ser incompatibles. - La librería ld.so() se encarga de las cuestiones relacionadas con el enlazado y la carga dinámica de librerías.
Si estas librerías no estuvieran disponibles al intentar ejecutar el programa, la ejecución fallaría, ya que son un requisito obligatorio. Sin embargo, el enlazado dinámico no es algo que solo pueda configurarse durante la compilación para que ocurra automáticamente durante la carga del ejecutable. Los sistemas operativos modernos proporcionan funciones para que un proceso pueda cargar y descargar cualquier librería durante la ejecución y acceder a sus variables e invocar sus funciones. En los sistemas POSIX estas funciones las proporciona la librería ld.so().
Esto es muy útil cuando se quiere que ciertas librerías sean opcionales. Es decir, que no sea necesario tenerlas instaladas en el sistema donde se va a ejecutar el programa, de tal forma que si no están disponibles, el programa funcione con normalidad, pero si están instaladas, el programa aproveche la funcionalidad adicional que proporcionan. Así es como navegadores, editores y otros programas implementan extensiones y plugins, con los que el usuario puede extender la funcionalidad del programa original sin recompilarlo. Estas extensiones generalmente se implementan como librerías compartidas que el programa busca y carga durante su ejecución.
Por lo general, la mayor parte de las librerías que usan los programas son enlazadas dinámicamente, pero el enlazador siempre tiene que incluir en el ejecutable algunas librerías enlazadas estáticamente que son importantes para la ejecución del programa.
Por eso al ejecutar objdump -d test vemos funciones que no estaban ni en test.c ni en el archivo de código objeto test.o.
La librería que vemos incluida en el ejecutable es la librería de tiempo de ejecución de C.
Todo lenguaje de programación —excepto ensamblador, obviamente— necesita incluir en sus ejecutables una librería de tiempo de ejecución o librería de runtime con rutinas de bajo nivel que sirven de apoyo para implementar algunas características del lenguaje y del entorno de ejecución.
En Linux y otros sistemas POSIX, la posición donde debe iniciarse la ejecución se marca con la etiqueta _start en el ejecutable.
Se trata de código de la librería de tiempo de ejecución que inicializa el entorno que espera el programa en C, obtiene del sistema operativo los argumentos de la línea de comandos e invoca a la función main() de nuestro programa con ellos.
Otras funcionalidades que típicamente implementa la librería de tiempo de ejecución son operaciones básicas de gestión de la memoria, manejo de excepciones, comprobaciones de límites en los arrays o comprobaciones dinámicas de tipos —por ejemplo, para implementar el operador dynamic_cast en C++—.
Finalmente, no debemos confundir la librería de tiempo de ejecución con la librería estándar. En lenguajes como C o C++ se distingue claramente entre lo que es el lenguaje de programación y la librería estándar que suele acompañarlos. En ese sentido, la librería de tiempo de ejecución implementa lo mínimo requerido para la ejecución de programa en esos lenguajes. Mientras que si además queremos usar funcionalidades de su librería estándar, también tendremos que enlazarla, generalmente de forma dinámica.
Asignación contigua de memoria
Sección titulada «Asignación contigua de memoria»Como vimos en «Protección de la memoria», la memoria principal debe acomodar tanto al sistema operativo como a los diferentes procesos de los usuarios.
Normalmente queremos tener varios procesos en la memoria al mismo tiempo. Por tanto, necesitamos considerar de qué formas debemos asignar la memoria disponible a los procesos para que puedan ser cargados en ella. En este apartado estudiaremos la técnica más simple, denominada asignación contigua de memoria. Mientras que en capítulos posteriores veremos técnicas más avanzadas de hacer esta asignación.
En la asignación contigua de memoria a cada proceso se le asigna una única sección de memoria contigua. Esto se puede hacer mediante particionado fijo o particionado dinámico.
Particionado fijo
Sección titulada «Particionado fijo»En el particionado fijo la memoria se divide en varias secciones de tamaño fijo, cada una de las cuales contiene un proceso. Cuando un proceso termina, se carga uno nuevo de la cola de entrada en la partición libre.
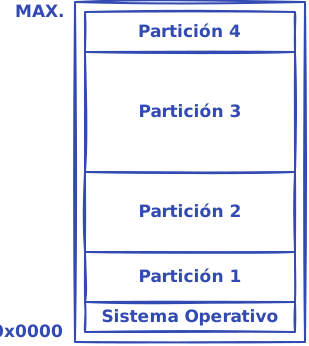
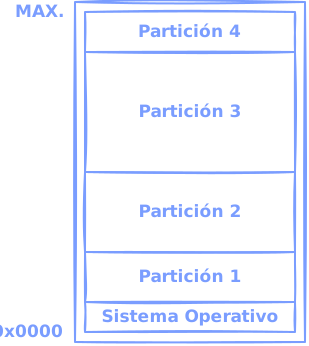
Este método fue utilizado originalmente por el IBM, pero ya no se utiliza.
Particionado dinámico
Sección titulada «Particionado dinámico»El particionado dinámico es una generalización del anterior:
- El sistema operativo mantiene una tabla indicando qué partes de la memoria están libres y cuáles ocupadas. Inicialmente toda la memoria está libre por lo que es considerada como un gran hueco de memoria disponible.
- Cuando un proceso llega y necesita memoria, se le busca un hueco lo suficientemente grande para alojarlo. Si se encuentra, solo se le asigna el espacio necesario, que es marcado como ocupado. El resto sigue siendo un hueco libre, aunque de menor tamaño.
- Si un proceso termina y se crean dos huecos adyacentes, se funden en uno solo.
El particionado dinámico se utilizaba fundamentalmente en sistemas de procesamiento por lotes y multiprogramados. En este último caso, el sistema operativo tenía una cola de entrada ordenada por el planificador de largo plazo y la recorría asignando memoria a los procesos, hasta que no quedara ningún hueco libre con tamaño suficiente para alojar al siguiente en la cola. Entonces el sistema operativo tenía dos opciones. Una era esperar a que terminaran algunos procesos y quedara un hueco lo bastante grande para el siguiente; la otra, seguir buscando en la cola de entrada procesos de menores requisitos, aunque para ello tuviera que saltarse a algunos.
En general, en un momento dado el sistema operativo debe satisfacer una petición de tamaño con una lista de huecos libres de tamaño variable. Esto no es más que un caso particular del problema clásico de la asignación dinámica de almacenamiento, para el cual hay diversas soluciones:
-
En el primer ajuste se escoge el primer hueco lo suficientemente grande como para satisfacer la petición. La búsqueda puede ser desde el principio de la lista o desde donde ha terminado la búsqueda anterior.
-
En el mejor ajuste se escoge el hueco más pequeño que sea lo suficientemente grande para satisfacer la petición. Indudablemente esto obliga a recorrer la lista de huecos completa o a tenerla ordenada por tamaño.
-
En el peor ajuste se escoge el hueco más grande. Igualmente obliga a buscar en toda la lista de huecos o a tenerla ordenada por tamaño.
Para evaluar qué estrategia es la mejor, se han realizado algunas simulaciones con los siguientes resultados:
-
El primer y el mejor ajuste son mejores que el peor ajuste en términos de menor tiempo y mayor aprovechamiento del espacio de almacenamiento.
-
Si comparamos el primer y el mejor ajuste, ninguno de ellos destaca sobre el otro en lo que a mejor aprovechamiento del espacio se refiere.
-
El primer ajuste es normalmente más rápido que el mejor ajuste.
Fragmentación
Sección titulada «Fragmentación»Las estrategias de asignación de espacio de almacenamiento generalmente sufren de problemas de fragmentación. Vamos a comentar brevemente cómo afecta la fragmentación a la asignación contigua de memoria.
Fragmentación externa
Sección titulada «Fragmentación externa»La fragmentación externa ocurre cuando hay suficiente espacio libre para satisfacer una petición, pero el espacio no es contiguo. Es decir, el espacio de almacenamiento está fraccionado en un gran número de huecos de pequeño tamaño:
-
Afecta tanto a la estrategia del primer ajuste como a la del mejor ajuste, siendo la primera mejor en algunos sistemas y la segunda mejor en otros.
-
Algunos análisis estadísticos realizados con el primer ajuste revelan que incluso con algunas optimizaciones, con bloques asignados se pierden por fragmentación externa —es decir, un tercio de toda la memoria no es utilizable—. A esto se lo conoce como la regla del 50 %.
Existen diversas soluciones a este problema:
-
Utilizar técnicas de compactación, lo que consiste en mover los procesos para que toda la memoria libre quede en un único hueco de gran tamaño. Sin embargo, esto puede ser muy caro en términos de tiempo y solo puede ser realizado cuando la asignación de direcciones absolutas se realiza en tiempo de ejecución.
-
La otra solución es permitir que el espacio de direcciones físico de un proceso no sea contiguo. Es decir, que la memoria pueda ser asignada a un proceso independientemente de dónde esté disponible. Existen dos técnicas complementarias que utilizan esta solución: la paginación y la .
Fragmentación interna
Sección titulada «Fragmentación interna»La fragmentación interna se origina por la diferencia entre el espacio solicitado y el espacio finalmente asignado.
Supongamos un hueco de espacio libre de 12 987 bytes que se va a usar para satisfacer una petición de 12 985 bytes. Esto genera un hueco de 2 bytes, pero la cantidad de información que debemos guardar en la lista de huecos para saber que dicho hueco está ahí es mucho mayor que el tamaño del hueco en sí mismo. Por lo tanto, no nos interesa tener huecos de tamaño arbitrario.
La solución más común es dividir la memoria física en unidades de tamaño fijo y asignarla en múltiplos del tamaño de dichos bloques. Esto hace que, en general, se asigne más memoria de la que realmente se ha solicitado y, por tanto, de la que realmente los procesos van a utilizar.
Intercambio
Sección titulada «Intercambio»Un proceso debe estar en la memoria para ser ejecutado. Sin embargo, algunos sistemas operativos pueden sacarlo temporalmente y copiarlo a un almacenamiento de respaldo, generalmente un dispositivo de almacenamiento secundario como un disco. Más adelante lo traen de vuelta a la memoria para que continúe su ejecución. Al procedimiento descrito se lo denomina intercambio o swapping.
Implementación
Sección titulada «Implementación»El intercambio se puede implementar de la siguiente manera:
- La cola de preparados contiene todos los procesos que esperan para ser ejecutados en la CPU.
- Cuando el planificador de la CPU decide ejecutar un proceso, llama al asignador.
- El asignador comprueba si el siguiente proceso que debe ser ejecutado está en la memoria. Si no lo está y no hay memoria libre, el asignador hace que el gestor de la memoria intercambie el proceso con alguno de los que sí lo está.
- Finalmente, el asignador ejecuta el resto del cambio de contexto para entregar la CPU al proceso seleccionado.
Por ejemplo, si a un sistema con planificación de CPU basada en prioridad llega a la cola de preparados un proceso de alta prioridad, el gestor de memoria intercambia algunos procesos de baja prioridad con el de alta prioridad y ejecuta este último. Cuando el proceso de alta prioridad termina, los de baja prioridad pueden ser intercambiados para continuar su ejecución.
Limitaciones
Sección titulada «Limitaciones»Sin embargo, el intercambio presenta algunas limitaciones importantes:
-
Si un sistema reubica las direcciones en tiempo de compilación o carga, el proceso solo puede ser intercambiado en la misma región de la memoria. Sin embargo, si se utiliza reubicación en tiempo de ejecución, entonces el proceso puede ser intercambiado en cualquier región de la memoria, puesto que las direcciones físicas son calculadas durante la ejecución.
-
El tiempo de cambio de contexto en un sistema con intercambio puede ser mucho mayor, puesto que incluye el tiempo que se tarda en hacer el intercambio. La mayor parte del tiempo de intercambio es el tiempo de transferencia con el disco, que puede ser de varios cientos de milisegundos, incluso utilizando los discos más rápidos. Esto afecta al tiempo de cuanto, que siempre debe ser mucho mayor que el tiempo de cambio de contexto.
-
Un proceso podría disponer de un espacio en memoria de 120 MiB pero estar utilizando solo 2 MiB. Por tanto, es interesante que el sistema operativo conozca con exactitud la memoria utilizada por el proceso —y no la que podría estar utilizando como máximo— para reducir el tiempo de transferencia de los datos al disco durante el intercambio. Para eso, el sistema operativo proporciona llamadas al sistema con las que un proceso con requerimientos dinámicos de memoria puede informar del cambio en su necesidad de memoria. Por ejemplo, los sistemas operativos modernos proporcionan llamadas al sistema para reservar y liberar memoria —como malloc() y free() en los sistemas POSIX— gracias a las que el sistema conoce las necesidades reales de los procesos.
-
El intercambio presenta dificultades cuando el proceso que va a ser sacado de la memoria está esperando por una operación de E/S que accede a la memoria del proceso para leer o escribir datos en ella. Las soluciones podrían ser:
-
No intercambiar procesos con operaciones de E/S síncronas o asíncronas pendientes.
-
Utilizar búferes del sistema operativo en las operaciones de E/S. Por ejemplo, en una operación de escritura a un archivo, el sistema operativo copiaría primero los datos a un búfer interno y luego ordenaría la escritura de esos datos. Así el proceso podría ser intercambiado sin problemas. Las transferencias entre los búferes del sistema y la memoria de los procesos serían realizadas, por el sistema operativo, solo cuando los procesos residen en la memoria.
-
Debido fundamentalmente a que el tiempo de intercambio es muy alto, no se utiliza el intercambio estándar en los sistemas operativos actuales. Lo que sí podemos encontrar en muchos sistemas son versiones modificadas de este mecanismo.
Por ejemplo, en muchas versiones antiguas de UNIX el intercambio permanecía desactivado y solo se activaba cuando la cantidad de memoria usada superaba cierto límite. Además, en los sistemas actuales no se intercambian procesos completos sino las porciones menos usadas de cada proceso, como veremos en «Memoria virtual».
Referencias de las API
Sección titulada «Referencias de las API»Lenguaje C
Libera memoria previamente asignada con malloc(), calloc() o realloc().
void free(void* ptr);Punto de entrada de un programa C. Recibe los argumentos de la línea de comandos.
int main(int argc, char* argv[]);