
20. Implementación de sistemas de archivos
Estructuras con las que se implementan los directorios, métodos de asignación de espacio a los archivos, gestión del espacio libre, sistemas de archivos virtuales y planificación del acceso a disco.
Como ya hemos comentado, un sistema de archivos suele estar compuesto de varios niveles diferentes. En la figura de la estructura de un sistema de archivos se muestra un ejemplo de la estructura de un sistema de archivos diseñado en niveles. Cada nivel utiliza las funciones de los niveles inferiores y proporciona nuevas funciones a los niveles superiores. El papel de cada uno de estos niveles fue descrito en «Estructura de un sistema de archivos». Mientras que las estructuras de metadatos utilizadas, tanto en la memoria como en disco, fueron tratadas brevemente en «Estructuras de metadatos en disco» y en «Estructuras de metadatos en memoria».
A continuación vamos a profundizar aún más en las estructuras y operaciones utilizadas para implementar los sistemas de archivos.
Implementación de directorios
Sección titulada «Implementación de directorios»Cada directorio suele contener una estructura de datos que relaciona el nombre de cada archivo que contiene con el identificador de su FCB. Dicho identificador permite localizar el FCB en la tabla de contenidos del volumen, que contiene el resto de los atributos del archivo.
En esta sección vamos a estudiar las formas más comunes de implementar la estructura de datos de un directorio.
Lista lineal
Sección titulada «Lista lineal»El método más simple para implementar un directorio consiste en utilizar una lista lineal o vector de nombres de archivos e identificadores del FCB.
Las acciones a realizar, para implementar cada una de las posibles operaciones sobre el directorio, serían:
-
Crear un archivo. Primero se explora el directorio para estar seguros de que no haya ningún archivo con el mismo nombre. Después se añade una nueva entrada al final del directorio.
-
Borrar un archivo. Primero se explora la lista en busca del archivo especificado y, una vez localizada, se libera la entrada correspondiente. Para reutilizar la entrada del directorio tenemos diversas alternativas:
- Se puede marcar la entrada como no utilizada. Para eso se puede emplear un nombre especial o utilizar algún campo adicional —aparte de nombre de archivo e identificador del FCB— que se haya añadido a la entrada con ese propósito.
- Insertar un puntero a la entrada en una lista de entradas libres, que se guarda dentro del mismo directorio.
- Copiar la última entrada del directorio en la ubicación que ha quedado libre y reducir la longitud del directorio.
La principal desventaja de un directorio implementado como una lista lineal de entradas es que para localizar un archivo es necesario realizar una búsqueda lineal, lo cual puede resultar muy costoso en directorios con un número muy grande de archivos. Utilizando una lista ordenada se puede reducir el tiempo medio de búsqueda, pero complica los procesos de creación y borrado, pues puede que sea necesario mover cantidades importantes de información para mantener la lista ordenada.
También se puede utilizar una lista enlazada, tanto para reducir el tiempo necesario para borrar un archivo como para facilitar la tarea de mantener ordenada la lista.
Los sistemas de archivos y implementan los directorios utilizando una lista lineal, donde en cada entrada se almacena el nombre del archivo y el FCB del mismo.
Al borrar un archivo, la entrada correspondiente se marca poniendo 0xE5 en el primer carácter del nombre del archivo.
Los sistemas de archivos y también utilizan una lista lineal no ordenada, donde solo se almacena el nombre del archivo o subdirectorio y el identificador del inodo —el FCB en esos sistemas de archivos— correspondiente. En caso de borrar un archivo, el identificador del inodo se pone a 0.
Tabla de dispersión
Sección titulada «Tabla de dispersión»En los directorios implementados con una tabla de también se almacenan las entradas de directorio en una lista lineal, pero al mismo tiempo se utiliza una tabla de dispersión para reducir enormemente el tiempo de búsqueda en el directorio. Para obtener la ubicación de dicho archivo dentro de la lista lineal, se usa un índice calculado con cierta función de dispersión a partir del nombre del archivo.
El único inconveniente es que debemos tratar la posible aparición de colisiones, que son aquellas situaciones en las que dos nombres de archivo dan lugar, al aplicarles la función de dispersión, a la misma ubicación en la tabla. Esto se puede resolver con una lista enlazada en cada entrada, donde cada una señala la ubicación de la siguiente que tiene el mismo valor de la función de dispersión. El precio es que las búsquedas se vuelven un poco más lentas. En cualquier caso, este método será normalmente más rápido que una búsqueda lineal por todo el directorio.
Árbol B
Sección titulada «Árbol B»Para mantener el directorio ordenado, algunos sistemas de archivos modernos utilizan estructuras de datos en árbol más sofisticadas, como por ejemplo árboles B.
Un caso concreto es el sistema de archivos , utilizado por Microsoft Windows. NTFS utiliza una estructura de datos denominada árbol para almacenar el índice de los nombres de archivo contenidos en un directorio.
En la entrada en la MFT (Master File Table) de cada directorio se almacena un atributo denominado raíz del índice. Si el directorio es de pequeño tamaño, la raíz del índice contiene todas las entradas de archivos del directorio, pero para un directorio de gran tamaño, la raíz del índice solo puede almacenar unas pocas entradas de archivos del directorio. En ese caso la raíz del índice contiene el nivel superior del árbol B+. Es decir, cada una de esas entradas de archivos en la raíz del índice incluye también un puntero al bloque del disco que contiene un nodo del árbol con las entradas con nombres alfabéticamente anteriores a ese. Si en dicho nodo tampoco caben todas las entradas, solo podrá contener algunas de ellas, por lo que cada una tendrá, a su vez, un puntero a un nuevo nodo del árbol; y así sucesivamente.
Las ventajas de los árboles B+ son:
- Eliminan el coste de reordenar las entradas del directorio.
- La longitud desde la raíz del árbol hasta un nodo hoja es la misma para todos los caminos por el árbol, por lo que el tiempo de búsqueda tiene una cota superior.
Extra Implementación de directorios en XFS
Sección titulada « Implementación de directorios en XFS»El sistema de archivos también utiliza un árbol, pero en este caso la implementación es un poco más compleja.1
-
Un directorio de pequeño tamaño almacena sus entradas como una lista lineal no ordenada dentro de su mismo inodo o FCB.
-
Cuando el directorio no cabe en el inodo se le asigna un bloque propio, donde el directorio es implementado con una tabla de dispersión, tal y como hemos visto anteriormente.
-
Cuando el tamaño del directorio excede el tamaño del bloque, la tabla de dispersión se extrae y se almacena en un bloque diferente. La lista lineal también se extrae, pero no tiene que ser almacenada en un único bloque, sino que puede estar repartida por distintos bloques a lo largo del disco.
-
Finalmente, cuando la tabla de dispersión excede el tamaño de un bloque, dicha tabla se convierte en un árbol B+.
Métodos de asignación
Sección titulada «Métodos de asignación»El siguiente problema es cómo asignar el espacio disponible en el disco a los archivos almacenados, de forma que el espacio sea utilizado de forma eficiente y que se pueda acceder a los archivos de la forma más rápida posible.
Como la unidad mínima de asignación de espacio a un archivo es el bloque, la fragmentación interna suele ser un problema común a todos los métodos que veremos a continuación.
Asignación contigua
Sección titulada «Asignación contigua»La asignación contigua requiere que cada archivo ocupe un conjunto contiguo de bloques en el disco. Esto es muy eficiente, puesto que el acceso a todos los datos de un archivo requiere un movimiento mínimo del cabezal del disco.
El problema de la asignación contigua puede verse como un caso concreto del problema de la asignación dinámica del almacenamiento. Es decir, que en un momento dado tendremos una petición de tamaño que deberemos satisfacer con una lista de huecos libres de tamaño variable. Como estudiamos anteriormente, las estrategias más comunes son las del primer ajuste y el mejor ajuste.
Fragmentación externa
Sección titulada «Fragmentación externa»La asignación contigua sufre el problema de la fragmentación externa. La solución sería utilizar alguna forma de compactación para unir los huecos libres, pero esto puede llevar mucho tiempo en discos duros de gran tamaño y en algunos sistemas esta tarea tiene que realizarse con el dispositivo desmontado. Por eso es conveniente evitar utilizar técnicas de compactación en los sistemas en producción.
Afortunadamente, la mayor parte de los sistemas operativos modernos que necesitan mecanismos de desfragmentación pueden realizar esta tarea sin detener el sistema, aunque la pérdida de rendimiento puede ser significativa.
Estimación del tamaño del archivo
Sección titulada «Estimación del tamaño del archivo»En la asignación contigua es necesario determinar cuánto espacio necesita un archivo antes de asignárselo. El problema es que eso no siempre es posible.
Por ejemplo, si vamos a copiar un archivo, es indudable que conocemos de antemano cuánto espacio necesita la copia. Pero ¿qué ocurre cuando vamos a crear uno nuevo? Entonces al crear un archivo es necesario que el usuario haga una estimación del espacio que va a necesitar y se la indique al sistema.
¿Y si la estimación no es correcta o posteriormente queremos añadir nuevos datos al archivo? Entonces, lo más probable es que el espacio situado a ambos lados del archivo ya esté ocupado, si hemos utilizado la estrategia del mejor ajuste. Para resolver este problema existen dos estrategias:
-
La primera es terminar el programa de usuario, emitiendo un error. Entonces, el usuario deberá volver a crear el archivo indicando más espacio y volver a ejecutar el programa. Puesto que las ejecuciones repetidas pueden ser muy costosas, lo más común es que el usuario acabe sobreestimando el espacio, lo que dará como resultado un desperdicio considerable de espacio.
-
La segunda es buscar un hueco libre de mayor tamaño y copiar el contenido del archivo al nuevo espacio. Esto puede hacerse siempre que exista suficiente espacio, aunque puede consumir bastante tiempo.
Para minimizar estos problemas, se puede implementar un esquema de asignación contigua modificado, donde se asigna inicialmente un bloque contiguo de espacio al archivo y, posteriormente, si dicho espacio resulta no ser lo suficientemente grande, se añade otra área de espacio contiguo denominada extensión.
La ubicación de las extensiones de un archivo se registra en el FCB, guardando la dirección del primer bloque de cada extensión que compone el archivo y el número de bloques que ocupa cada una.
Los sistemas de archivos y utilizan extensiones para optimizar su funcionamiento. El motivo es que cuantos más bloques contiguos sean asignados a un archivo, menos reposicionamientos del cabezal del disco son necesarios para leerlos. En ext4 el espacio se asigna a los archivos en extensiones de hasta 128 MiB, compuestas por bloques, generalmente, de 4 KiB.
Asignación enlazada
Sección titulada «Asignación enlazada»En la asignación enlazada cada archivo es una lista enlazada de bloques de disco, pudiendo estos bloques estar dispersos por todo el disco:
-
Cada entrada de directorio contiene un puntero al primer bloque. En ocasiones, la entrada también incluye un puntero al último, para facilitar añadir nuevos datos al final del archivo.
-
Cada bloque contiene un puntero al bloque siguiente. Por ejemplo, si cada bloque tiene 512 bytes de tamaño y un puntero requiere 4 bytes, los bloques de disco tendrán un tamaño efectivo de 508 bytes.
Este mecanismo resuelve todos los problemas de la asignación contigua y además:
-
No hay fragmentación externa, puesto que puede utilizarse cualquier bloque libre para satisfacer una solicitud de espacio.
-
No es necesario declarar el espacio del archivo en el momento de crearlo, pues el archivo siempre podrá crecer mientras haya bloques libres.
Sin embargo, la asignación enlazada también tiene sus desventajas.
Eficiencia en accesos aleatorios
Sección titulada «Eficiencia en accesos aleatorios»La asignación enlazada solo resulta eficiente en el acceso secuencial a los archivos.
Si necesitamos ir directamente al bloque i-ésimo de un archivo, tendremos que comenzar desde el principio e ir leyendo cada bloque para obtener el puntero que nos indica el siguiente bloque. Es muy posible que esas lecturas deban ir precedidas de un reposicionamiento de los cabezales del disco.
Una solución parcial a esto puede ser guardar en la memoria una caché de las direcciones de los bloques de los archivos accedidos recientemente.
Eficiencia en el uso del espacio de almacenamiento
Sección titulada «Eficiencia en el uso del espacio de almacenamiento»En la asignación enlazada se pierde cierta cantidad de espacio con los punteros.
Si, por ejemplo, un puntero ocupa 4 bytes y un bloque tiene un tamaño de 512 bytes, el 0,78 % del espacio en disco será utilizado para los punteros, en lugar de para almacenar información útil.
La solución para este problema consiste en asignar los bloques en grupos denominados clústeres. Así, el primer bloque de cada clúster solo tendría que almacenar un puntero al siguiente clúster, lo que reduciría la cantidad de espacio desperdiciada en los punteros y mejoraría la eficiencia al reducir el número de reposicionamientos del cabezal del disco. Sin embargo, esto también incrementa el grado de fragmentación interna pues se pierde más espacio cuando un clúster está parcialmente lleno.
Fiabilidad
Sección titulada «Fiabilidad»Teniendo en cuenta que los archivos están enlazados mediante punteros, basta con que uno de esos punteros se pierda o resulte dañado para que parte de un archivo se corrompa.
Extra Asignación enlazada en FAT y FAT32
Sección titulada « Asignación enlazada en FAT y FAT32»Los sistemas de archivos y utilizan una variante del mecanismo de asignación enlazada en la que se emplea una tabla de asignación de archivos o FAT (File-Allocation Table).
La FAT se almacena en una sección al principio del volumen. Contiene una entrada por cada clúster del disco y en cada una guarda el número del siguiente clúster del archivo. Es decir, lo que hace la FAT es agrupar en un solo lugar los punteros de la asignación enlazada.
Eso significa que la FAT es una estructura crítica. Si se corrompe, puede provocar la pérdida de todo el sistema de archivos. Por eso, realmente se almacenan dos copias de la FAT al principio del volumen.
El indexar con clústeres —o grupos de bloques— sirve para ubicar cerca bloques contiguos, pero sobre todo es una decisión de diseño para permitir que los sistemas de archivos FAT puedan gestionar volúmenes más grandes. Por ejemplo, la FAT de MS-DOS 3.0 y posteriores usaba 16 bits para numerar los clústeres —por eso se llamaba FAT16—. Si FAT16 trabaja directamente con bloques y cada bloque tuviera 512 bytes, no podría gestionar volúmenes de más de bytes, es decir, 32 MiB. Sin embargo, trabajando con 64 bloques por clúster, se puede usar para gestionar volúmenes de hasta 2 GiB.
Aunque algunas versiones de Microsoft Windows NT llegaron a admitir 128 e, incluso, 512 bloques por clúster, con clústeres tan grandes la fragmentación interna es un problema.
Por eso —entre otras cosas— Microsoft introdujo FAT32, cuyas entradas son de 32 bits, aunque solo 28 se utilizan para numerar los clústeres. Eso implica poder gestionar más cantidad de clústeres, lo que permite gestionar volúmenes más grandes con clústeres más pequeños y, por tanto, con menor fragmentación interna. Por ejemplo, con 64 bloques por clúster —32 KiB— esos 28 bits alcanzarían para volúmenes de 8 TiB. Sin embargo, el límite real es de 2 TiB, y no lo impone la numeración de clústeres. El sector de arranque anota cuántos sectores tiene el volumen en un campo de 32 bits, así que con sectores de 512 bytes no se pueden direccionar más de bytes. De hecho, Microsoft ha sido tradicionalmente aún más restrictiva. Durante mucho tiempo sus herramientas de formateo no permitieron crear volúmenes FAT32 de más de 32 GiB, aunque Windows sí podía utilizar los creados por otros sistemas.
Como se puede ver en la siguiente figura, en los sistemas de archivos FAT cada entrada de directorio contiene, aparte del nombre del archivo y otros atributos, el número del primer clúster con datos del archivo. La entrada de la FAT indexada según ese número contiene el número del siguiente clúster del archivo. Iterando de esa manera, se pueden conocer los números de todos los clústeres de un archivo, hasta llegar al último, cuya entrada lleva un valor especial que marca el final de la secuencia. Los clústeres libres, por su parte, se indican con un 0 en su entrada.
El uso de la FAT puede provocar un número importante de reposicionamientos del cabezal de disco, debido a que siempre es necesario volver al principio del volumen para leer dicha tabla. Por eso, es muy habitual que el sistema operativo intente mantener una copia de la FAT en la memoria, a modo de caché.
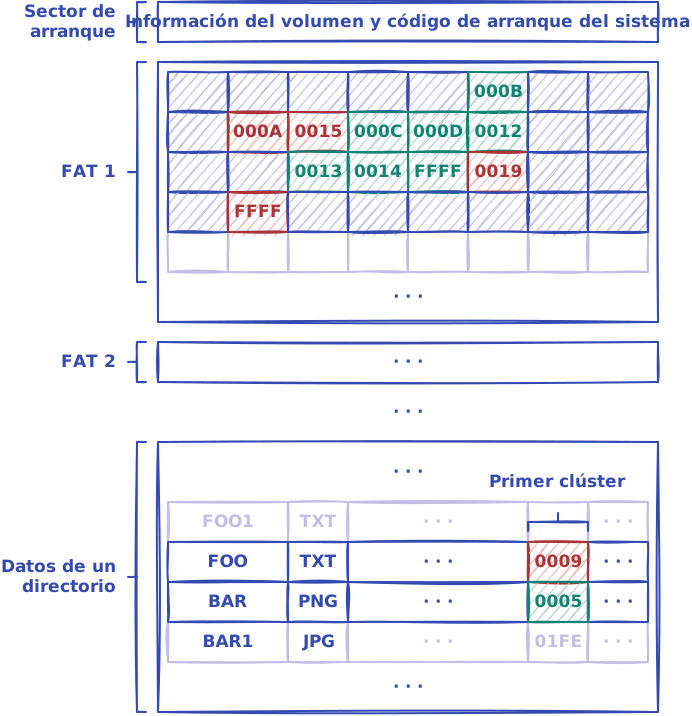
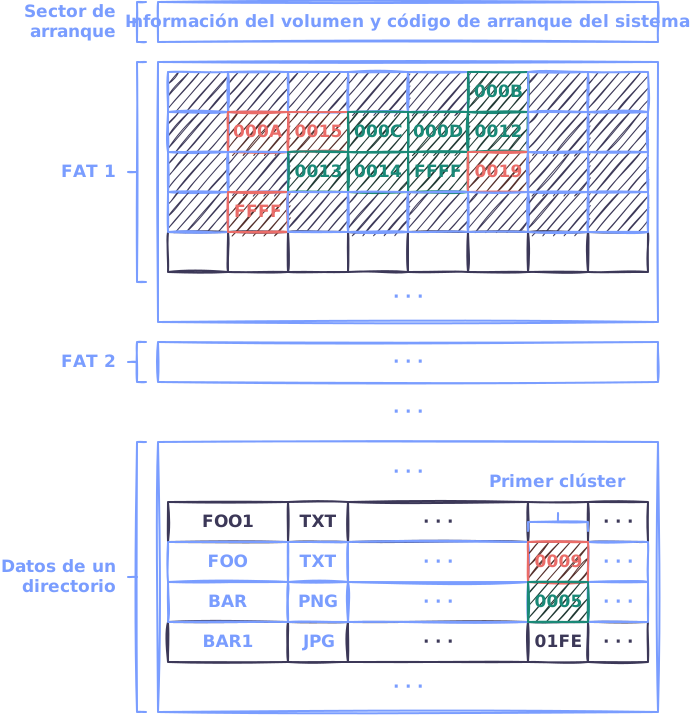
Una de las ventajas de este esquema es que mejora el tiempo de los accesos aleatorios a los archivos, respecto a la asignación enlazada convencional. La ubicación de cualquier bloque se puede conocer a partir de la información de la FAT, sin leer uno a uno todos los bloques del archivo.
Asignación indexada
Sección titulada «Asignación indexada»El mecanismo de asignación indexada agrupa todos los punteros de la asignación enlazada en una única ubicación: el bloque de índices. Así se resuelve la falta de eficiencia de la asignación enlazada convencional —en ausencia de FAT— cuando se realizan accesos aleatorios.
En la asignación indexada:
- Cada archivo tiene su propio bloque de índices, que es un bloque del disco con una tabla con los números de los bloques del disco que contienen los datos del archivo.
- La entrada i-ésima del bloque de índices contiene la dirección del bloque i-ésimo del archivo.
- Cada entrada de directorio contiene la dirección del bloque de índices del archivo correspondiente.
Este mecanismo soporta el acceso aleatorio eficiente, además de no sufrir el problema de la fragmentación externa. Sin embargo, también tiene sus desventajas:
-
Se pierde más espacio en los punteros que con el mecanismo de asignación enlazada, pues siempre hay que reservar un bloque de índices completo para cada archivo. Mientras que con la asignación enlazada, solo se pierde el espacio de los punteros que realmente es necesario utilizar.
-
Al diseñar el sistema de archivos debemos determinar el tamaño del bloque de índices. Por el inconveniente anterior y puesto que cada archivo debe tener un bloque de índices, ese bloque debe ser lo más pequeño posible para no perder espacio. Pero si es demasiado pequeño, no podrá almacenar suficientes punteros para un archivo de gran tamaño.
Entre los mecanismos que pueden utilizarse para resolver este último problema están los siguientes:
-
En el esquema enlazado se enlazan los bloques de índices. Por ejemplo, se puede utilizar el último puntero del bloque de índices para apuntar al siguiente bloque de índices. Si dicho puntero tiene valor 0, entonces estamos en el último bloque de índices del archivo.
-
En el índice multinivel, los punteros del bloque de índices no señalan a los bloques del archivo, sino a un conjunto de bloques de índices de segundo nivel y estos, a su vez, señalan a los bloques del archivo. Esta técnica puede ampliarse utilizando un tercer o cuarto nivel, dependiendo del tamaño máximo de archivo que se desee.
-
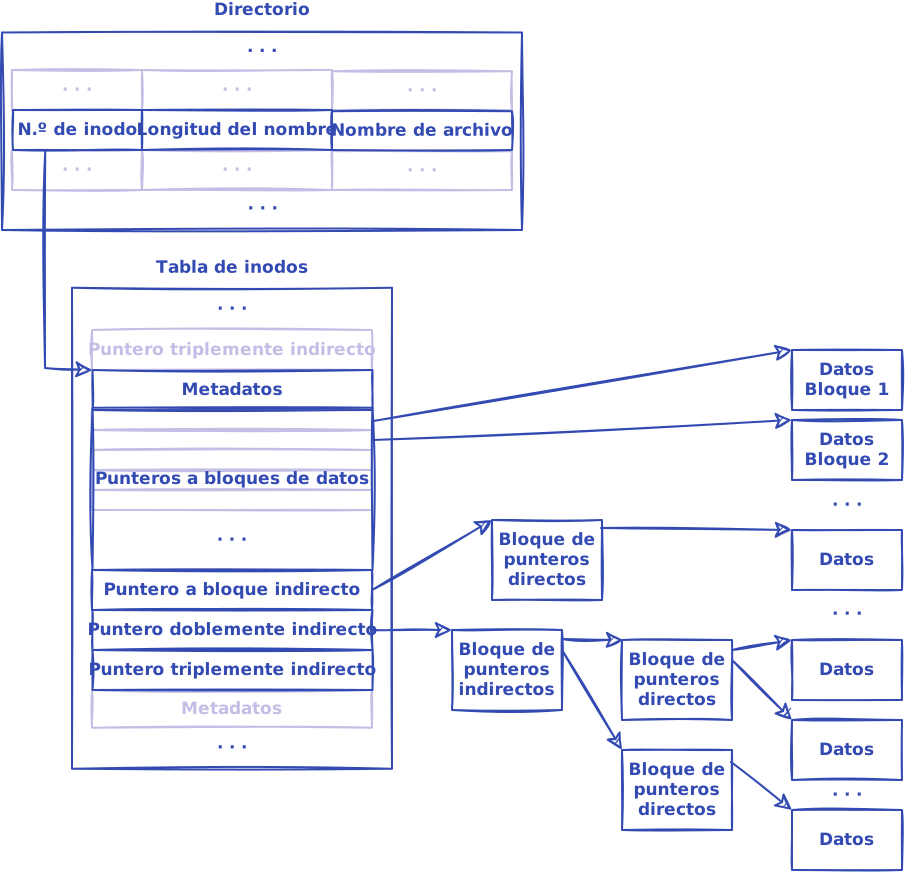
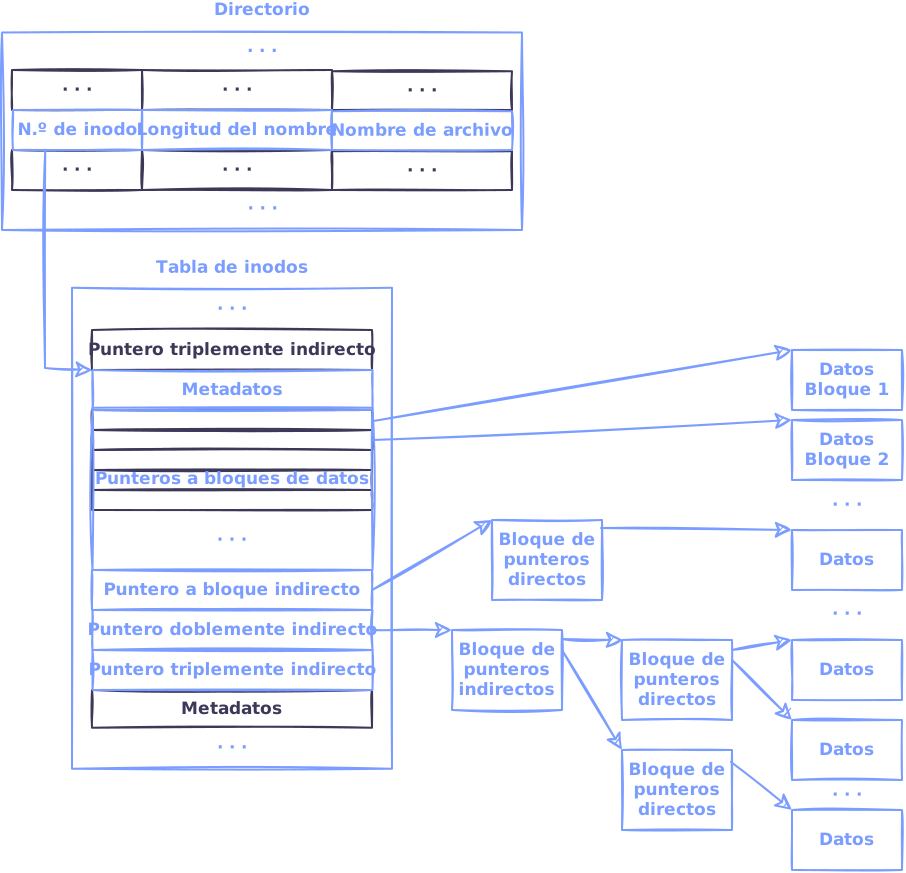
En el esquema combinado las primeras entradas del bloque de índices apuntan directamente a los primeros bloques del archivo. Mientras que las siguientes entradas contienen punteros indirectos, que apuntan a un conjunto de bloques de índices de segundo nivel. Después podría haber entradas que contienen punteros doblemente indirectos y luego entradas con punteros triplemente indirectos.
Para mejorar el rendimiento de los mecanismos de asignación indexados, es muy común que el sistema operativo intente mantener los bloques de índices en la memoria.
Gestión del espacio libre
Sección titulada «Gestión del espacio libre»Puesto que el espacio en disco es limitado, necesitamos poder reutilizar el espacio de los archivos borrados. Para controlar el espacio libre en el disco, el sistema de archivos mantiene una lista de espacio libre que contiene todos los bloques de disco disponibles. Para crear un archivo, se explora la lista de espacio libre hasta obtener la cantidad de espacio requerida y se asigna ese espacio al nuevo archivo.
A continuación estudiaremos las diferentes maneras de implementar esa lista.
Vector de bits
Sección titulada «Vector de bits»La lista de espacio libre puede ser implementada como un vector de bits o mapa de bits, donde cada bloque es representado por un bit. Si el bloque está libre, el bit está a 1, mientras que si el bloque está asignado, el bit está a 0.
Este enfoque es relativamente sencillo y eficiente, puesto que muchos procesadores disponen de instrucciones para manipular bits, que pueden utilizarse para obtener rápidamente el primer bloque libre. Por ejemplo, la familia de procesadores , a partir del Intel, tiene instrucciones que devuelven la posición del primer bit a 1 en el valor de un registro.
Sin embargo, leer el vector de bits, modificarlo y actualizarlo en disco en cada ocasión es tremendamente ineficiente. Por tanto, usar vectores de bits es ineficiente a menos que se mantenga el vector completo en la memoria principal, escribiéndose ocasionalmente en el disco.
Esto último puede ser imposible para los discos de gran tamaño, en función de la cantidad de memoria principal. Por ejemplo, un disco de 40 GiB con bloques de 512 bytes necesitará un mapa de bits de más de 10 MiB, lo que no es un gran requisito para un sistema moderno, pero sí lo era hace dos décadas.
Lista enlazada
Sección titulada «Lista enlazada»Otra técnica consiste en enlazar todos los bloques de disco libres. Para eso se puede guardar un puntero al primer bloque libre en una ubicación especial del disco y que ese bloque contenga un puntero al siguiente bloque libre del disco. El segundo bloque contendría un puntero al tercer bloque libre, y así sucesivamente.
El inconveniente es que recorrer la lista no resulta eficiente, pues tenemos que leer cada bloque para conocer la dirección del siguiente bloque libre en disco. Sin embargo, debemos tener en cuenta que no es frecuente tener que recorrer la lista de espacio libre completa porque, por lo general, basta con encontrar el primer bloque libre para asignar el espacio.
Agrupamiento
Sección titulada «Agrupamiento»Una modificación de la técnica basada en la lista enlazada consiste en almacenar las direcciones de bloques libres en el primer bloque libre. Los primeros de esos bloques estarían realmente libres, pero el último de ellos apuntaría a otro bloque con bloques libres. Así podrían localizarse rápidamente las direcciones de un gran número de bloques libres, lo cual mejora la eficiencia respecto a la técnica de lista enlazada.
Recuento
Sección titulada «Recuento»Generalmente los bloques son asignados o liberados en conjuntos contiguos, especialmente si el espacio es asignado mediante asignación contigua o en extensiones o clústeres. Esto puede ser aprovechado para mantener una lista donde cada entrada almacena la dirección del primer bloque de un conjunto de bloques libres contiguo, así como el número de bloques del conjunto.
Por ejemplo, el sistema de archivos utiliza un árbol B+ para almacenar las direcciones de las extensiones de bloques libres y mantenerlas ordenadas por el tamaño de la extensión a la que apuntan. Así el sistema operativo puede localizar rápidamente el espacio libre necesario para satisfacer una necesidad concreta.
Sistemas de archivos virtuales
Sección titulada «Sistemas de archivos virtuales»En «Montaje de sistemas de archivos» vimos cómo el sistema operativo monta sistemas de archivos de tal forma que aparenten estar integrados en una única estructura de directorios, permitiendo a los usuarios moverse de forma transparente entre distintos dispositivos y tipos de sistemas de archivos. Para hacerlo, un sistema operativo moderno debe ser capaz de soportar de manera eficiente distintos tipos de sistemas de archivos, ocultando sus diferencias de cara a los usuarios.
Un método para implementar múltiples tipos de sistemas de archivos consiste en escribir diferentes rutinas de acceso, manipulación y gestión —de los directorios y archivos— para cada uno de los tipos de sistema de archivos existentes. Sin embargo, en lugar de esta solución, la mayoría de los sistemas operativos utilizan técnicas de programación orientada a objetos para implementar diferentes tipos de sistemas de archivos detrás de una misma interfaz de programación. Es decir, se utilizan estructuras de datos y procedimientos comunes para separar las llamadas al sistema de los detalles de su implementación real, para cada uno de los sistemas de archivos.
La implementación de un sistema de archivos está compuesta de tres niveles fundamentales: la interfaz del sistema de archivos, el sistema de archivos virtual y, finalmente, la implementación real del sistema de archivos.
Interfaz del sistema de archivos
Sección titulada «Interfaz del sistema de archivos»El primer nivel es la interfaz del sistema de archivos, a la que acceden los desarrolladores a través de las llamadas al sistema. En sistemas POSIX, estamos hablando de las llamadas open(), read(), write() y close(), entre otras. Y de los descriptores de archivos con los que se identifican los archivos abiertos.
Esta interfaz es la misma sea cual sea el sistema de archivos al que se esté intentando acceder.
Sistema de archivos virtual
Sección titulada «Sistema de archivos virtual»El segundo nivel es la interfaz del sistema de archivos virtual o VFS (Virtual File System). Este nivel es utilizado por el anterior para atender las peticiones realizadas.
Describe operaciones genéricas sobre cualquier sistema de archivos y estructuras genéricas. Por ejemplo, el FCB virtual, que identifica de forma unívoca a cada archivo o directorio en uso en todo el sistema, dando acceso a sus metadatos.
Este nivel cumple con dos importantes funciones:
-
Separa las operaciones genéricas sobre el sistema de archivos de su implementación. VFS define una interfaz muy clara y común para todos los sistemas de archivos. De esta interfaz existirán diversas implementaciones en el mismo sistema, una para cada sistema de archivos diferente.
-
Proporciona un mecanismo para acceder de forma coherente a los archivos a través de la red. Una implementación de VFS no tiene que estar limitada exclusivamente a ofrecer acceso a archivos en dispositivos conectados físicamente al sistema. Las operaciones de la interfaz VFS pueden implementarse de tal forma que usen un protocolo de acceso a algún servidor de archivos conectado a la red.
Implementación del sistema de archivos
Sección titulada «Implementación del sistema de archivos»El tercer nivel es donde se implementa cada tipo de sistema de archivos o los distintos protocolos de los servidores de archivos en la red. La interfaz VFS recurre a la implementación correspondiente para cada tipo de sistema de archivos, para satisfacer las solicitudes de los niveles superiores.
Así, por ejemplo, un read() puede implicar que se tenga que recuperar el vnodo del archivo involucrado desde la tabla de archivos abiertos, usando el descriptor de archivo indicado en la llamada al sistema.
Después, se invoca la operación VFS read() sobre el vnodo, en la implementación concreta de VFS según el tipo de sistema de archivos involucrado.
Será esa implementación quien extraiga del vnodo la información necesaria —por ejemplo, el inodo real del archivo en el sistema de archivos— para llevar a cabo la operación indicada, según las especificidades del sistema de archivos.
Planificación de disco
Sección titulada «Planificación de disco»Como ya hemos comentado, es responsabilidad del sistema operativo usar los recursos del hardware de forma eficiente. Eso incluye planificar los procesos en la CPU para conseguir el mínimo tiempo de espera posible, o aprovechar de la mejor forma la memoria principal disponible para atender la demanda de todos ellos a la vez. Pero incluye también obtener el menor tiempo de acceso y el mayor ancho de banda posible en el acceso a los discos.
Rendimiento del acceso a disco
Sección titulada «Rendimiento del acceso a disco»En un disco duro magnético el tiempo de acceso al disco viene determinado por el tiempo de búsqueda y la latencia rotacional :
El tiempo de búsqueda es el tiempo que se tarda en mover el brazo del disco hasta el cilindro deseado. Mientras que la latencia rotacional es el tiempo que hay que esperar a que el disco gire hasta que la cabeza llegue al sector deseado del cilindro. Por lo tanto, el tiempo de acceso al disco es menor cuando se realizan accesos consecutivos a sectores físicamente próximos que cuando están dispersos por todo el disco.
El ancho de banda o tasa de transferencia del disco es el total de bytes transferidos en una petición dividido por el tiempo total que transcurre desde la primera solicitud de servicio hasta el final de la última transferencia, con la que se termina de atender la petición. Al considerar todo el tiempo necesario para atender la petición, a más tiempo de acceso al disco menor es el ancho de banda.
En los dispositivos de almacenamiento basados en memorias de estado sólido el tiempo de acceso viene determinado por las características de la memoria —entre otros factores— lo que hace que las diferencias entre accesos secuenciales y accesos aleatorios sean mucho menos significativas.
Cola de E/S al disco
Sección titulada «Cola de E/S al disco»Cuando se solicita una operación de E/S sobre el almacenamiento, si la controladora y la unidad de disco están desocupadas, el sistema operativo puede atender la petición sobre la marcha. Pero si están ocupadas, el sistema operativo almacena la solicitud en una cola de E/S al disco de peticiones pendientes. Cuando se resuelve una solicitud, el sistema operativo escoge otra de la cola y se comunica con el hardware para programar la siguiente petición. La cuestión es: ¿cuál es el orden adecuado para escoger las peticiones de E/S de la cola, si se quiere acceder al disco de la forma más eficaz posible?
Planificación FCFS
Sección titulada «Planificación FCFS»En la planificación FCFS (First Come, First Served) o primero que llega, primero servido la cola de E/S al disco es FIFO. Es decir, que las solicitudes se atienden en orden de llegada.
Es el algoritmo de planificación más simple y es equitativo, en el sentido de que atiende a todos los procesos por igual. Pero, lamentablemente, no proporciona el servicio más rápido en discos duros magnéticos, donde interesa mover el brazo del disco lo menos posible.
Planificación SSTF
Sección titulada «Planificación SSTF»En la planificación SSTF (Shortest Seek Time First) o algoritmo de tiempo de búsqueda más corto, de toda la cola se selecciona la solicitud con el menor tiempo de búsqueda desde la posición actual de la cabeza. Este algoritmo de planificación da servicio primero a las solicitudes cercanas a la posición actual de la cabeza, antes de alejarse para atender otras. El motivo es que el tiempo de búsqueda se incrementa con el número de cilindros que hay que recorrer para llegar a una posición dada.
Aun así, la solución no es óptima, dado que puede provocar inanición de algunas solicitudes, si van llegando constantemente nuevas solicitudes sobre regiones cercanas a donde está actualmente la cabeza del disco.
Planificación SCAN y C-SCAN
Sección titulada «Planificación SCAN y C-SCAN»En la planificación SCAN, algoritmo de exploración o del ascensor, el brazo del disco comienza en un extremo del disco y se mueve hacia el otro, atendiendo solicitudes a medida que pasa por cada cilindro, hasta llegar al otro extremo del disco. En el otro extremo, la dirección de movimiento de la cabeza se invierte para recorrer el disco en sentido inverso, repitiendo el proceso.
Supongamos que las solicitudes se distribuyen de forma uniforme a lo largo del disco. Cuando el brazo llega a un extremo, justo antes de volver, la cantidad de solicitudes acumuladas próximas a ese extremo es bastante menor que en el punto donde comenzó el barrido que acaba de terminar. Entonces ¿por qué no volver a empezar desde ese extremo?
A la variante del SCAN que cuando llega a un extremo vuelve al inicio, para volver a barrer desde allí, sin atender ninguna solicitud por el camino, se la denomina C-SCAN —de Circular SCAN—. Con esta variante el tiempo que tiene que esperar una solicitud para ser atendida es más uniforme que con el algoritmo SCAN original.
Planificación LOOK y C-LOOK
Sección titulada «Planificación LOOK y C-LOOK»En teoría los algoritmos SCAN y C-SCAN hacen que el brazo recorra los cilindros del primero al último, pero normalmente no se suelen implementar así.
Por lo general, cuando en el recorrido del brazo, tras atender una solicitud, se descubre que ya no hay más solicitudes siguiendo la misma dirección, el brazo invierte la dirección sin llegar hasta el extremo del disco.
A estas variantes de SCAN y C-SCAN se las denomina LOOK y C-LOOK, respectivamente.
Planificación N-Step-SCAN, N-Step-LOOK y F-SCAN
Sección titulada «Planificación N-Step-SCAN, N-Step-LOOK y F-SCAN»Los algoritmos N-Step-SCAN y N-Step-LOOK son variantes de los algoritmos SCAN y LOOK, respectivamente, donde se limita a el número de solicitudes que se atenderán en cada barrido del brazo del disco. Estos algoritmos funcionan de la siguiente manera:
- Se utiliza una cola con espacio para solicitudes pendientes, que se van atendiendo mientras el brazo barre el disco.
- Mientras tanto, todas las nuevas solicitudes se incorporan a una cola diferente.
- Cuando el brazo termina el barrido y las primeras solicitudes han sido atendidas, el planificador toma otras solicitudes de la segunda cola y las introduce en la primera para repetir el proceso.
Si en lugar de copiar peticiones de la segunda a la primera cola se copian todas las solicitudes pendientes, el algoritmo se denomina F-SCAN.
Estos algoritmos previenen un problema denominado rigidez del brazo —o arm stickiness, en inglés— a diferencia de los algoritmos SSTF, SCAN, C-SCAN, LOOK y C-LOOK, que no lo hacen. El término rigidez del brazo hace referencia a cuando hay un flujo continuo de solicitudes para el mismo cilindro, lo que hace que con los algoritmos vistos hasta ahora el brazo no avance por los cilindros hasta llegar al otro extremo. Como F-SCAN, N-Step-SCAN y N-Step-LOOK separan las solicitudes en dos colas —haciendo que las nuevas tengan que esperar— el brazo siempre continúa su barrido hacia el extremo del disco.
Planificación CFQ
Sección titulada «Planificación CFQ»El planificador CFQ (Completely Fair Queuing) se diseñó para compartir de forma equitativa el ancho de banda entre todos los procesos que solicitan acceso al disco. Fue utilizado por defecto en muchas distribuciones de Linux hasta la versión 5.0 del núcleo.
Para repartir ese ancho de banda, CFQ distingue entre solicitudes síncronas y asíncronas, la misma distinción que vimos en las operaciones síncronas y asíncronas de paso de mensajes. Una solicitud síncrona deja al proceso en estado esperando hasta que se resuelve la petición, como ocurre por defecto con read(). Una asíncrona le permite seguir ejecutándose en la CPU mientras se atiende, como las escrituras con write().
Con eso en mente, CFQ funciona de la siguiente manera:
-
CFQ mantiene una cola de solicitudes para cada proceso y en ella inserta las solicitudes síncronas de E/S. Cada cola tiene una ventana de tiempo —o cuanto— para acceder al disco. La longitud del cuanto y el tamaño máximo de cada cola dependen de la prioridad de E/S que tenga el proceso.
-
CFQ mantiene una cola de solicitudes por cada prioridad de E/S, donde se insertan las solicitudes asíncronas de todos los procesos. Una solicitud asíncrona se inserta en una cola u otra según la prioridad del proceso que la generó.
-
Usando el algoritmo round-robin, el planificador CFQ recorre las colas y extrae de ellas las solicitudes durante el tiempo marcado por el cuanto de cada cola. Las solicitudes extraídas se insertan en la cola de E/S al disco, donde se ordenan para minimizar el tiempo de búsqueda, antes de ser enviadas al dispositivo.
Referencias de las API
Sección titulada «Referencias de las API»POSIX
Abre o crea un archivo y devuelve un descriptor de archivo.
int open(const char* pathname, int flags);int open(const char* pathname, int flags, mode_t mode);Lee datos de un descriptor de archivo.
ssize_t read(int fd, void* buf, size_t count);Notas al pie
Sección titulada «Notas al pie»-
Silicon Graphics Inc., XFS Filesystem, 2006. ↩