
16. Paginación
Método básico de paginación, soporte hardware de la tabla de páginas y la TLB, tiempos de acceso efectivo, bits de protección y de válido, páginas compartidas y paginación jerárquica.
La traducción entre direcciones virtuales y físicas puede realizarse de diversas maneras. La forma más extendida es la paginación, que no es sino un esquema de gestión de la memoria que permite que el espacio de direcciones físico de un proceso no sea continuo, evitando el problema de la fragmentación externa.
Método básico
Sección titulada «Método básico»En la paginación la memoria física se divide en bloques de tamaño fijo denominados marcos, mientras que el espacio de direcciones virtual se divide en bloques del mismo tamaño que los marcos, denominados páginas. Cuando un proceso va a ser ejecutado, sus páginas son cargadas desde el almacenamiento secundario en marcos libres de la memoria física.
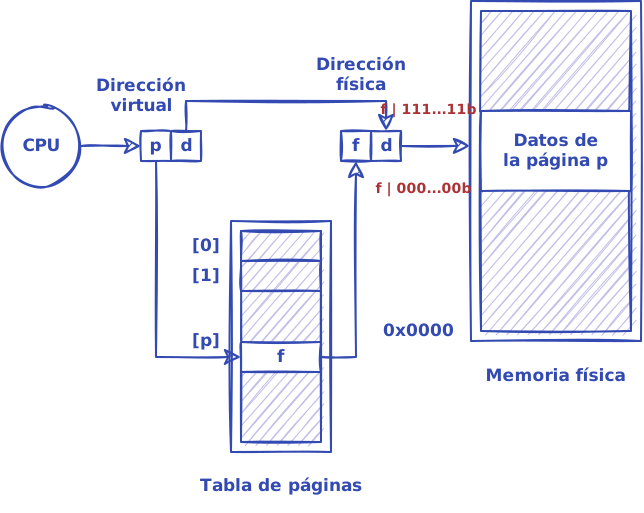
La paginación es una forma de reubicación de las direcciones en tiempo de ejecución donde la transformación de las direcciones virtuales en direcciones físicas se realiza de la siguiente manera (ver la figura anterior):
- Cada dirección virtual generada por la CPU es dividida en dos partes: un número de página y un desplazamiento .
- El número de página es utilizado por la MMU para indexar la tabla de páginas, que contiene el número de marco de cada página en la memoria física.
- El número de marco es combinado con el desplazamiento para generar la dirección física que va a ser enviada por el bus de direcciones hacia la memoria.
El tamaño de las páginas —y el de los marcos— viene definido por el hardware y normalmente es un número entero potencia de 2 que puede variar entre 512 bytes y 16 MiB, dependiendo de la arquitectura. Es decir, supongamos un espacio de direcciones de y un tamaño de página de . Entonces los bits de mayor orden de las direcciones virtuales indican el número de página y los bits de menor orden, el desplazamiento (ver la siguiente figura).
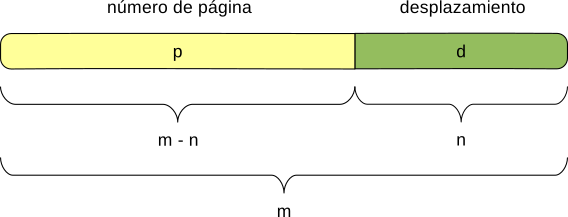
Por ejemplo, en muchos sistemas operativos el tamaño de página es de 4 KiB, por lo que el desplazamiento necesita:
Si las direcciones virtuales son de 32 bits, eso deja para el número de página :
por lo que el espacio de direcciones virtual tiene páginas —es decir, 1 048 576 páginas—.
Desde el punto de vista de los procesos
Sección titulada «Desde el punto de vista de los procesos»Cada página de un proceso requiere un marco. Por tanto, cuando un proceso llega al sistema:
- Si el proceso requiere páginas, el sistema operativo debe escoger marcos. Estos marcos son tomados de la lista de marcos libres que debe mantener el sistema. Puesto que son escogidos de allí donde los haya libres, el espacio de direcciones físico puede no ser contiguo, aunque los procesos vean un espacio de direcciones virtual contiguo.
- Los marcos seleccionados son asignados al proceso y cada página del proceso es cargada en uno de dichos marcos.
- La tabla de páginas es actualizada de manera que en la entrada de cada página del proceso se pone el número de marco correspondiente.
Un aspecto importante de la paginación es la diferencia entre cómo ven los procesos la memoria y cómo es realmente la memoria física. Cada proceso ve la memoria como un espacio único que lo contiene solo a él. Sin embargo, la realidad es que el programa está disperso por la memoria física, que además puede almacenar a otros programas. Esto es posible porque en cada momento la tabla de páginas solo contiene las páginas del proceso en ejecución en la CPU.
Desde el punto de vista del sistema operativo
Sección titulada «Desde el punto de vista del sistema operativo»Puesto que el sistema operativo es quien gestiona la memoria física, este debe saber:
- Qué marcos están asignados y a qué página de qué proceso o procesos.
- Qué marcos están disponibles.
Toda esta información generalmente se guarda en una estructura denominada la tabla de marcos, que tiene una entrada por cada marco de la memoria física.
Además, el sistema operativo debe mantener una copia de la tabla de páginas para cada proceso en el PCB, igual que mantiene una copia del contador de programa y del contenido de los registros de la CPU. Esta copia es utilizada:
-
Por el asignador para sustituir la tabla de páginas usada por la CPU cuando realiza un cambio de contexto. Por lo tanto, el uso de la paginación incrementa el tiempo del cambio de contexto.
-
Para la traducción manual de direcciones virtuales en físicas. Por ejemplo, cuando un proceso realiza una llamada al sistema para realizar una operación de E/S y proporciona una dirección como parámetro, dicha dirección debe ser traducida manualmente para producir la dirección física correspondiente, que será comunicada al hardware para realizar la operación.
Tamaño de las páginas
Sección titulada «Tamaño de las páginas»Una decisión de diseño importante es escoger el tamaño de las páginas adecuado:
-
Con páginas más pequeñas esperamos tener menos fragmentación interna.
-
Con páginas más grandes se pierde menos espacio en la tabla de páginas. No olvidemos que cuanto más pequeñas son las páginas, más páginas son necesarias y, por tanto, más entradas en la tabla de páginas se necesitan. Además, la E/S es más eficiente cuantos más datos son transferidos de cada vez.
El tamaño de página más habitual es de 4 KiB, aunque también se utilizan páginas de 8 y 16 KiB. En un sistema de 32 bits con páginas de 4 KiB —como del que hablamos antes— el espacio de direcciones virtual tiene 1 048 576 páginas. Si se utilizan 4 bytes para cada entrada de la tabla de páginas —aunque esto también puede variar— eso significa que cada tabla de páginas ocupa 4 MiB de espacio. Mientras que con páginas de 8 KiB, la tabla de páginas ocuparía 2 MiB de espacio.
También significa que si los 4 bytes de la tabla de páginas se utilizan para guardar únicamente el número de marco, cada entrada puede direccionar a uno de —o 4 GiB— marcos de la memoria física. Si el tamaño de cada marco es de 4 KiB —debe coincidir con el de las páginas— el sistema puede direccionar bytes de memoria física, o 16 TiB. Eso sí, el espacio de direcciones virtual de cada proceso solo le da acceso a un máximo de 4 GiB.
En cualquier caso, el tamaño de las páginas no siempre lo impone el hardware de forma rígida. La arquitectura ARM de 64 bits, por ejemplo, permite escoger entre páginas de 4, 16 y 64 KiB, y es el sistema operativo el que decide cuál utiliza. Durante años Linux —y con él sistemas derivados, como Android— se quedó en 4 KiB por herencia de x86, pero desde Android 15 Google impulsa el cambio a páginas de 16 KiB.1 El motivo es el que ya conocemos: con páginas más grandes hacen falta menos entradas en la tabla de páginas. Además, cada entrada de la TLB —la caché de traducción de direcciones de la que hablaremos más adelante— cubre más memoria, con lo que se reducen las consultas a la tabla. Google cifra la ganancia global entre el 5 % y el 10 %, con arranques de las aplicaciones entre un 3 % y un 30 % más rápidos —un 3,16 % de media—, un 4,5 % menos de consumo y un arranque del sistema unos 0,8 segundos más corto.2 El precio es un ligero aumento del uso de memoria por la fragmentación interna, que esas ganancias y el aumento de la memoria instalada en los dispositivos compensan de sobra.
Soporte hardware de la tabla de páginas
Sección titulada «Soporte hardware de la tabla de páginas»La implementación en hardware de la tabla de páginas puede realizarse de diversas maneras.
Almacenada en registros de la CPU
Sección titulada «Almacenada en registros de la CPU»La tabla de páginas del proceso actual en la CPU puede alojarse dentro de la propia CPU, en unos registros destinados a tal fin.
Debido a la velocidad de los registros de la CPU, la implementación en registros es la más eficiente. Sin embargo, solo puede ser utilizada para tablas de páginas razonablemente pequeñas, ya que alojar tablas de más de 256 entradas en registros es muy costoso.
Por ejemplo, el DEC —para el que se diseñó el primer UNIX— es un ejemplo de sistema con esta implementación. Utilizaba un espacio de direcciones de 16 bits y un tamaño de páginas de 8 KiB, por lo que solo necesitaba 8 registros dedicados para alojar toda la tabla de páginas.
Almacenada en memoria
Sección titulada «Almacenada en memoria»La otra opción es alojar la tabla de páginas del proceso actual en la memoria, normalmente en un formato definido por la CPU.
En los sistemas modernos se utilizan tablas de páginas de un millón de entradas o más, que difícilmente pueden alojarse en registros dentro de la CPU. Por eso, los sistemas actuales almacenan en la memoria la tabla de páginas del proceso actualmente en ejecución. Eso permite disponer de tablas de páginas de gran tamaño, aunque a costa de necesitar dos accesos a la memoria física por cada acceso a una dirección virtual.
Para que la MMU pueda conocer la ubicación de la tabla de páginas durante la traducción de las direcciones, la CPU debe disponer de un registro —el PTBR (Page-Table Base Register)— donde se guarda la dirección de la tabla de páginas actual.
Además, esto tiene la ventaja de que el cambio de contexto es más rápido —respecto al uso de registros para almacenar la tabla de páginas— puesto que solo es necesario cargar un único registro más —el PTBR— durante el mismo.
La solución al retraso originado por el acceso a la tabla de páginas, cuando esta está en la memoria, pasa por que el sistema disponga de una pequeña caché de traducciones en hardware llamada TLB (Translation Look-aside Buffer).
La TLB es una memoria asociativa de alta velocidad que, por su forma de operar, resulta cara de fabricar, por lo que su tamaño es muy limitado: normalmente, entre 64 y 1024 entradas. Cada entrada de la TLB tiene dos partes: la clave —o etiqueta— y el valor. Cuando a la TLB se le entrega un elemento, este es comparado simultáneamente con todas las claves. Si se produce alguna coincidencia, la memoria devuelve el valor de la entrada correspondiente.
Uso básico de la TLB
Sección titulada «Uso básico de la TLB»La TLB se utiliza con la tabla de páginas de la siguiente manera:
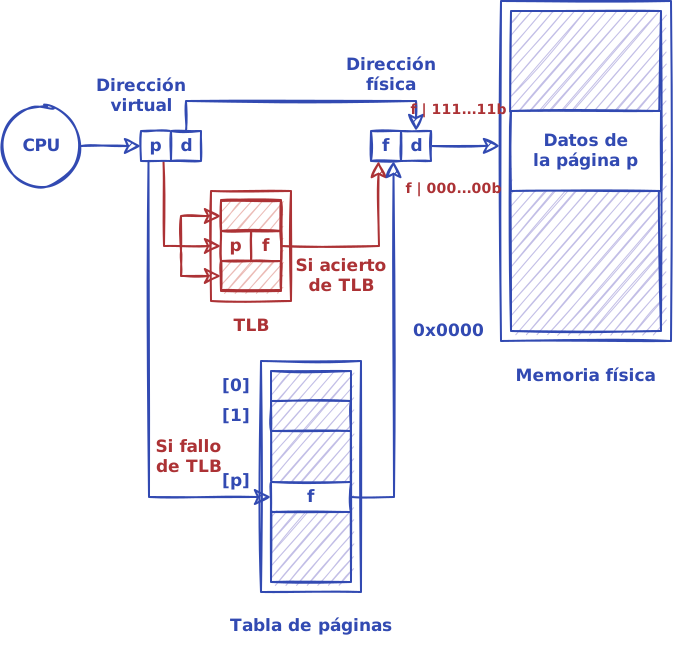
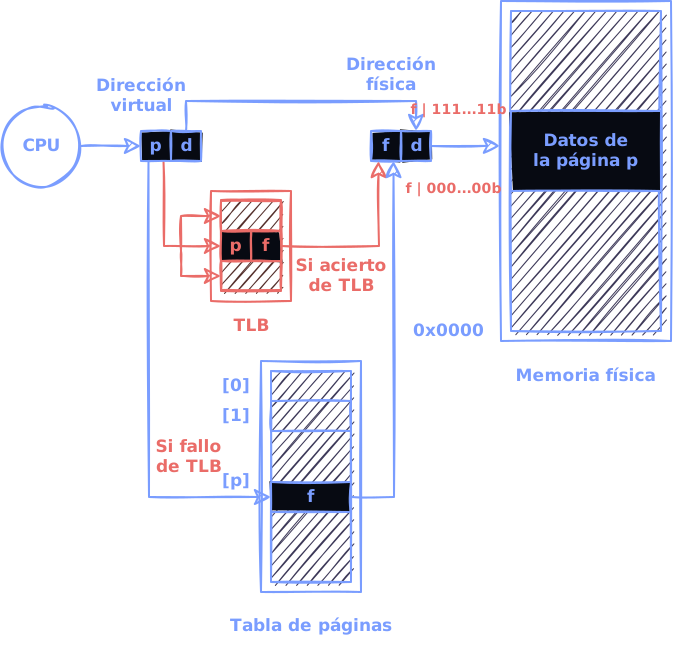
- La TLB contiene unas pocas entradas de la tabla de páginas.
- Cuando la CPU genera una dirección virtual, el número de página es entregado a la TLB. La TLB utiliza los números de páginas como clave, por lo que si hay alguna coincidencia, devolverá la entrada correspondiente de la tabla de páginas.
- Si hay coincidencia —o acierto de TLB— el número de marco es extraído de la entrada devuelta por la TLB y es utilizado para generar la dirección física. Todo este proceso puede requerir un 10 % más de tiempo que si no se hiciera la traducción de las direcciones.
- Si no hay coincidencia —o fallo de TLB— es necesario acceder a la tabla de páginas para obtener la entrada correspondiente directamente de ella. Indudablemente, este acceso puede beneficiarse de la existencia de diferentes niveles de caché en el acceso a la memoria principal.
- En este último caso, la entrada recuperada debe ser añadida a la TLB, por lo que si está llena, se debe seleccionar una para ser sustituida. Los algoritmos de reemplazo utilizados van desde elegir una aleatoriamente hasta el LRU (Least Recently Used).
Borrado de la TLB en el cambio de contexto
Sección titulada «Borrado de la TLB en el cambio de contexto»Una cuestión importante es qué ocurre con las TLB cuando el sistema operativo realiza un cambio de contexto, particularmente entre hilos de diferentes procesos.
En general, es necesario que el asignador realice un borrado de la TLB. De lo contrario, el nuevo proceso podría utilizar las entradas de la tabla de páginas del viejo proceso, que estuvieran almacenadas en la TLB. Por eso, como los hilos de un mismo proceso comparten la tabla de páginas, entre ellos el borrado no es necesario. Esa es una de las razones por las que su cambio de contexto resulta más barato (ver el apartado «Economía»).
Sin embargo, un proceso no tiene por qué utilizar todas las entradas de la TLB, por lo que sería más interesante no tener que borrar las entradas de procesos anteriores, mientras no sean necesarias, por si estos vuelven a ser ejecutados en la CPU. El borrado se puede evitar si cada entrada de la TLB tiene un ASID (Address-Space Identifier), que no es más que un identificador único para cada proceso. En este tipo de TLB, en la clave se buscan pares (número de página, ASID), donde el primero proviene de la dirección virtual y el segundo es el ASID del proceso actual. De esta forma, si el número de página coincide, pero no el ASID, se produce un fallo de la TLB. Esto obliga a acceder a la tabla de páginas en memoria para recuperar la entrada, evitando que se lea por error la entrada de un proceso anterior.
Esta característica está presente en los procesadores DEC, y Sun. Entre 2005 y 2006 también comenzó a ser incluida en algunos procesadores de la familia x86, a través de las extensiones de virtualización Intel VT y AMD Pacifica.
Tiempos de acceso a la memoria
Sección titulada «Tiempos de acceso a la memoria»El rendimiento de un sistema con paginación está relacionado con el tiempo de acceso efectivo a la memoria . Este intenta estimar lo que realmente se tarda en acceder a la memoria, teniendo en cuenta mecanismos del sistema operativo como el método de paginación o la existencia de TLB.
En muchos sistemas informáticos, el tiempo de acceso a la memoria física es de unos pocos nanosegundos. Por tanto, en el método básico de paginación —con una tabla de páginas lineal— y sin TLB, el tiempo de acceso efectivo es el doble del tiempo de acceso a la memoria:
porque es necesario acceder a la memoria en dos ocasiones:
- Primero, para consultar la tabla de páginas, con el objetivo de traducir la dirección virtual en una dirección física.
- Después, para realizar la operación solicitada sobre la memoria física.
Obviamente, en métodos de paginación donde hagan falta más accesos para obtener finalmente el número de marco, el tiempo de acceso efectivo será mayor.
En el caso anterior, el segundo acceso a la memoria es inevitable, porque corresponde a la operación solicitada por el proceso. Mientras que el primero puede evitarse, en ciertas ocasiones, consultando la TLB antes de acceder a la tabla de páginas. Es decir, en un sistema con TLB:
- Cuando la dirección virtual no está en la TLB, , porque primero se accede a la TLB y después —como no se encuentra allí la dirección virtual— se consulta la tabla de páginas.
- Cuando la dirección virtual está en la TLB, , porque la TLB proporciona la información necesaria para traducir la dirección, evitando la consulta posterior a la tabla de páginas.
El del primer caso suele ser mucho mayor que el segundo porque, por lo general, . Esto hace que en muchos sistemas se pueda considerar que cuando la dirección virtual está en la TLB.
Como el tiempo de acceso efectivo ahora depende de la probabilidad de que las direcciones virtuales consultadas estén en la TLB, ya no podemos hacer el cálculo de forma determinista, sino estimar un promedio para el sistema. Para ello, solo es necesario sumar el para ambos casos, ponderando por la probabilidad de que la dirección esté en la TLB o de que no esté en la TLB, respectivamente:
Como comentamos anteriormente, esta expresión se puede simplificar si consideramos que :
Obviamente, cuanto más se aproxima a 1 la probabilidad de que la entrada esté en la TLB, más cerca está de .
Para mejorar esta probabilidad:
-
Las TLB permiten marcar algunas entradas como insustituibles. Esto normalmente se hace con las entradas de las páginas del código y los datos del núcleo, ya que son páginas que se utilizan con muchísima frecuencia.
-
Si la MMU soporta páginas de mayor tamaño que el estándar, se utilizan para alojar el código y los datos del núcleo. De esta forma se minimiza el número de entradas de la TLB que utilizan, con el fin de disponer de más entradas libres para los procesos en ejecución.
Protección de la memoria
Sección titulada «Protección de la memoria»La protección de las páginas se consigue mediante unos bits que indican las operaciones que se pueden realizar sobre ellas. Normalmente, estos bits son almacenados en cada una de las entradas de la tabla de páginas.
Bits de protección
Sección titulada «Bits de protección»Los bits de protección pueden ser:
-
Solo lectura.
-
Lectura y escritura. En algunos sistemas hay un bit específico para este permiso, mientras que en otros se utilizan bits separados, como lectura, escritura y ejecución, que se pueden combinar libremente.
-
Solo ejecución. No existen en todas las plataformas. Por ejemplo, la familia x86 careció de esta característica hasta que AMD la incluyó en su arquitectura x86-64, lo que obligó a Intel a incluirla en las versiones más modernas de Pentium IV. El bit —que para ser exactos indica no ejecución— fue introducido para evitar cierto tipo de ataques de seguridad.
Durante la traducción de las direcciones, la MMU comprueba que el tipo de acceso sea válido. Si no lo es, se genera una excepción de violación de protección de memoria, dado que el acceso en un modo no autorizado se considera una instrucción privilegiada. Normalmente, el sistema operativo responde a dicha excepción terminando el proceso que la generó.
Bit de válido
Sección titulada «Bit de válido»Además de los bits de protección comentados, se suele añadir a cada entrada un bit de válido:
-
Cuando una página es válida, la página existe en el espacio de direcciones virtual del proceso. Es decir, que la página se puede utilizar. Otro término comúnmente utilizado es que la página es legal.
-
Cuando la página es inválida, la página no existe en el espacio de direcciones virtual del proceso. Es decir, que la página no se puede utilizar. El término alternativo utilizado es que la página es ilegal.
Al igual que con los bits de protección, los intentos de acceso a una página ilegal generan una excepción.
El sistema operativo puede utilizar este bit para permitir o denegar cualquier tipo de acceso a una página. Generalmente, porque no se le ha asignado un marco de memoria física, ya que esa página no está siendo utilizada por el proceso.
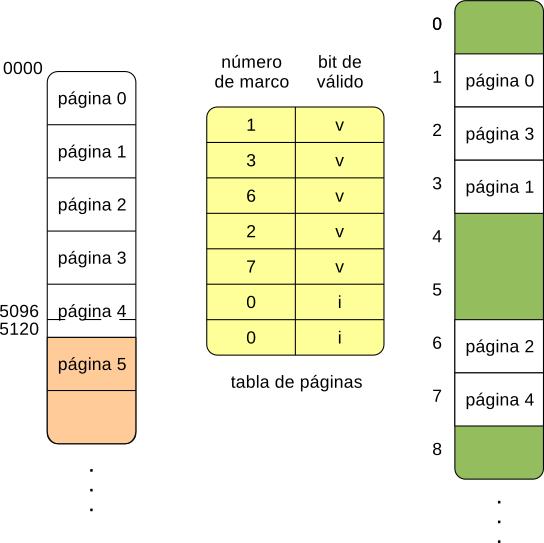
Por ejemplo, en la figura anterior vemos el espacio de direcciones virtual y la tabla de páginas de un proceso de 5096 bytes en un sistema con páginas de 1 KiB. Puesto que el proceso no ocupa todo el espacio de direcciones, solo las direcciones de la 0 a la 5119 son válidas. En dicho ejemplo, podemos apreciar varios fenómenos:
-
Debido a la fragmentación interna, las direcciones de la 5096 a la 5119 son válidas, aunque el proceso solo ocupe hasta la 5095. Es decir, se está asignando al proceso una porción de memoria que no necesita.
-
Solo las páginas con datos y código del proceso son válidas. Mientras que todas las páginas con direcciones por encima de la 5119 están marcadas como ilegales.
En general, los procesos solo necesitan una porción muy pequeña de su espacio de direcciones virtual. Por ejemplo, en un sistema de 32 bits, muy pocos procesos necesitan los 3 GiB disponibles como máximo para cada proceso —el 1 GiB restante suele estar ocupado por el núcleo del sistema—. Utilizando el bit de válido, el sistema operativo no tiene que asignar marcos a páginas no utilizadas por el proceso, ahorrando mucha memoria.
En «Tamaño de las páginas» vimos que el tamaño de la tabla de páginas se puede calcular como el número máximo de páginas del espacio de direcciones virtual multiplicado por el tamaño de cada entrada de la tabla. Así, en un sistema de 32 bits con páginas de 4 KiB y 4 bytes por entrada, se necesitan 4 MiB de memoria para almacenar la tabla de páginas. Como un proceso suele ocupar muy poco de su espacio de direcciones virtual, suele ser un desperdicio de memoria crear y almacenar una tabla de páginas completa, con una entrada para cada página del espacio de direcciones.
Para evitarlo, en algunas CPU existe el registro PTLR (Page-Table Length Register) que se utiliza para indicar el tamaño actual de la tabla de páginas. Este valor es comparado por la MMU, durante la traducción de las direcciones virtuales, con el número de página de cada dirección virtual, de manera que las páginas con entradas más allá de la última almacenada en la tabla son consideradas ilegales.
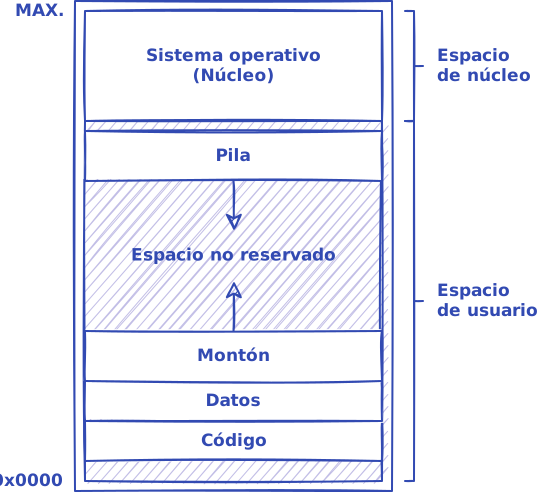
En realidad, el registro PTLR no es de mucha utilidad en los sistemas operativos modernos porque, tal y como vimos en «El proceso», lo más común es que los procesos tengan un espacio de direcciones virtual disperso como el de la figura anterior. En ella podemos observar cómo el sistema operativo ubica los diferentes componentes del proceso de una forma particular dentro del espacio de direcciones virtual. Este esquema permite que tanto el montón —a través del mecanismo de asignación dinámica de memoria— como la pila puedan extenderse —según las necesidades de memoria que tenga el proceso— sobre la región de memoria no ocupada. Esa región también puede ser parcialmente ocupada por librerías de enlace dinámico o regiones de memoria compartida, si son necesarias durante la ejecución del proceso.
En cualquier caso, las páginas de la región no ocupada forman parte del espacio de direcciones virtual, pero no necesitan tener asignado ningún marco de memoria física, en tanto en cuanto el proceso no las vaya a utilizar. La falta de marco es indicada por el sistema operativo utilizando el bit de válido para denegar el acceso.
Páginas compartidas
Sección titulada «Páginas compartidas»Una de las ventajas importantes de la paginación es la posibilidad de compartir páginas entre procesos. Para conseguir esto, basta con que las páginas compartidas de los distintos procesos tengan asignadas un mismo marco. Esto permite, por ejemplo, que los procesos de un mismo programa puedan compartir las páginas de código o los datos de solo lectura con el fin de ahorrar memoria. También permite compartir las páginas de código de una librería compartida enlazada en diferentes procesos.
Compartir páginas no solo permite ahorrar memoria, pues en los sistemas operativos modernos la comunicación entre procesos mediante memoria compartida se implementa mediante páginas compartidas.
Paginación jerárquica
Sección titulada «Paginación jerárquica»Al método básico de paginación se lo conoce como tabla de páginas lineal. Sin embargo, las CPU comúnmente utilizan otras técnicas a la hora de estructurar la tabla de páginas. Una de las más comunes es la paginación jerárquica, utilizada en los procesadores de la familia x86 y en ARM, entre otros.
La mayor parte de los sistemas modernos soportan el uso de espacios de direcciones de gran tamaño. Por ejemplo, supongamos un sistema con un espacio de direcciones virtual de 32 bits:
- Tamaño del espacio de direcciones: .
- Tamaño de página: .
- Número de páginas: entradas.
Es decir, si el tamaño de cada entrada fuera de 4 bytes, la tabla de páginas de un proceso podría ocupar hasta 4 MiB. Como debe alojarse en una región contigua del espacio de direcciones físico, podría ocurrir que en algún momento no hubiera un hueco contiguo lo suficientemente grande. Una forma de resolver este problema es partir la tabla de páginas, de manera que no sea necesario asignarle memoria de forma contigua.
Paginación jerárquica de dos niveles
Sección titulada «Paginación jerárquica de dos niveles»La paginación jerárquica se basa en la idea de que un vector de gran tamaño puede ser mapeado en uno más pequeño, que a su vez puede ser mapeado en un vector de menor tamaño.
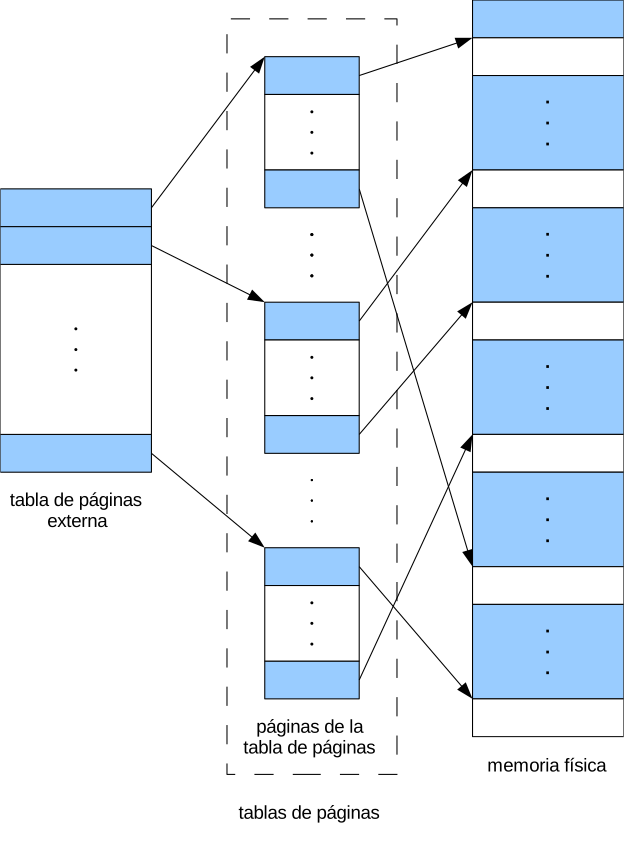
Por ejemplo, volvamos al sistema anterior, con un espacio de direcciones de 32 bits y páginas de 4 KiB. Su tabla de páginas tiene 1 048 576 entradas —4 MiB si cada una necesita 4 bytes— y se puede dividir en 1024 porciones, cada una de las cuales cabría en un marco de 4 KiB.
Estos marcos, a su vez, pueden ser mapeados por 1024 entradas con las direcciones físicas de cada marco. Si organizamos estas 1024 entradas en un vector lineal, obtendremos una tabla de páginas externa de 4 KiB (ver la figura anterior).
Dado que 4 KiB es una cantidad de memoria muy pequeña, muchos sistemas operativos mantienen la tabla de páginas externa en la memoria mientras el proceso se está ejecutando. Sin embargo, ahora la tabla de páginas está dividida en marcos, que no tienen por qué ser asignados de forma contigua en la memoria. Incluso podrían ser intercambiados al disco, en caso de necesitar memoria libre.
Para tener dos niveles de 1024 entradas, solo es necesario dividir el número de página de la dirección virtual —que tenía 20 bits— en dos números de página de 10 bits cada uno:
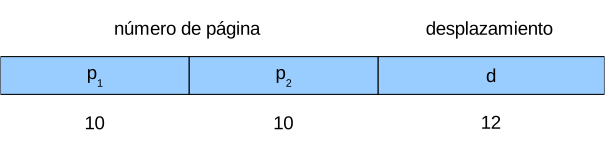
Este es el método utilizado por la familia de procesadores x86.
Otra variación de la paginación jerárquica de dos niveles es la utilizada por VAX. Estos sistemas utilizaban una arquitectura de 32 bits con un tamaño de página de 512 bytes. Las direcciones virtuales eran divididas de la siguiente manera:
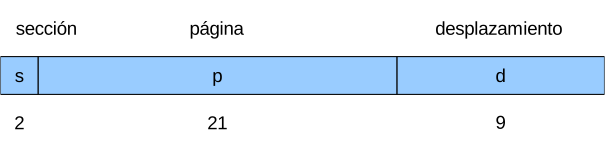
El espacio de direcciones de un proceso estaba dividido en 3 secciones. Los 2 bits de orden más alto de las direcciones virtuales se utilizaban para indicar la sección. Cada sección estaba dividida en páginas de 512 bytes, por lo que los siguientes 21 bits de las direcciones virtuales eran utilizados para seleccionar la página concreta.
Dividiendo el espacio de direcciones de esta manera, el sistema operativo podía mantener secciones sin utilizar mientras no fueran necesarias. Esto era importante, puesto que la tabla de páginas de una sección tenía un tamaño de 8 MiB.
Paginación jerárquica de N niveles
Sección titulada «Paginación jerárquica de N niveles»En general, en la paginación jerárquica de niveles el número de página de cada dirección virtual es dividido en números , donde:
- se utiliza para indexar la tabla de páginas externa —también llamada directorio de páginas o tabla de páginas de nivel 0— cuya dirección conoce la CPU mediante el PTBR. La entrada obtenida de esta manera contiene la dirección en la memoria física de una porción de la tabla de páginas en el siguiente nivel —el nivel 1—.
- se utiliza para indexar la tabla de páginas de nivel 1. E, igualmente, la entrada así obtenida contiene la dirección en la memoria física de una porción de la tabla de páginas en el siguiente nivel —el nivel 2—.
- El proceso continúa hasta que se utiliza para indexar la tabla de páginas de nivel , con la que se obtiene el número de marco que es utilizado, finalmente, para generar la dirección física al combinarlo con el desplazamiento de la dirección virtual.
Como se puede ver, resolver una dirección virtual necesita tantos accesos a la memoria como niveles hay en la jerarquía.
Debido a que la traducción funciona desde las tablas de páginas de nivel superior —nivel 0— hacia las de nivel inferior —nivel — a esta estructura también se la conoce como tabla de páginas directa.
Existen algunos procesadores que utilizan más de dos niveles. Por ejemplo, los procesadores x86-64 utilizan un esquema de 4 niveles de paginación. Cada página es de 4 KiB, como en el resto de la familia x86, pero cada entrada de la tabla de páginas ocupa 8 bytes para poder almacenar direcciones de 64 bits. Así, en cada marco caben 512 entradas, por lo que los números de página de cada nivel necesitan 9 bits. Eso significa que de las direcciones virtuales se utilizan actualmente 48 bits —resultado de multiplicar 4 niveles por 9 bits cada uno más 12 bits de desplazamiento— aunque el límite de la arquitectura para las direcciones virtuales sea de 64 bits.
Los procesadores ARM de 64 bits utilizan ese mismo esquema de 4 niveles y 48 bits de dirección virtual cuando las páginas son de 4 KiB. La diferencia es que en ARM el número de niveles depende del tamaño de página escogido (ver el apartado «Tamaño de las páginas»). Con páginas de 16 KiB cada nivel indexa 11 bits del número de página y con páginas de 64 KiB, 13 bits, así que hacen falta menos niveles para cubrir el mismo espacio de direcciones virtual. Por ejemplo, con páginas de 64 KiB bastan 3 niveles para cubrir los 48 bits de dirección virtual. Esta es otra ventaja de las páginas grandes, porque cuantos menos niveles tiene la jerarquía, menos accesos a la memoria cuesta traducir cada dirección.
Extra Cómo accede el núcleo a las tablas de páginas
Sección titulada « Cómo accede el núcleo a las tablas de páginas»El núcleo del sistema operativo también se ejecuta con la MMU activada, así que sus accesos a la memoria utilizan direcciones virtuales, como los de cualquier proceso. Sin embargo, las entradas de las tablas de páginas guardan direcciones físicas, que son las que necesita el hardware para recorrer la jerarquía. Eso plantea un problema práctico: cuando el núcleo tiene que crear o modificar una tabla de páginas conoce su dirección física, pero no puede acceder a ella sin una dirección virtual que la referencie. Hay dos soluciones extendidas.
La primera es el automapeo —o self-map— que consiste en reservar una entrada de la tabla de páginas de nivel 0 para que apunte a la propia tabla de nivel 0. Por ejemplo, supongamos que la entrada 1023 de la tabla de páginas de nivel 0 apunta a la propia tabla de nivel 0 y que tenemos 2 niveles de paginación. Una dirección virtual construida con el número de página 1023 en el nivel 0, 10 en el nivel 1 y con un desplazamiento de 0, apunta al primer byte de la tabla de páginas 10 de nivel 1. Si la dirección virtual tiene el número de página 1023 en el nivel 0, 1023 en el nivel 1 y desplazamiento de 0, apunta al primer byte de la tabla de páginas de nivel 0.
Con ese pequeño truco el recorrido del hardware acaba entregando las tablas de páginas en los diferentes niveles como si fueran páginas de datos, en una región fija del espacio de direcciones virtual.
También se le llama mapeo fractal, porque la estructura que aparece en esa región se repite a diferentes escalas.
Windows lo utiliza en x86-64, con la entrada 0x1ed del nivel 0 hasta Windows 10 TH2 y con una entrada escogida al azar en cada arranque desde la versión 1607.3
Su gran ventaja es que apenas consume espacio de direcciones virtual, pero solo da acceso a las tablas del proceso en ejecución.
La segunda solución es el mapa directo de la memoria física, que consiste en reservar una región del espacio de direcciones virtual del núcleo donde toda la memoria física aparece mapeada de forma lineal.
Traducir entre ambos espacios es entonces sumar o restar un desplazamiento constante, que es literalmente lo que hacen las macros __pa() y __va() de Linux.
En x86-64 con paginación de 4 niveles esa ventana ocupa 64 TiB a partir de la dirección 0xffff888000000000, aunque la aleatorización del espacio de direcciones del núcleo desplaza esa base en cada arranque.4
Este esquema era inviable en los sistemas de 32 bits. Linux repartía los 4 GiB de espacio de direcciones virtual en 3 GiB para el proceso y 1 GiB para el núcleo, por lo que el mapa directo solo alcanzaba unos 896 MiB de memoria física —la denominada lowmem—. El resto de la memoria física, la highmem, había que hacerla accesible mediante mapeos temporales. Con 64 bits el problema desaparece, porque mapear toda la memoria física ocupa una fracción despreciable del espacio de direcciones disponible.
El mapa directo tiene dos ventajas importantes. La primera es que el núcleo puede acceder a cualquier byte de la memoria física —incluidas las tablas de páginas de un proceso que no esté en ejecución— sin más que sumar el desplazamiento. La segunda es que, al ser un mapeo lineal y contiguo, se puede describir con páginas de 2 MiB o de 1 GiB en lugar de 4 KiB (ver el apartado «Tamaño de las páginas»), reduciendo mucho el número de entradas de la TLB que consume.
El precio es que toda la memoria física resulta alcanzable desde el núcleo, lo que amplía la superficie de ataque si se consigue ejecutar código con sus privilegios. Por eso ninguna de las dos técnicas ha desplazado a la otra: Linux utiliza el mapa directo, mientras que Windows sigue utilizando el automapeo.
Tiempos de acceso con paginación jerárquica
Sección titulada «Tiempos de acceso con paginación jerárquica»La paginación jerárquica aumenta el número de accesos necesarios para consultar la tabla de páginas. Es decir, mientras que para consultar una tabla de páginas lineal solo necesitamos un acceso a la memoria, para obtener una dirección física en la paginación jerárquica de niveles necesitamos accesos a la memoria. Por tanto, el tiempo de acceso efectivo en un sistema sin TLB es:
porque, además de los accesos para consultar la tabla de páginas y obtener la dirección física, es necesario ejecutar la operación solicitada en la memoria física.
Como en «Tiempos de acceso a la memoria», cuando el sistema dispone de TLB, el tiempo de acceso efectivo anterior corresponde al caso en el que la dirección virtual no está en la TLB. Mientras que, en caso contrario, el tiempo de acceso efectivo es .
Siguiendo los mismos pasos que en «Tiempos de acceso a la memoria», para obtener una estimación de en base a la probabilidad de que las direcciones virtuales consultadas estén en la TLB, obtenemos el siguiente resultado:
Esta expresión se puede simplificar si consideramos que :
Notas al pie
Sección titulada «Notas al pie»-
«Support 16 KB page», Android Developers. ↩
-
Mayank Jain y Jomo Fisher, «Transition to using 16 KB page sizes for Android apps and games using Android», Android Developers Blog, 10 de julio de 2025. ↩
-
«Some toying with the Self-Reference PML4», blahcat, 15 de junio de 2020. ↩