
17. Memoria virtual
Paginación bajo demanda, copy-on-write, archivos mapeados en memoria, algoritmos de reemplazo y asignación de marcos, hiperpaginación y la interfaz de gestión de la memoria del proceso.
La memoria virtual es una técnica que permite la ejecución de procesos sin que estos tengan que ser cargados completamente en la memoria.
Los programas suelen tener partes de código que rara vez son ejecutadas. Por ejemplo, las funciones para manejar condiciones de error que, aunque útiles, generalmente nunca son invocadas. También es frecuente que se reserve más memoria para datos de lo que realmente es necesario. Por ejemplo, muchos programadores tienen la costumbre de hacer cosas tales como declarar un array de 65 536 elementos, cuando realmente solo necesitan 255. Teniendo todo esto en cuenta, y con el fin de mejorar el aprovechamiento de la memoria, parece que sería interesante no tener que cargar todas las porciones de los procesos y que, aun así, pudieran ejecutarse. Eso es exactamente lo que proporciona la memoria virtual.
La habilidad de ejecutar un proceso cargado parcialmente en memoria proporciona algunos beneficios importantes:
-
Un programa nunca más estaría limitado por la cantidad de memoria disponible. Es decir, los desarrolladores pueden escribir programas considerando que disponen de un espacio de direcciones virtual extremadamente grande, sin considerar la cantidad de memoria realmente disponible. No debemos olvidar que sin memoria virtual, para que un proceso pueda ser ejecutado, debe estar completamente cargado en la memoria.
-
Puesto que cada programa ocupa menos memoria, más programas se pueden ejecutar al mismo tiempo, con el correspondiente incremento en el uso de la CPU y en el rendimiento del sistema, pero sin efectos negativos en el tiempo de respuesta y en el de ejecución.
El concepto de memoria virtual no debe confundirse con el de espacio de direcciones virtual. Sin embargo están relacionados, puesto que el que exista separación entre la memoria física y la manera en la que los procesos perciben la memoria es un requisito para poder implementar la memoria virtual.
Paginación bajo demanda
Sección titulada «Paginación bajo demanda»La paginación bajo demanda es la técnica con la que frecuentemente se implementa la memoria virtual en los sistemas con paginación.
En la paginación bajo demanda son las páginas individuales, en las que se divide el espacio de direcciones virtual de cada proceso, las que se sacan temporalmente de la memoria y se copian a un almacenamiento de respaldo. Después vuelven a la memoria cuando su proceso las necesita. A este proceso de guardado y recuperación de las páginas sobre el almacenamiento de respaldo se lo denomina intercambio o swapping y es llevado a cabo por un componente del sistema operativo denominado el paginador.
Para que se puedan cargar las páginas cuando son necesitadas por su proceso, hace falta que el paginador sepa cuándo lo son. Eso requiere que el hardware proporcione algún tipo de soporte, por ejemplo, incorporando un bit de válido a la entrada de cada página en la tabla de páginas, que se utiliza de la siguiente manera:
-
Cuando el bit de válido está a 1 la página es legal y está en la memoria. Es decir, la página existe en el espacio de direcciones virtual del proceso y tiene asignado un marco de memoria física.
-
Cuando el bit de válido está a 0, pueden ocurrir varias cosas:
-
La página es legal, pero está almacenada en disco y no en la memoria.
-
La página no es legal. Es decir, no existe en el espacio de direcciones virtual del proceso. Esto puede ser debido a que la página esté en un hueco del espacio de direcciones —en una región que no está siendo utilizada— por lo que el sistema operativo no le ha asignado espacio de almacenamiento ni en disco ni en la memoria.
-
Si un proceso accede a una página legal, no ocurre nada y la instrucción se ejecuta con normalidad. Pero si accede a una página marcada como inválida:
- Al intentar acceder a la página, la MMU comprueba el bit de válido y genera una excepción de fallo de página al estar marcada como inválida. Dicha excepción es capturada por el sistema operativo.
- El sistema operativo comprueba en una tabla interna si la página es legal o no. Es decir, si la página realmente no pertenece al espacio de direcciones virtual del proceso o si pertenece, pero está almacenada en el disco. Esta tabla interna suele almacenarse en el PCB del proceso como parte de la información de gestión de la memoria.
- Si la página es ilegal, el proceso ha cometido un error y debe ser terminado. En sistemas POSIX, por ejemplo, el sistema envía al proceso una señal de violación de segmento que lo obliga a terminar.
- Si la página es legal, se carga desde el disco:
- El núcleo busca un marco de memoria libre que, por ejemplo, se puede escoger de la lista de marcos libres del sistema.
- Se solicita una operación de disco para leer la página deseada en el marco asignado. Puesto que no resulta eficiente mantener la CPU ocupada mientras la página es recuperada desde el disco, el sistema debe solicitar la lectura de la página y poner al proceso en estado esperando.
- Cuando la lectura del disco haya terminado, se modifica la tabla interna antes mencionada y la tabla de páginas para indicar que la página está en la memoria.
- Reiniciar la instrucción que fue interrumpida por la excepción. Generalmente esto se hace colocando el proceso nuevamente en la cola de preparados y dejando que el asignador lo reinicie cuando sea escogido por el planificador de la CPU.
Un caso extremo de la paginación bajo demanda es la paginación bajo demanda pura. En ella la ejecución de un proceso se inicia sin cargar ninguna página en la memoria. Cuando el sistema operativo sitúa el contador de programa en la primera instrucción del proceso —que es una página no residente en memoria— se genera inmediatamente un fallo de página. La página es cargada en la memoria —tal y como hemos descrito anteriormente— y el proceso continúa ejecutándose, fallando cuando sea necesario con cada página que necesite y no esté cargada. Las principales ventajas de la paginación bajo demanda pura son:
- Nunca se trae desde el disco una página que no sea necesaria.
- El inicio de la ejecución de un proceso es mucho más rápido que si se cargara todo el proceso desde el principio.
Requerimientos de la paginación bajo demanda
Sección titulada «Requerimientos de la paginación bajo demanda»Los requerimientos hardware para que un sistema operativo pueda soportar la paginación bajo demanda son:
-
Tabla de páginas con habilidad para marcar entradas inválidas, ya sea utilizando un bit específico o con valores especiales en los bits de protección.
-
Disponibilidad de un dispositivo de almacenamiento secundario. En este dispositivo se guardan las páginas que no están presentes en la memoria principal. Normalmente se trata de un disco conocido como dispositivo de intercambio, mientras que la sección de disco utilizada concretamente para dicho propósito se conoce como espacio de intercambio o swap.
-
Posibilidad de reiniciar cualquier instrucción después de un fallo de página. En la mayor parte de los casos esta funcionalidad es sencilla de conseguir. Sin embargo, la mayor dificultad proviene de las instrucciones que pueden modificar diferentes posiciones de la memoria, como aquellas pensadas para mover bloques de bytes o palabras. En el caso de que el bloque de origen o de destino atraviese un borde de página, la instrucción sería interrumpida cuando la operación solo haya sido realizada parcialmente. Si además ambos bloques se superpusieran, no se podría reiniciar la instrucción completa. Las posibles soluciones a este problema deben ser implementadas en la CPU.
Rendimiento de la paginación bajo demanda
Sección titulada «Rendimiento de la paginación bajo demanda»Indudablemente, el rendimiento de un sistema con paginación bajo demanda se ve afectado por el número de fallos de página. En el peor de los casos, en cada instrucción un proceso puede intentar acceder a una página distinta, empeorando notablemente el rendimiento. Sin embargo, esto no ocurre, puesto que los programas tienden a tener localidad de referencia (ver el apartado «Hiperpaginación»).
Tiempos de acceso efectivo
Sección titulada «Tiempos de acceso efectivo»Como con la paginación, el rendimiento de un sistema con paginación bajo demanda también está relacionado con el concepto de tiempo de acceso efectivo a la memoria, que intenta estimar el tiempo que realmente se tarda en acceder a la memoria teniendo en cuenta mecanismos del sistema operativo.
Supongamos que conocemos el tiempo de acceso a la memoria cuando hay acierto de página —es decir, si no ocurre un fallo de página— al que llamaremos . Y supongamos que también conocemos la tasa de fallos de página , que es la proporción de los accesos a la memoria que provocan un fallo de página. Es decir, la probabilidad de que un acceso cualquiera a la memoria acabe en un fallo de página, por lo que es un valor entre 0 y 1. Entonces el tiempo de acceso efectivo se calcula ponderando los dos casos posibles. Por un lado, la probabilidad de que no ocurra un fallo de página por el tiempo de acceso a la memoria en ese caso . Por otro, la probabilidad de que sí ocurra por el tiempo necesario para gestionarlo —o tiempo de fallo de página— :
Por tanto, para calcular el tiempo de acceso efectivo necesitamos estimar el tiempo de fallo de página , que se consume fundamentalmente en:
-
Servir la excepción de fallo de página. Esto incluye capturar la interrupción, salvar los registros y el estado del proceso, determinar que la interrupción es debida a una excepción de fallo de página, comprobar si la página es legal y determinar la localización de la misma en el disco. Aproximadamente, en realizar esta tarea el sistema puede tardar de 1 a 100 μs.
-
Leer la página en un marco libre. En esta tarea se puede tardar alrededor de 8 ms, pero este tiempo puede ser mucho mayor si el dispositivo está ocupado y se debe esperar a que se realicen otras operaciones.
-
Reiniciar el proceso. Si incluimos el tiempo de espera en la cola de preparados, se puede tardar entre 1 y 100 μs.
Como se puede apreciar, la mayor parte del tiempo de fallo de página es debido al tiempo requerido para acceder al dispositivo de intercambio.
Para ilustrar el cálculo del tiempo de acceso efectivo a la memoria, solo vamos a considerar el tiempo requerido para acceder al dispositivo de intercambio, ignorando las otras tareas a realizar durante el fallo de página, ya que comparativamente consumen mucho menos tiempo. Vamos a suponer que el tiempo de acceso a la memoria en caso de acierto de página es de 200 ns y que la tasa de fallos de página es muy pequeña —es decir, —:
Como se puede apreciar, el tiempo de acceso efectivo prácticamente es proporcional a la tasa de fallos de página :
Por ejemplo, si un proceso causa un fallo de página en uno de cada 1000 accesos —es decir, — el tiempo de acceso efectivo es de 8,2 μs, por lo que el rendimiento del sistema es 40 veces inferior debido a la paginación bajo demanda. Por tanto, es necesario mantener la tasa de fallos de página lo más baja posible para mantener un rendimiento adecuado.
Respecto a , el tiempo de acceso a la memoria en caso de acierto de página no se corresponde directamente con el tiempo de acceso a la memoria física . El motivo es que el sistema utiliza paginación, que recordemos que necesita varios accesos por cada dirección virtual, y que además puede usar una TLB para mejorar su rendimiento. Por tanto, es el tiempo de acceso efectivo que calculamos en «Paginación».
Por ejemplo, en «Tiempos de acceso a la memoria» vimos que el tiempo de acceso efectivo para el método básico de paginación con TLB era:
donde es la probabilidad de que una entrada esté en la TLB y es el tiempo de acceso a la memoria física. Si sustituimos esta expresión por el en:
que nos daría el tiempo de acceso efectivo a la memoria en paginación bajo demanda con una tabla de páginas lineal y TLB.
Mientras que si sustituimos el tiempo de acceso efectivo calculado en «Tiempos de acceso con paginación jerárquica»:
obtenemos el tiempo de acceso efectivo a la memoria en paginación bajo demanda con paginación jerárquica de niveles:
Sin embargo, debemos recordar que para obtener ambas expresiones estamos simplificando bajo la suposición de que . Si no podemos hacer esta suposición, podemos volver a la expresión original para , antes de la simplificación:
y repetir la sustitución de por las expresiones para calculadas en «Tiempos de acceso a la memoria» y «Tiempos de acceso con paginación jerárquica». Así obtenemos que el tiempo de acceso efectivo para tabla de páginas lineal con TLB y paginación bajo demanda es:
Mientras que para la paginación jerárquica de niveles es:
Manejo y uso del espacio de intercambio
Sección titulada «Manejo y uso del espacio de intercambio»Otro aspecto fundamental que afecta al rendimiento de la paginación bajo demanda es el uso del espacio de intercambio.
Cuando un proceso genera un fallo de página, el sistema operativo debe recuperar la página de allí donde esté almacenada. Si esto ocurre al principio de la ejecución, ese lugar seguramente será el archivo que contiene la imagen binaria del programa, pues es donde se encuentran las páginas en su estado inicial. Sin embargo, el acceso al espacio de intercambio es mucho más eficiente que el acceso a un sistema de archivos, incluso aunque el primero esté almacenado dentro de un archivo de gran tamaño. Esto es debido a que los datos se organizan en bloques contiguos de gran tamaño, se evitan las búsquedas de archivos y las indirecciones en la asignación de espacio. Por ello debemos plantearnos qué hacer con las imágenes de los programas que van a ser ejecutados.
-
Se puede mejorar el rendimiento copiando en el espacio de intercambio la imagen completa de los programas durante el inicio del proceso, para después realizar la paginación bajo demanda sobre dicha copia.
-
Otra alternativa es cargar las páginas desde el archivo que contiene la imagen cuando son usadas por primera vez, pero siendo escritas en el espacio de intercambio cuando dichas páginas tienen que ser reemplazadas. Esta aproximación garantiza que solo las páginas necesarias son leídas desde el sistema de archivos, reduciendo el uso de espacio de intercambio, mientras que las siguientes operaciones de intercambio se hacen sobre dicho espacio.
-
También se puede suponer que el código de los procesos no puede cambiar. Esto permite utilizar el archivo de la imagen binaria para recargar las páginas de código, lo que también evita escribirlas cuando son sustituidas. Sin embargo, el espacio de intercambio se sigue utilizando para las páginas que no están directamente asociadas a un archivo, como la pila o el montón de los procesos. Este último método parece conseguir un buen compromiso entre el tamaño del espacio de intercambio y el rendimiento. Por eso se utiliza en la mayor parte de los sistemas operativos modernos.
Copy-on-write
Sección titulada «Copy-on-write»El copy-on-write o copia durante la escritura permite la creación rápida de nuevos procesos, minimizando la cantidad de páginas que deben ser asignadas a estos.
Para entenderlo, es importante recordar que la llamada al sistema fork() crea un proceso hijo cuyo espacio de direcciones es un duplicado del espacio de direcciones del padre. Indudablemente, esto significa que durante la llamada es necesario asignar suficientes marcos de memoria física como para alojar las páginas del nuevo proceso hijo. El copy-on-write minimiza de la siguiente manera el número de marcos que deben ser asignados al nuevo proceso:
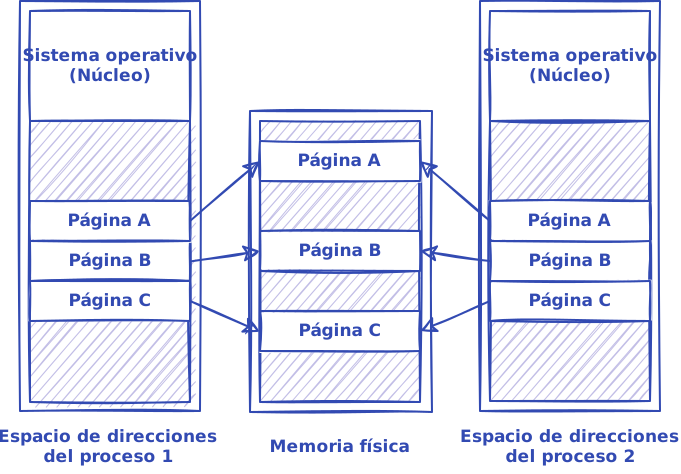
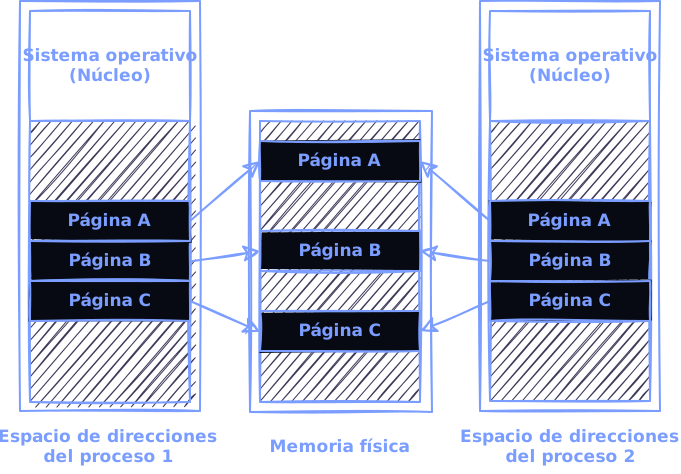
- Cuando la llamada al sistema fork() crea el nuevo proceso lo hace de forma que este comparta todas sus páginas con las del padre (ver la figura anterior). Sin el copy-on-write el fork() tendría que asignar marcos de memoria física al hijo, para a continuación copiar las páginas del padre en ellos. Sin embargo, con el copy-on-write padre e hijo mapean sus páginas en los mismos marcos, evitando tener que asignar memoria libre.
- Las páginas compartidas se marcan como copy-on-write. Para ello se pueden marcar todas las páginas como de solo lectura en la tabla de páginas de ambos procesos y utilizar una tabla interna alojada en el PCB para indicar cuáles son realmente de solo lectura y cuáles están en copy-on-write. Es importante destacar que realmente solo las páginas que pueden ser modificadas se marcan como copy-on-write. Las páginas que no pueden ser modificadas —por ejemplo, las que contienen el código ejecutable del programa— simplemente pueden ser compartidas como de solo lectura por los procesos, como hemos comentado anteriormente.
- Si algún proceso intenta escribir en una página copy-on-write, la MMU genera una excepción para notificar el suceso al sistema operativo. Siguiendo lo indicado en el punto anterior, la excepción se originaría porque la página está marcada como de solo lectura. El sistema operativo comprueba entonces si se trata de una página copy-on-write o de un intento real de escribir en una página de solo lectura. Para ello, el sistema solo tiene que mirar la tabla interna almacenada en el PCB. Si se ha intentado escribir en una página de solo lectura, el proceso ha cometido un error y generalmente será terminado.
- Si el sistema detecta una escritura a una página de copy-on-write solo tiene que copiarla en un marco libre y mapearlo en el espacio de direcciones del proceso (ver la siguiente figura). Para esto se sustituye la página compartida por otra que contiene una copia, pero que ya no está compartida. Obviamente, la nueva página debe ser marcada como de escritura para que en el futuro pueda ser modificada por el proceso.
- La página original marcada como copy-on-write puede ser marcada como de escritura y no como copy-on-write, pero solo si no va a seguir siendo compartida. Esto es así porque una página marcada como copy-on-write puede estar siendo compartida con otros procesos.
- El sistema operativo puede reiniciar el proceso. A partir de ahora, este puede escribir en la página sin afectar al resto de los procesos. Sin embargo, puede seguir compartiendo otras páginas en copy-on-write.
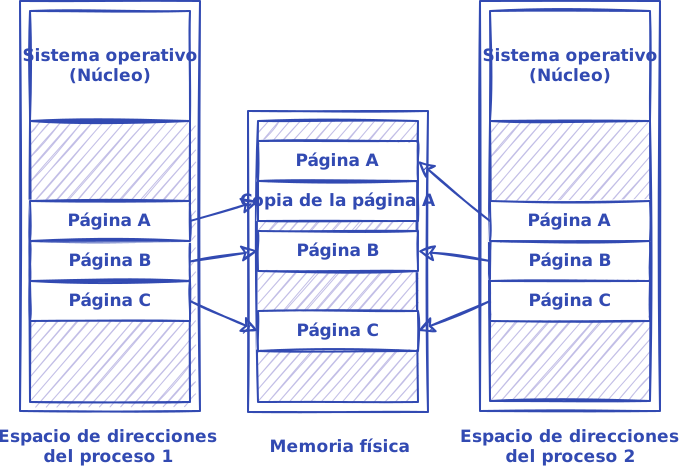
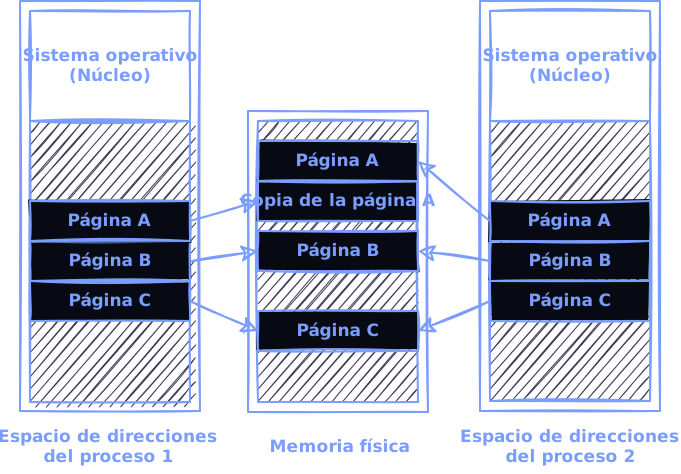
El copy-on-write permite ahorrar memoria y tiempo en la creación de los procesos, puesto que solo se copian las páginas que son modificadas por estos. Por eso se trata de una técnica común en múltiples sistemas operativos, como por ejemplo los sistemas POSIX modernos y Microsoft Windows.
El copy-on-write es especialmente interesante si a continuación se va a utilizar la llamada al sistema exec(), puesto que si es así, copiar el espacio de direcciones completo es una pérdida de tiempo.
El copy-on-write también permite a los sistemas modernos ahorrar memoria durante la reserva de grandes cantidades de memoria. Cuando un proceso pide reservar páginas de memoria, generalmente los sistemas deben proporcionar páginas con marcos sobrescritos con ceros, para evitar exponer los datos del proceso que los utilizó anteriormente. En previsión de esto, el sistema mantiene un marco completamente a 0 y durante las reservas de memoria proporciona páginas en copy-on-write sobre dicho marco a 0. De esta forma, se ahorra memoria física y tiempo de CPU, puesto que realmente no se asigna un marco de memoria física y se pone a 0 su contenido hasta el momento en el que el proceso intenta escribir en una página de memoria previamente reservada.
Archivos mapeados en memoria
Sección titulada «Archivos mapeados en memoria»Los archivos mapeados en memoria permiten acceder a un archivo como parte del espacio de direcciones virtuales de un proceso. Algunas de las características de esta técnica son:
-
Cuando una región del espacio de direcciones queda marcada para ser mapeada sobre una región de un archivo, se utiliza una estrategia similar a la comentada para el método básico de la paginación bajo demanda. La diferencia es que las páginas son cargadas desde dicho archivo y no desde el espacio de intercambio. Es decir, en un primer acceso a una página mapeada se produce un fallo de página que es resuelto por el sistema operativo leyendo una porción del archivo en el marco asignado a la página.
-
Esto significa que la lectura y escritura del archivo se realiza a través de lecturas y escrituras en la memoria, lo que simplifica el acceso y elimina el coste adicional de las llamadas al sistema read(), write(), etc.
-
Las escrituras en disco se suelen realizar de forma asíncrona. Es decir, los datos no se escriben inmediatamente en disco cuando se modifica la página, sino que el sistema operativo comprueba periódicamente las páginas modificadas y las escribe en disco.
-
Los marcos utilizados en el mapeo pueden ser compartidos, lo que permite compartir los datos de los archivos. Además, se puede incluir soporte de copy-on-write, lo que permite a los procesos compartir buena parte de un archivo en modo de solo lectura, pero disponiendo de sus propias copias de aquellas páginas que modifiquen. Indudablemente, para que los procesos puedan compartir datos es necesario que exista algún tipo de coordinación (ver el capítulo «Sincronización»).
Ejemplo Mapeo de un archivo en memoria
Sección titulada « Mapeo de un archivo en memoria»Tanto en los sistemas POSIX como en Windows API, el archivo que se va a mapear debe abrirse antes con la llamada al sistema destinada a ello. A partir de ahí las dos API divergen: en POSIX el descriptor del archivo se mapea directamente, mientras que en Windows API hace falta crear primero un objeto de mapeo de archivo que representa el mapeo y del que después se obtienen las vistas en memoria.
-
Abrir el archivo que se quiere mapear.
En los sistemas POSIX se usa open(), indicando el modo de apertura:
int fd = open( "foo.txt", O_RDONLY );Resultado
fdcontiene el descriptor del archivo, que se usará en el siguiente paso para mapearlo. -
Averiguar la longitud de la región del archivo que se va a mapear.
Si se quiere mapear el archivo completo, se puede consultar su tamaño con lseek():
off_t length = lseek( fd, 0, SEEK_END );Resultado
lengthcontiene el tamaño del archivo en bytes. -
Mapear el archivo en el espacio de direcciones del proceso, para obtener un puntero con el que acceder a su contenido.
El descriptor devuelto por open() se utiliza con mmap():
void* p = mmap(NULL,length,PROT_READ,MAP_SHARED,fd,0);Los permisos de la memoria mapeada deben ser compatibles con el modo con el que se abrió el archivo. El último argumento —el desplazamiento— indica en qué posición del archivo comienza el mapeo, por lo que debe ser múltiplo del tamaño de página. Junto con
lengthpermite mapear solo una parte del archivo en lugar de su totalidad.Resultado
papunta al contenido del archivo, al que se puede acceder como si estuviera en la memoria del proceso. -
Liberar los recursos.
Si no se van a crear más mapeos, el descriptor se puede cerrar con close() sin que ello afecte al mapeo ya establecido:
close( fd );munmap( p, length );Resultado munmap() deshace el mapeo, después de lo cual acceder a
pprovoca una violación de segmento.
-
Abrir el archivo que se quiere mapear.
En Microsoft Windows se usa CreateFile():
HANDLE hFile = CreateFile("foo.txt",GENERIC_READ,FILE_SHARE_READ,NULL,OPEN_EXISTING,FILE_ATTRIBUTE_NORMAL,NULL);Resultado
hFilecontiene el manejador del archivo abierto, que se usará en el siguiente paso. -
Crear el objeto de mapeo de archivo a partir del manejador del archivo abierto.
El manejador devuelto por CreateFile() se utiliza con CreateFileMapping():
HANDLE hMapFile = CreateFileMapping(hFile,NULL,PAGE_READONLY,0,0,NULL);La protección indicada debe ser compatible con el modo con el que se abrió el archivo.
Resultado
hMapFilecontiene el manejador del objeto de mapeo de archivo, que se usará en el siguiente paso para mapearlo. -
Mapear una vista del objeto en el espacio de direcciones del proceso, para obtener un puntero con el que acceder a su contenido.
El manejador devuelto por CreateFileMapping() se utiliza con MapViewOfFile():
LPVOID p = MapViewOfFile(hMapFile,FILE_MAP_READ,0,0,0);Resultado
papunta al contenido del archivo, que ya se puede acceder como si estuviera en la memoria del proceso. -
Liberar los recursos.
UnmapViewOfFile( p );CloseHandle( hMapFile );CloseHandle( hFile );Resultado UnmapViewOfFile() deshace el mapeo, mientras que CloseHandle() cierra los manejadores del objeto de mapeo y del archivo, como es habitual.
En mapped-files.cpp se puede ver un ejemplo de un programa que cuenta el número de líneas, palabras y caracteres de un archivo. Para acceder al archivo, primero lo mapea en memoria, para así poder acceder a su contenido sin tener que leerlo usando read(). Una vez ha terminado, libera la memoria mapeada.
Mapeo de archivos en el núcleo
Sección titulada «Mapeo de archivos en el núcleo»Algunos sistemas operativos ofrecen el servicio de mapeo de archivos en la memoria solo a través de una llamada al sistema concreta, permitiendo utilizar las llamadas estándar —read(), write(), etc.— para hacer uso de la E/S tradicional. Sin embargo, muchos sistemas modernos utilizan el mapeo en la memoria independientemente de que se pida o no.
Por ejemplo, en los sistemas POSIX, si un proceso utiliza la llamada al sistema mmap() es porque explícitamente pide que el archivo sea mapeado en memoria. Por tanto, el núcleo mapea el archivo en el espacio de direcciones del proceso.
Pero en Linux, Microsoft Windows y otros sistemas operativos modernos, adicionalmente, cuando un archivo es abierto con la llamada al sistema estándar —como open()— el archivo es mapeado en el espacio de direcciones del núcleo y las llamadas read() y write() son traducidas en accesos a la memoria en dicha región. No importa cómo sea abierto el archivo.
Estos sistemas tratan toda la E/S a archivos como mapeada en memoria, permitiendo que el acceso a los mismos tenga lugar a través del eficiente componente de gestión de la memoria.
Reemplazo de página
Sección titulada «Reemplazo de página»Hasta el momento hemos considerado que disponemos de memoria física suficiente para atender cualquier fallo de página, pero ¿qué ocurre cuando no quedan marcos libres? En ese caso el código que da servicio a la excepción de fallo de página debe escoger alguna página, intercambiarla con el disco y utilizar el marco de la misma para cargar la nueva página. Es decir, debemos modificar la función que ejecuta los pasos descritos en «Paginación bajo demanda» de la siguiente manera:
- Si la página es legal, debe ser cargada desde el disco.
- Buscar la localización de la página en disco.
- El núcleo debe buscar un marco de memoria libre que, por ejemplo, se puede escoger de la lista de marcos libres del sistema.
- Si hay uno, usarlo.
- Si no hay, usar un algoritmo de reemplazo de página para seleccionar una víctima.
- Escribir la víctima en el disco y cambiar las tablas de páginas y de marcos libres de acuerdo a la nueva situación. Para evitar mantener la CPU ocupada, el sistema debe solicitar la escritura de la página y poner al proceso en estado esperando.
- Se solicita una operación de disco para leer la página deseada en el marco asignado. Para evitar mantener la CPU ocupada, el sistema debe solicitar la lectura de la página y poner al proceso en estado esperando.
- Cuando la lectura del disco haya terminado, se debe modificar la tabla interna de páginas válidas, y la tabla de páginas para indicar que la página está en la memoria.
- Reiniciar la instrucción que fue interrumpida por la excepción.
Es importante destacar que en caso de reemplazo se necesita realizar dos accesos al disco. Esto se puede evitar utilizando un bit de modificado asociado a cada entrada en la tabla de páginas:
- Este bit es puesto a 1 por el hardware cuando se escribe en la página.
- Se puede evitar escribir en disco aquellas páginas que tienen este bit a 0 cuando son seleccionadas para reemplazo, siempre que el contenido de la página no haya sido sobrescrito por otra en el espacio de intercambio.
En general, para implementar la paginación bajo demanda necesitamos:
- Un algoritmo de asignación de marcos, que se encarga de asignar los marcos a los procesos.
- Un algoritmo de reemplazo de página para seleccionar qué página reemplazamos cuando no hay marcos suficientes.
Obviamente, estos algoritmos deben ser escogidos de forma que mantengan la tasa de fallos de página lo más baja posible para perjudicar en lo mínimo el rendimiento del sistema.
Algoritmos de reemplazo de páginas
Sección titulada «Algoritmos de reemplazo de páginas»Hay muchos algoritmos de reemplazo de página. La cuestión es cómo seleccionar uno en particular, sabiendo que debe tener la menor tasa posible de fallos de página.
Trazas de referencias
Sección titulada «Trazas de referencias»Podemos evaluar el algoritmo utilizando una secuencia de referencias a memoria y calculando el número de fallos de página. A dicha secuencia de referencias se la denomina trazas de referencias.
Las trazas pueden ser obtenidas aleatoriamente u obteniéndolas a partir de las que hace un proceso en un sistema real. Indudablemente, esta última alternativa puede proporcionar miles de millones de referencias. Para reducir el número de datos podemos hacer dos cosas:
-
De cada referencia solo necesitamos considerar el número de página.
-
Si tenemos una referencia a la página , cualquier referencia inmediatamente posterior a dicha página nunca provocará un fallo de página, por lo que podemos ignorarlas. Esto no tendría por qué ser cierto si consideramos que hay varios procesos en el sistema y unos pueden expropiar a los otros. Pero por simplicidad, ese no es nuestro caso.
Por ejemplo, si obtenemos la siguiente traza de un proceso particular:
0100, 0432, 0101, 0612, 0102, 0103, 0104, 0101, 0611, 0102, 0103,0104, 0101, 0610, 0102, 0103, 0104, 0101, 0609, 0102, 0105con páginas de 100 bytes, podemos reducirla a:
1, 4, 1, 6, 1, 6, 1, 6, 1, 6, 1Indudablemente, para determinar el número de fallos de página también debemos conocer el número de marcos disponibles para el proceso.
Reemplazo FIFO
Sección titulada «Reemplazo FIFO»El algoritmo de reemplazo de páginas FIFO es el más sencillo. Funciona de la siguiente manera:
- Se asocia a cada página el instante de tiempo en que fue cargada por última vez.
- Cuando hay que hacer reemplazo se selecciona como víctima a la página más antigua.
Realmente no es estrictamente necesario almacenar el instante de tiempo en que una página fue cargada. En su lugar, las páginas en memoria pueden ser almacenadas en una cola FIFO, puesto que así se conserva su orden de llegada en el tiempo, que es lo que nos interesa. Esta misma cola FIFO es utilizada en algunos algoritmos que veremos posteriormente.
Vamos a ilustrar este algoritmo con un ejemplo, donde supondremos que tenemos 3 marcos de memoria física:
| 7 | 0 | 1 | 2 | 0 | 2 | 0 | 2 | 4 | 0 | 2 | 0 | 1 | 3 | 0 | 1 | 2 | 7 | 0 | 1 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 7 | 7 | 7 | 2 | 2 | 2 | 1 | 1 | 1 | 7 | 7 | 7 | ||||||||
| 0 | 0 | 0 | 4 | 4 | 4 | 3 | 3 | 3 | 0 | 0 | |||||||||
| 1 | 1 | 1 | 0 | 0 | 0 | 2 | 2 | 2 | 1 | ||||||||||
| × | × | × | × | × | × | × | × | × | × | × | × |
Como se puede observar, las primeras 3 referencias generan fallos de página porque se supone que los marcos no están asignados a ninguna página. A partir de ahí se utiliza el algoritmo de reemplazo FIFO para seleccionar una página cuyo marco es utilizado para cargar la página requerida por el proceso.
El algoritmo FIFO no siempre tiene un buen rendimiento:
-
Puesto que utiliza el orden en el tiempo, puede reemplazar tanto páginas que no están siendo utilizadas como páginas usadas frecuentemente. Sin embargo, aunque esto pase, todo seguirá funcionando correctamente, aunque aumentará la tasa de fallos de página ralentizando el sistema.
-
No siempre que aumenta la cantidad de memoria disponible mejora el rendimiento.
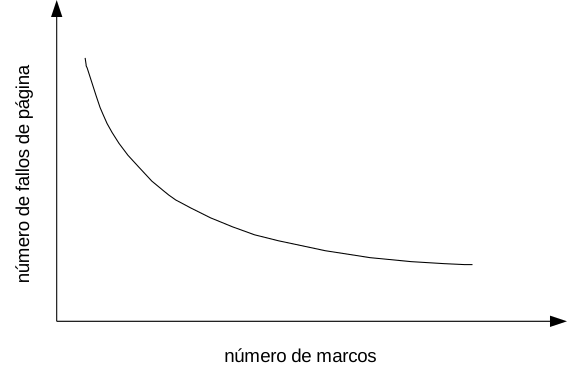
Es de esperar que si el número de marcos disponibles aumenta, el número de fallos de página disminuya (ver la figura anterior). Sin embargo, con el algoritmo FIFO el número de fallos de página puede aumentar cuando el número de marcos disponibles se incrementa. Es lo que se conoce como la anormalidad de Belady.
Para ilustrarlo consideraremos la siguiente traza de referencias:
1, 2, 3, 4, 1, 2, 5, 1, 2, 3, 4, 5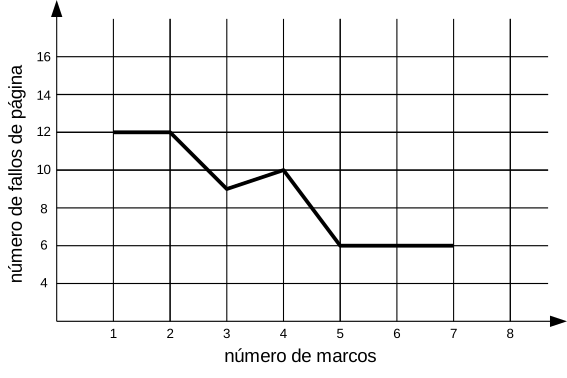
La figura anterior muestra la curva de fallos de página frente al número de marcos. Como se puede apreciar, el número de fallos de página con cuatro marcos es superior al número de fallos con tres marcos, aunque era de esperar que el número de fallos de páginas decreciera al aumentar el número de marcos.
Reemplazo óptimo
Sección titulada «Reemplazo óptimo»Como resultado del descubrimiento de la anormalidad de Belady se comenzó a buscar un algoritmo de reemplazo de página óptimo. Es decir:
- Que tuviera la tasa de fallo de página más baja posible.
- Que nunca sufra de la anormalidad de Belady.
Ese algoritmo existe y consiste en reemplazar la página que no va a ser utilizada en el mayor periodo de tiempo.
| 7 | 0 | 1 | 2 | 0 | 2 | 0 | 2 | 4 | 0 | 2 | 0 | 1 | 3 | 0 | 1 | 2 | 7 | 0 | 1 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 7 | 7 | 7 | 2 | 2 | 2 | 3 | 2 | 2 | |||||||||||
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | ||||||||||||
| 1 | 1 | 4 | 1 | 1 | 1 | 7 | |||||||||||||
| × | × | × | × | × | × | × | × | × |
Desafortunadamente, el algoritmo de reemplazo óptimo es difícil de implementar, puesto que necesita saber las páginas que serán referenciadas en el futuro. Por lo que solo se usa en estudios comparativos, con el fin de saber cuánto se aproxima al óptimo un algoritmo de reemplazo determinado.
Reemplazo LRU
Sección titulada «Reemplazo LRU»El algoritmo de reemplazo de página LRU (Least Recently Used) es una aproximación del óptimo. La hipótesis es que una página que no se ha usado durante un largo periodo de tiempo probablemente tampoco se utilice en el futuro. Por eso, reemplazando la que hace más tiempo que no se usa, nos aproximamos al algoritmo óptimo. Vamos a ilustrarlo con un ejemplo:
| 7 | 0 | 1 | 2 | 0 | 2 | 0 | 2 | 4 | 0 | 2 | 0 | 1 | 3 | 0 | 1 | 2 | 7 | 0 | 1 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 7 | 7 | 7 | 2 | 2 | 2 | 3 | 2 | 2 | 2 | 1 | |||||||||
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 7 | 7 | 7 | ||||||||||
| 1 | 1 | 4 | 1 | 1 | 1 | 1 | 0 | 0 | |||||||||||
| × | × | × | × | × | × | × | × | × | × | × |
Este algoritmo se considera bastante eficiente cuando se aplica al reemplazo de páginas, por lo que es utilizado con frecuencia.
Un detalle significativo es que necesita asociar cada página con el momento en que fue utilizada por última vez. Aunque se pueden utilizar interrupciones para implementarlo por software —monitorizando cada acceso a la memoria— esta solución es muy ineficiente, puesto que se necesitaría actualizar algunos datos en la memoria en cada referencia a una página. Por ello el reemplazo LRU es inconcebible sin apoyo del hardware.
Son posibles dos implementaciones:
-
Utilizando contadores:
- La CPU debe tener un reloj lógico o contador que se incrementa con cada referencia a la memoria.
- A cada página se añade un campo de instante de uso, que se almacena en la entrada de la tabla de páginas correspondiente.
- Cuando una página es referenciada, el valor del contador de la CPU se almacena en el campo de instante de uso de dicha página.
Esta implementación requiere que se haga una escritura en la memoria con cada referencia, además de una búsqueda por toda la tabla de páginas para localizar la página LRU.
-
Utilizando una pila:
- Se utiliza una pila de números de página.
- Si se referencia una página, se quita el número correspondiente de la mitad de la pila y se inserta arriba. Debido a esto, lo mejor es implementarla como una lista doblemente enlazada.
La actualización de la pila —que debe realizarse en cada referencia— tiene mayor coste que en la implementación anterior, pues puede ser necesario cambiar hasta 6 punteros. Sin embargo, no es necesario realizar ninguna búsqueda para seleccionar la víctima del reemplazo, puesto que esta se puede extraer directamente del final de la pila. Es una estrategia ideal para ser implementada en software o microcódigo.
El algoritmo de reemplazo LRU pertenece a una clase denominada algoritmos de pila, que nunca se ven afectados por la anormalidad de Belady. En estos algoritmos, las páginas en memoria en un instante dado para marcos son un subconjunto de las que podría haber con marcos. Concretamente, en el algoritmo LRU las páginas en los marcos son las páginas más referenciadas recientemente. Si el número de marcos aumentase, estas páginas seguirán estando en memoria, pues siguen siendo las referenciadas más recientemente.
Reemplazo LRU aproximado
Sección titulada «Reemplazo LRU aproximado»Pocos sistemas tienen soporte para utilizar el algoritmo de reemplazo de página LRU. Incluso en algunos casos no hay soporte de ningún tipo, por lo que no queda más remedio que utilizar el reemplazo FIFO.
Sin embargo, muchos proporcionan algo de ayuda en la forma de un bit de referencia:
- Cada entrada de la tabla de páginas tiene un bit de referencia.
- El hardware pone a 1 el bit de referencia cada vez que se referencia a una página.
Con el bit de referencia no podemos saber con exactitud el instante, pero sí que una página ha sido referenciada recientemente. Utilizándolo, podemos implementar diversas aproximaciones al algoritmo LRU, que veremos en los siguientes apartados.
Reemplazo NRU
Sección titulada «Reemplazo NRU»En el algoritmo de reemplazo de página NRU se utiliza el bit de referencia de la siguiente manera:
- En intervalos regulares de tiempo, todos los bits de referencia son puestos a cero por el sistema operativo.
- Según los procesos se van ejecutando, el bit de referencia asociado a cada página se pone a 1 por el hardware, al ser referenciadas.
- Cuando haya que escoger una página para ser reemplazada, se intenta seleccionar una que no haya sido referenciada —es decir, con el bit de referencia a 0—.
- En caso de que haya varias alternativas entre las que elegir se puede utilizar el algoritmo de reemplazo de página FIFO o escoger una aleatoriamente.
Vamos a ilustrarlo con un ejemplo:
- Utilizaremos 3 marcos de página.
- Indicaremos el valor del bit de referencia sobre el número de página, en la misma celda.
- Marcaremos con una flecha el instante de tiempo en el que todos los bits de referencia se ponen a cero. Obviamente, en un sistema real ese instante llega a intervalos fijos de tiempo, que no equivalen a una cantidad fija de referencias en la traza, porque hemos eliminado las referencias consecutivas a una misma página.
- Tras cada fallo de página se reinicia la instrucción que lo provocó, así que habrá un acceso más que pone el bit de referencia a 1.
- En caso de coincidencia, utilizaremos el reemplazo FIFO para seleccionar la víctima.
| 7 | 0 | 1 | 2 | 0 | 2 | 0 | 2 | 4 | 0 | 2 | 0 | 1 | 3 | 0 | 1 | 2 | 7 | 0 | 1 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| ↓ | ↓ | ↓ | ↓ | ↓ | |||||||||||||||
| 17 | 17 | 17 | 12 | 02 | 12 | 12 | 12 | 12 | 12 | 12 | 12 | 12 | 13 | 03 | 03 | 12 | 02 | 02 | 11 |
| 10 | 10 | 10 | 10 | 10 | 10 | 00 | 14 | 14 | 04 | 04 | 11 | 11 | 01 | 11 | 11 | 01 | 10 | 10 | |
| 11 | 11 | 01 | 01 | 01 | 01 | 01 | 10 | 00 | 10 | 10 | 10 | 10 | 10 | 10 | 17 | 17 | 17 | ||
| × | × | × | × | × | × | × | × | × | × | × | × |
Se puede mejorar el algoritmo anterior considerando tanto el bit de referencia como el bit de modificado, para clasificar las páginas en distintas categorías y escoger una página en la mejor categoría. Este es el tipo más común de algoritmo de reemplazo de página NRU, pero lo veremos en «Algoritmo de la segunda oportunidad mejorado».
Con bits de referencia adicionales
Sección titulada «Con bits de referencia adicionales»Podemos obtener información adicional sobre el orden en que se realizan las referencias, guardando los bits de referencia en intervalos periódicos de tiempo. El reemplazo LRU aproximado con bits de referencia adicionales, o de envejecimiento, consiste en lo siguiente:
- Aparte del bit de referencia, cada página tiene un conjunto de bits de referencia adicionales —por ejemplo, 8 bits— que se guardan en alguna tabla interna que mantiene el sistema operativo.
- A intervalos regulares —por ejemplo, cada 100 ms— el sistema operativo desplaza los bits de referencia adicionales de cada página, insertando el bit de referencia de la página en el bit de orden más alto y descartando el bit de orden más bajo.
- Cuando haya que escoger una página para ser reemplazada se escoge la que tenga el valor más pequeño en el conjunto de bits de referencia adicionales. Esto es así, puesto que dicho conjunto contiene la historia de referencias de la página. Por ejemplo, es más reciente que .
- Se puede utilizar el algoritmo de reemplazo de página FIFO o escoger una aleatoriamente, si dos páginas tienen el mismo valor.
Vamos a ilustrarlo con un ejemplo:
- Utilizaremos 3 marcos de página.
- Utilizaremos 2 bits adicionales.
- Indicaremos sobre el número de página, en la misma celda, el valor del bit de referencia, en primer lugar, seguido del de los bits adicionales.
- Marcaremos con una flecha el instante de tiempo en el que los bits son desplazados por el sistema operativo.
- En caso de coincidencia, utilizaremos el reemplazo FIFO para seleccionar la víctima.
| 7 | 0 | 1 | 2 | 0 | 2 | 0 | 2 | 4 | 0 | 2 | 0 | 1 | 3 | 0 | 1 | 2 | 7 | 0 | 1 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| ↓ | ↓ | ↓ | ↓ | ↓ | |||||||||||||||
| 1007 | 1007 | 1007 | 1002 | 0102 | 1102 | 1102 | 1112 | 1112 | 1112 | 1112 | 1112 | 1112 | 1112 | 0112 | 0112 | 1112 | 0112 | 0112 | 0112 |
| 1000 | 1000 | 1000 | 1100 | 1100 | 1100 | 0110 | 0110 | 1110 | 0110 | 1110 | 1110 | 1110 | 1110 | 1110 | 1110 | 0110 | 1110 | 1110 | |
| 1001 | 1001 | 0101 | 0101 | 0101 | 0011 | 1004 | 1004 | 0104 | 0104 | 1001 | 1003 | 0103 | 1001 | 1001 | 1007 | 1007 | 1001 | ||
| × | × | × | × | × | × | × | × | × | × |
El número de bits adicionales puede variar de una implementación a otra, pero en cualquier caso debe ser seleccionado para realizar la actualización lo más rápidamente posible, teniendo en cuenta las características del hardware. En un caso extremo, el número de bits de referencia adicionales podría ser cero, dejando solo el bit de referencia. A este algoritmo se lo conoce como el algoritmo de la segunda oportunidad.
Algoritmo de la segunda oportunidad
Sección titulada «Algoritmo de la segunda oportunidad»El algoritmo de reemplazo de la segunda oportunidad o del reloj es un algoritmo de reemplazo de página FIFO, pero donde una página es seleccionada considerando el bit de referencia:
- Cuando es necesario seleccionar una víctima para reemplazo se extrae una página de la cola FIFO. Esta cola contiene todas las páginas con marcos asignados y en el orden en que fueron cargadas, como ocurre con el algoritmo FIFO de reemplazo.
- Si el bit de referencia está a 0, se utiliza esta página para reemplazo.
- Si el bit de referencia está a 1:
- Se pone el bit de referencia a 0 y se vuelve a insertar la página en el final de la cola.
- Se extrae la siguiente página del principio de la cola y se vuelve al punto 2.
De este esquema podemos destacar algunos aspectos:
-
Una página a la que se le da la segunda oportunidad no será reemplazada hasta que se les haya dado también a todas las demás. Y si antes de que le llegue el turno vuelve a ser referenciada, su bit de referencia se pone otra vez a 1 y se le concede una oportunidad más.
-
En el peor de los casos, cuando todas las páginas tienen sus bits a uno, degenera en un reemplazo FIFO.
Vamos a ilustrarlo con un ejemplo:
- Utilizaremos 3 marcos de página.
- Indicaremos el valor del bit de referencia sobre el número de página del marco, en la misma celda.
- Indicaremos el principio de la cola con un triángulo en el borde izquierdo de la celda.
| 7 | 0 | 1 | 2 | 0 | 2 | 0 | 2 | 4 | 0 | 2 | 0 | 1 | 3 | 0 | 1 | 2 | 7 | 0 | 1 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 17 | 17 | →17 | 12 | 02 | 12 | 12 | →12 | →12 | →12 | →12 | 11 | 11 | →11 | →11 | 12 | 12 | 12 | →02 | |
| → | 10 | 10 | →00 | →10 | →10 | →10 | 00 | 10 | 10 | 10 | →00 | 13 | 13 | 13 | →03 | 17 | 17 | 07 | |
| → | 11 | 01 | 01 | 01 | 01 | 14 | 14 | 14 | 14 | 04 | →04 | 10 | 10 | 10 | →10 | →10 | 11 | ||
| × | × | × | × | × | × | × | × | × | × | × |
Algoritmo de la segunda oportunidad mejorado
Sección titulada «Algoritmo de la segunda oportunidad mejorado»Se puede mejorar el algoritmo de la segunda oportunidad considerando tanto el bit de referencia como el bit de modificado. Algunos autores denominan a este algoritmo como algoritmo de la segunda oportunidad mejorado, mientras otros lo llaman NRU, ya que es una versión mejorada del algoritmo de «Reemplazo NRU».
Con esos dos bits, el sistema operativo clasifica las páginas en una de las siguientes cuatro clases:
- (0,0) ni usada recientemente ni modificada. Las páginas de esta clase son las mejores para ser reemplazadas.
- (0,1) no usada recientemente pero modificada. No es una buena elección, puesto que hay que escribir primero la página al disco antes del reemplazo.
- (1,0) usada recientemente pero no modificada. Probablemente será usada de nuevo en un corto espacio de tiempo.
- (1,1) usada y modificada. Será utilizada pronto y la página tendría que ser escrita a disco para ser reemplazada.
Cuando el reemplazo de página es invocado:
-
Se examina la clase a la que pertenece cada página y se reemplaza una página en la clase de menor importancia que no esté vacía. Indudablemente, deberemos examinar la lista varias veces antes de encontrar la página que debe ser reemplazada.
-
A intervalos regulares los bits de referencia de todas las páginas son puestos a cero por el sistema operativo.
Vamos a ilustrarlo con un ejemplo:
- Utilizaremos 3 marcos de página.
- El que la referencia a la memoria sea para lectura
ro escriturawvendrá indicado junto al número de página en la traza. - Marcaremos con una flecha el instante de tiempo en el que todos los bits de referencia se ponen a cero.
- Indicaremos el valor del bit de referencia y del bit de modificado sobre el número de página del marco, en la misma celda.
- Indicaremos el principio de la cola con un triángulo en el borde izquierdo de la celda. Sirve para mantener un orden en las páginas, de tal forma que si hay varios candidatos de la misma categoría, se escoja el primero encontrado. Si, por ejemplo, la elección en caso de varios candidatos es aleatoria, no hace falta ese puntero.
| 7r | 0r | 1w | 2r | 0r | 2r | 0w | 2r | 4w | 0w | 2r | 0r | 1r | 3w | 0r | 1r | 2w | 7w | 0r | 1r |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| ↓ | ↓ | ↓ | ↓ | ↓ | |||||||||||||||
| 107 | 107 | →107 | 102 | 002 | 102 | 102 | 102 | 102 | →102 | →102 | →102 | 102 | 113 | 013 | 013 | 112 | 012 | 012 | 101 |
| → | 100 | 100 | →100 | →100 | →100 | →110 | →010 | 114 | 114 | 014 | 014 | 101 | →101 | →001 | →101 | →101 | 117 | 117 | →117 |
| → | 111 | 111 | 011 | 011 | 011 | 011 | →011 | 110 | 010 | 110 | →110 | 110 | 110 | 110 | 110 | →010 | →110 | 110 | |
| × | × | × | × | × | × | × | × | × | × | × |
Reemplazo basado en contador
Sección titulada «Reemplazo basado en contador»Otros algoritmos utilizan un contador del número de referencias que son realizadas a cada página. En esos casos, la elección de la víctima se puede realizar utilizando dos esquemas: la que tiene el valor mayor o el menor. Ninguno de los dos es muy común, ya que su implementación es costosa y no son una buena aproximación del óptimo.
Por lo general, la actualización del contador no la realiza la CPU, ya que leer la entrada de la página, incrementar el contador y volver a guardar la entrada tiene un coste importante. En su lugar:
- El contador de cada página se guarda en una tabla interna.
- Periódicamente el sistema operativo examina el bit de referencia de cada página y si está a 1, incrementa el contador de la página correspondiente.
El mayor problema es que permite hacer el seguimiento de la frecuencia con la que se usan las páginas, pero no tiene en cuenta el periodo durante el que se usan. Por ejemplo, los procesos durante su inicialización pueden usar intensamente ciertas páginas y después no necesitarlas más. Debido a que esas páginas han sido utilizadas intensamente, tienen un contador de referencias con un valor muy alto, por lo que son mantenidas en memoria aunque no vayan a ser utilizadas.
La solución es utilizar el algoritmo LRU aproximado con bits de referencia adicionales porque tiene un coste muy similar a este y prioriza las usadas más recientemente sobre las que fueron usadas con mucha frecuencia en el pasado.
Reemplazo LFU
Sección titulada «Reemplazo LFU»En el algoritmo de reemplazo de página LFU (Least Frequently Used) se escoge la página con el contador más bajo. Esto es así, puesto que se supone que las páginas menos referenciadas son las que no se están utilizando de forma más activa.
Vamos a ilustrarlo con un ejemplo:
- Indicaremos el valor de los contadores sobre el número de página, en la misma celda.
- En caso de coincidencia, utilizaremos el reemplazo FIFO para seleccionar la víctima.
| 7 | 0 | 1 | 2 | 0 | 2 | 0 | 2 | 4 | 0 | 2 | 0 | 1 | 3 | 0 | 1 | 2 | 7 | 0 | 1 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 17 | 17 | 17 | 12 | 02 | 22 | 22 | 32 | 32 | 32 | 42 | 42 | 42 | 42 | 42 | 42 | 52 | 52 | 52 | 52 |
| 10 | 10 | 10 | 20 | 20 | 30 | 30 | 30 | 40 | 40 | 50 | 50 | 50 | 60 | 60 | 60 | 60 | 70 | 70 | |
| 11 | 11 | 11 | 11 | 11 | 11 | 14 | 14 | 14 | 10 | 11 | 13 | 13 | 11 | 11 | 17 | 17 | 11 | ||
| × | × | × | × | × | × | × | × | × | × | × | × |
El algoritmo LFU también tiene versiones aproximadas, puesto que actualizar el contador de cada página en cada referencia es costoso y necesita un soporte del hardware que no siempre está disponible. La aproximación más común es el NFU (Not Frequently Used), que utiliza el bit de referencia y un temporizador para actualizar los contadores periódicamente. Así, solo incrementa el contador de una página si ha sido referenciada en el intervalo de tiempo anterior. Se diferencia del NRU en que este solo mira el bit en el momento de escoger la víctima, mientras que el NFU acumula en su contador la historia de todos los intervalos anteriores. Como ese contador nunca olvida, su variante habitual le añade el envejecimiento, que lo desplaza tras cada periodo para que las referencias recientes pesen más que las antiguas.
Reemplazo MFU
Sección titulada «Reemplazo MFU»En el algoritmo de reemplazo de página MFU (Most Frequently Used) se escoge la página con el contador más alto. Se basa en el argumento de que la página con el contador más pequeño probablemente acaba de ser traída, por lo que aún no ha sido utilizada.
Vamos a ilustrarlo con un ejemplo:
- Indicaremos el valor de los contadores sobre el número de página, en la misma celda.
- En caso de coincidencia, utilizaremos el reemplazo FIFO para seleccionar la víctima.
| 7 | 0 | 1 | 2 | 0 | 2 | 0 | 2 | 4 | 0 | 2 | 0 | 1 | 3 | 0 | 1 | 2 | 7 | 0 | 1 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 17 | 17 | 17 | 12 | 12 | 22 | 22 | 32 | 32 | 10 | 10 | 20 | 11 | 11 | 11 | 21 | 12 | 12 | 12 | 12 |
| 10 | 10 | 10 | 20 | 20 | 30 | 30 | 14 | 14 | 14 | 14 | 14 | 13 | 13 | 13 | 13 | 17 | 17 | 17 | |
| 11 | 11 | 11 | 11 | 11 | 11 | 11 | 11 | 12 | 12 | 12 | 12 | 10 | 10 | 10 | 10 | 20 | 11 | ||
| × | × | × | × | × | × | × | × | × | × | × | × | × |
Por extraña que parezca esta política, suele ser más eficiente que el LRU cuando se utiliza en las aplicaciones de almacenamiento de datos, porque algunas páginas se utilizan intensamente durante breves periodos de tiempo, pero están un tiempo sin utilizarse.
Algoritmos de buffering de páginas
Sección titulada «Algoritmos de buffering de páginas»Existen otros procedimientos que pueden ser utilizados, junto con alguno de los algoritmos de reemplazo comentados, con el objetivo de mejorar su eficiencia. Estos procedimientos se agrupan dentro de lo que se denomina algoritmos de buffering de páginas.
-
Se puede mantener una lista de marcos libres. Cuando se produce un fallo de página se escoge un marco de la lista y se carga la página, al tiempo que se selecciona una página como víctima y se copia al disco. Esto permite que el proceso se reinicie lo antes posible, sin esperar a que la página reemplazada sea escrita en el disco. Posteriormente, cuando la escritura finalice, el marco es incluido en la lista de marcos libres.
-
Recordar qué página estuvo en cada marco antes de que este pasara a la lista de marcos libres sería una mejora de lo anterior. De esta forma las páginas podrían ser recuperadas directamente desde la lista, si fallara alguna antes de que su marco sea utilizado por otra página. Esto permite reducir los efectos de que el algoritmo de reemplazo escoja una víctima equivocada.
-
Se puede mantener una lista de páginas modificadas y escribirlas cuando el dispositivo del espacio de intercambio no esté ocupado. Este esquema aumenta la probabilidad de que una página no esté marcada como modificada —con el bit de modificado— cuando sea seleccionada por el algoritmo de reemplazo, evitando tener que hacer en ese momento la escritura en disco.
Reemplazo local frente a global
Sección titulada «Reemplazo local frente a global»Cuando un proceso necesita un marco, el algoritmo de reemplazo puede tanto extraerlo de cualquier proceso como ser obligado a considerar solo aquellas páginas que pertenecen al proceso que generó el fallo. Eso permite clasificar los algoritmos de reemplazo en dos categorías:
-
En el reemplazo local solo se pueden escoger marcos de entre los asignados al proceso. Por tanto:
- El número de marcos asignados a un proceso no cambia porque ocurran fallos de página.
- El mayor inconveniente es que un proceso no puede hacer disponibles a otros procesos los marcos de memoria que menos utiliza.
-
En el reemplazo global se pueden escoger marcos de entre todos los del sistema, independientemente de que estén asignados a otro proceso o no. Por tanto:
- El número de marcos asignados a un proceso puede aumentar si durante los fallos de página se seleccionan marcos de otros procesos.
- El mayor inconveniente es que los procesos no pueden controlar su tasa de fallos de página, puesto que esta depende del comportamiento de los otros procesos, pudiendo afectar a su tiempo de ejecución de forma significativa.
Generalmente, el reemplazo global proporciona mayor rendimiento, por lo que es el método más utilizado.
Asignación de marcos de página
Sección titulada «Asignación de marcos de página»La cuestión que queda por resolver es cómo repartir los marcos de memoria física libre entre los diferentes procesos, con el fin de cubrir las necesidades de reemplazo de cada uno de ellos. Posibles soluciones a esto serían repartir la memoria por igual entre todos los procesos o hacerlo en proporción a la cantidad de memoria virtual que utilizan.
Sin embargo, intuitivamente parece interesante intentar estimar de alguna manera el mínimo número de marcos que realmente necesita cada proceso. Así, si a cada proceso se le proporciona el número mínimo de marcos necesario, al sistema le queda memoria libre. Con ella puede aumentar el número de procesos —y con ello el uso de la CPU— o dedicarla a otras funciones, como los búferes y las cachés de E/S.
El mínimo número de marcos viene establecido por diversos factores:
-
Cuando ocurre un fallo de página, la instrucción que lo ha provocado debe ser reiniciada después de cargar la página en un marco libre. Por lo tanto, un proceso debe disponer de suficientes marcos como para guardar todas las páginas a las que una única instrucción pueda acceder pues, de lo contrario, el proceso nunca podría ser reiniciado al fallar permanentemente en alguno de los accesos a memoria de la instrucción. Obviamente, este límite viene establecido por la arquitectura de la máquina.
-
Todo proceso tiene una cierta cantidad de páginas que en cada instante son utilizadas frecuentemente. Si el proceso no dispone de suficientes marcos como para alojar dichas páginas, generará fallos de página con demasiada frecuencia. Esto afecta negativamente al rendimiento del sistema, por lo que es conveniente que el sistema le asigne el número de marcos necesario para que eso no ocurra.
En general, si se va reduciendo el número de marcos asignados a un proceso, mucho antes de haber alcanzado el mínimo establecido por la arquitectura, el proceso dejará de ser útil debido a la elevada tasa de fallos de página, que será mayor cuantos menos marcos tenga asignados. Cuando eso ocurre se dice que el proceso está hiperpaginando.
Hiperpaginación
Sección titulada «Hiperpaginación»Como hemos comentado, la hiperpaginación se produce cuando un proceso no dispone de suficientes marcos como para alojar todas las páginas que necesita con frecuencia, por lo que la tasa de fallos de página se vuelve muy elevada.
Se dice que un proceso sufre de hiperpaginación cuando gasta más tiempo paginando que ejecutándose.Hiperpaginación en sistemas multiprogramados
Sección titulada «Hiperpaginación en sistemas multiprogramados»En los primeros sistemas multiprogramados —mainframes— que implementaron la paginación bajo demanda, era posible que se diera el siguiente caso:
- El sistema operativo monitorizaba el uso de la CPU. Si el uso de la misma era bajo, se cargaban nuevos procesos desde la cola de entrada para aumentar el número de procesos ejecutándose al mismo tiempo —también llamado grado de multiprogramación en esos sistemas—.
- Si un proceso necesitaba demasiada memoria, le podía quitar los marcos a otro, puesto que se utilizaba un algoritmo de reemplazo global. Esto podía ocasionar que aumentara la tasa de fallos de página del proceso que perdía los marcos.
- Al aumentar los fallos de página el uso de la CPU decrecía, por lo que el sistema operativo cargaba más procesos para aumentar el grado de multiprogramación y con ello el uso de la CPU.
- Esto reducía la cantidad de memoria disponible para cada proceso, lo que aumentaba la tasa de fallos de página, que nuevamente reducía el uso de la CPU.
- Este mecanismo iteraba hasta reducir considerablemente el rendimiento del sistema.
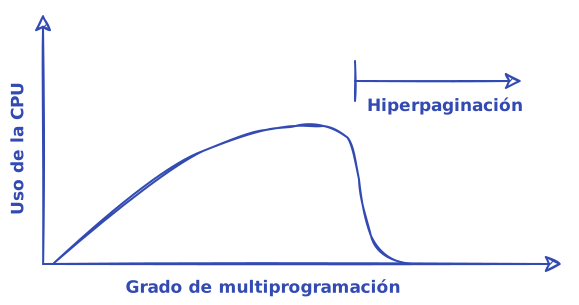
El fenómeno comentado se ilustra en la figura anterior, donde se muestra el uso de la CPU frente al número de procesos cargados en el sistema. Cuando esto último aumenta, el uso de la CPU aumenta hasta alcanzar un máximo. Si el grado de multiprogramación supera dicho punto, el sistema comienza a hiperpaginar, por lo que el uso de la CPU disminuye bruscamente.
Una solución es introducir un planificador de medio plazo que detecte si el sistema está hiperpaginando, en cuyo caso suspende y saca algunos procesos de la memoria —reduciendo así el grado de multiprogramación— con el objeto de liberar memoria para el resto de procesos en ejecución.
Hiperpaginación en sistemas operativos modernos
Sección titulada «Hiperpaginación en sistemas operativos modernos»Los sistemas de tiempo compartido posteriores y los sistemas operativos modernos no tienen ni planificador de largo plazo ni cola de entrada, por lo que no ocurre el efecto en cadena descrito en el caso de los sistemas multiprogramados. Sin embargo, puede ocurrir la hiperpaginación si se ejecutan demasiados procesos a la vez y alguno no dispone de suficientes marcos para alojar las páginas que utiliza con frecuencia (ver el apartado «Modelo del conjunto de trabajo»). Su tasa de fallos de página aumenta entonces hasta el punto de que el proceso pasa más tiempo paginando que ejecutándose.
Los sistemas operativos modernos suelen carecer de planificador de medio plazo por lo que, a diferencia de los sistemas multiprogramados, no suspenden completamente la ejecución de algunos procesos para reducir el consumo de memoria y evitar la hiperpaginación. En su lugar, utilizan técnicas de memoria virtual para ajustar la cantidad de marcos asignados a cada proceso, intentando evitar la hiperpaginación, al tiempo que maximizan el número de procesos que se pueden ejecutar simultáneamente.
En cualquier caso, como veremos en «Modelo del conjunto de trabajo», habrá hiperpaginación si la cantidad mínima total de marcos que necesitan todos los procesos para evitarla excede el número de marcos disponibles en el sistema.
Soluciones a la hiperpaginación
Sección titulada «Soluciones a la hiperpaginación»Para el problema de la hiperpaginación existen diversas soluciones:
-
La principal solución es proporcionar a un proceso tantos marcos como le hagan falta. Como ya hemos comentado en diversas ocasiones, para evitar la hiperpaginación es necesario asignar al proceso al menos un número mínimo de marcos, que a priori no es conocido, ya que depende de cómo se comporta el proceso en su uso de la memoria. Una de las estrategias que pretenden estimar dicho número es el modelo de conjunto de trabajo, que veremos en «Modelo del conjunto de trabajo».
-
Utilizar un algoritmo de reemplazo local puede limitar el problema, pues de esta manera un proceso que hiperpagina no puede quitar marcos a otro, quizás incrementando su tasa de fallos de página y causando que también hiperpagine. Sin embargo, un algoritmo de reemplazo local no evita completamente que un proceso que hiperpagine afecte a otros. El uso intensivo del dispositivo de intercambio, por parte del proceso que hiperpagina, puede afectar al rendimiento del sistema al aumentar el tiempo de acceso efectivo al disco.
Modelo del conjunto de trabajo
Sección titulada «Modelo del conjunto de trabajo»Para entender el modelo de conjunto de trabajo es necesario comenzar definiendo el modelo de localidad. El modelo de localidad establece que:
- Una localidad es un conjunto de páginas que se utilizan juntas.
- Cuando un proceso se ejecuta, se va moviendo de una localidad a otra.
Por ejemplo, cuando se invoca una función se define una nueva localidad. En esta localidad las referencias a la memoria se realizan al código de la función, a las variables locales de la misma y a algunas variables globales del programa.
Supongamos que proporcionamos a un proceso suficientes marcos como para alojar toda su localidad en un momento dado. Entonces, el proceso generará fallos de página hasta que todas las páginas de su localidad estén cargadas. Después de eso no volverá a fallar hasta que no cambie a una nueva localidad. Sin embargo, si damos al proceso menos marcos de los que necesita su localidad, este hiperpaginará.
El modelo de conjunto de trabajo es una estrategia que permite obtener una aproximación de la localidad del programa y consiste en lo siguiente:
- Definir el parámetro como el tamaño de la ventana del conjunto de trabajo.
- En un instante dado, el conjunto de páginas presente en las últimas referencias a la memoria se consideran el conjunto de trabajo.
- Por lo tanto, el conjunto de trabajo es una aproximación de la localidad del programa.
Por ejemplo, dada la siguiente lista de referencias a páginas en la memoria:
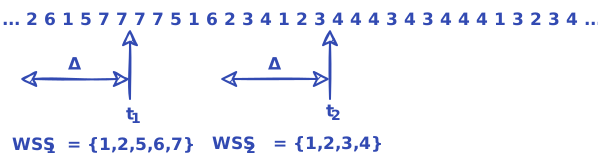
si referencias a la memoria, entonces el conjunto de trabajo en es . Mientras que en el conjunto de trabajo es .
Obviamente, la precisión del conjunto de trabajo como aproximación de la localidad del programa depende del parámetro :
- Si es muy pequeño, el conjunto de trabajo no cubriría toda la localidad.
- Si es muy grande, el conjunto de trabajo se superpondría a varias localidades.
Uso del conjunto de trabajo para evitar la hiperpaginación
Sección titulada «Uso del conjunto de trabajo para evitar la hiperpaginación»El uso del conjunto de trabajo es bastante sencillo:
- Los diseñadores del sistema seleccionan .
- El sistema operativo monitoriza el conjunto de trabajo de cada proceso y le asigna tantos marcos como páginas haya en el conjunto de trabajo.
- Si sobran globalmente suficientes marcos:
- En el caso de los sistemas multiprogramados, otro proceso puede ser cargado desde la cola de entrada o desde el dispositivo de intercambio, si había sido suspendido previamente por el planificador de medio plazo.
- En sistemas más modernos la memoria libre puede destinarse a otros usos, como caché o búferes de E/S.
- Si el tamaño del conjunto de trabajo total crece y excede el número de marcos disponibles:
- En los sistemas multiprogramados con planificador de medio plazo, el sistema podría seleccionar un proceso para ser suspendido. Este volverá a ser cargado y reiniciado más tarde, cuando haya suficientes marcos libres.
- Los sistemas operativos más modernos reparten los marcos disponibles entre todos los procesos. Al ser la cantidad de marcos disponibles inferior al , es posible que algunos procesos hiperpaginen.
En la descripción anterior, el tamaño del conjunto de trabajo es la suma del tamaño de los conjuntos de trabajo para cada proceso :
y representa la demanda total de marcos. Por eso, si es mayor que el número de marcos disponibles, habrá hiperpaginación.
El sencillo algoritmo anterior permite evitar la hiperpaginación. Sin embargo, el reto está en cómo mover la ventana del conjunto de trabajo en cada referencia, con el fin de volver a calcular el conjunto de trabajo.
Una posible aproximación es utilizar un temporizador que periódicamente invoque a una función encargada de examinar el bit de referencia de las páginas en la ventana de referencias . Es de suponer que las páginas con el bit de referencia a 1 forman parte de la localidad del programa y por tanto serán el conjunto de trabajo a lo largo del siguiente periodo.
Otras consideraciones
Sección titulada «Otras consideraciones»Ya hemos comentado que las principales decisiones que deben ser tomadas en el diseño de un sistema con paginación bajo demanda son la elección del algoritmo de reemplazo y la de la asignación de marcos de página. Sin embargo, hay otras consideraciones que deben ser tenidas en cuenta.
Prepaginado
Sección titulada «Prepaginado»El prepaginado es una técnica que consiste en cargar múltiples páginas junto con la página demandada en cada fallo de página.
Esas otras páginas se escogen especulativamente bajo la hipótesis de que van a ser necesitadas por el proceso en un corto espacio de tiempo. De manera que si la predicción es acertada, la tasa de fallos de página se reduce significativamente. Esta técnica puede ser utilizada, por ejemplo, en las siguientes situaciones:
-
En la paginación bajo demanda pura, el sistema sabe de antemano que cuando se inicia un proceso siempre fallan las primeras páginas de código, por lo que son buenas candidatas para el prepaginado.
-
En el acceso secuencial a archivos mapeados en memoria. El sistema puede determinar que el acceso va a ser de tipo secuencial, tanto mediante el uso de técnicas heurísticas como mediante las opciones indicadas por el proceso en la llamada al sistema con la que se abrió el archivo. En cualquier caso, si el sistema determina que el acceso al archivo es secuencial, en cada fallo de página puede cargar tanto la página demandada como las siguientes, en previsión de que vayan a ser utilizadas por el proceso.
En general, el único inconveniente del prepaginado es que debe ser ajustado para que el coste del mismo sea inferior al de servir los fallos de página.
Sobrerreserva
Sección titulada «Sobrerreserva»Como las páginas de memoria de los procesos no necesitan memoria física hasta que son referenciadas, los sistemas operativos con memoria virtual pueden aceptar solicitudes de reserva de memoria aunque no haya suficiente memoria física disponible. Para que el sistema operativo pueda garantizar que siempre tiene dónde almacenar cualquier página de cualquier proceso, debe asegurarse de que la cantidad total de memoria reservada no exceda el espacio total disponible entre la memoria física y el espacio de intercambio. Por lo general, si una petición de reserva de memoria excede el espacio total disponible, el sistema operativo la rechazará.
Sin embargo, algunos sistemas operativos pueden aceptar solicitudes de reserva de memoria que excedan el espacio total disponible. En estos casos, el sistema operativo acepta la solicitud, pero no garantiza que la memoria reservada pueda ser utilizada. Es lo que se conoce como sobrerreserva u overcommit.
La sobrerreserva es útil porque algunos programas reservan más memoria de la que realmente necesitan, por lo que no tiene sentido que se compruebe si hay suficiente espacio hasta que el proceso no utilice realmente la memoria reservada. Sin embargo, tiene el riesgo de que se reserve más memoria de la disponible y todos los procesos intenten utilizar buena parte de ella. En ese caso el sistema se queda sin espacio donde almacenar las páginas y tiene que terminar procesos de forma prematura para liberarlo.
En los sistemas Linux, Out Of Memory Killer u OOM Killer es el nombre que recibe la tarea del núcleo encargada de terminar procesos cuando el sistema se queda sin memoria. El OOM Killer selecciona los procesos a terminar en función de una serie de criterios, como el uso de la CPU, la cantidad de memoria que consumen o si el proceso es un servicio o un proceso de usuario.
Aplicaciones en modo raw
Sección titulada «Aplicaciones en modo raw»Algunas aplicaciones, cuando acceden a sus datos a través de los mecanismos de memoria virtual del sistema operativo, ofrecen peor rendimiento del que conseguirían si este mecanismo no existiera.
El ejemplo típico son los gestores de bases de datos, que conocen sus necesidades de memoria y disco mejor que cualquier sistema operativo de propósito general. Por eso les compensa implementar sus propios algoritmos de gestión de la memoria y de buffering de E/S.
Por eso muchos sistemas operativos modernos permiten que los programas que lo soliciten puedan acceder a los discos en modo raw. En el modo raw no hay sistema de archivos, ni paginación bajo demanda, ni bloqueo de archivos, ni prepaginación, ni muchos otros servicios del sistema operativo, por lo que dichas aplicaciones deben implementar sus propios algoritmos de almacenamiento y gestión de la memoria.
Sin embargo, hay que valorar muy bien las necesidades del programa antes de optar por este modo. La mayor parte de las aplicaciones siempre funcionan mejor utilizando los servicios convencionales ofrecidos por el sistema operativo.
Tamaño de las páginas
Sección titulada «Tamaño de las páginas»Como ya comentamos al estudiar el método básico de paginación, una decisión de diseño importante es escoger el tamaño adecuado para las páginas:
-
Con páginas grandes se obtienen:
- Menos fallos de página. Por ejemplo, en un caso extremo, un proceso de 100 KiB solo podría generar un fallo de página si cada página es de 100 KiB, pero puede generar 102 400 fallos si cada página es de 1 byte.
- Tablas de páginas más pequeñas.
- E/S más eficiente. El tiempo de transferencia es proporcional a la cantidad de información transferida, lo que por sí solo favorecería al uso de páginas pequeñas. Pero la latencia y el posicionamiento de la cabeza lectora del disco tienen mucha más influencia que la transferencia, de modo que es más barato hacer pocas transferencias grandes que muchas pequeñas.
-
Con páginas pequeñas se obtienen:
- Menos fragmentación interna y, por tanto, mejor aprovechamiento de la memoria.
- Mejor resolución, en teoría, para asignar y transferir al disco solo la memoria que realmente necesitamos. Esto a la larga debería redundar en menos memoria asignada y menos operaciones de E/S.
En la actualidad el tamaño de página más común es de 4 KiB, tanto en los sistemas de 32 bits como en los de 64, porque resulta adecuado para la mayor parte de las aplicaciones. Los 8 KiB fueron habituales en las arquitecturas RISC de 64 bits de los años noventa, como o . Hoy los tamaños mayores vuelven por la vía de macOS en Apple Silicon, que usa páginas de 16 KiB, y de Android, que está migrando a ese mismo tamaño (ver el apartado «Tamaño de las páginas»). Además, muchos sistemas modernos soportan el uso simultáneo de múltiples tamaños de página. Esto permite que la mayor parte de las aplicaciones utilicen el tamaño estándar, mientras las que hacen un uso intensivo de la memoria —como es el caso de los gestores de bases de datos— puedan utilizar páginas de mayor tamaño.
Efecto de la estructura de los programas
Sección titulada «Efecto de la estructura de los programas»Los programas creados considerando la localidad de referencia pueden mejorar su rendimiento en los sistemas con paginación bajo demanda.
Vamos a ilustrarlo con el siguiente ejemplo de un programa que inicializa a 0 un array de 128 por 128 elementos.
char data[128][128];
for (int j = 0; j < 128; ++j){  for (int i = 0; i < 128; ++i)  {    data[i][j] = 0;  }}
Un array como el indicado es almacenado en filas:
data[0][0], data[0][1], ..., data[0][127]data[1][0], data[1][1], ..., data[127][127]De manera que si suponemos que el tamaño de cada página es de 128 bytes, en el mejor de los casos cada fila estará almacenada en una página. Por lo tanto:
- Si el sistema le asigna 128 marcos o más, el proceso solo generará 128 fallos de página.
- Si el sistema operativo le asigna un solo marco, el proceso tendrá 16 384 fallos, aproximadamente.
Sin embargo, el ejemplo sería muy diferente si el bucle interno del programa recorriera las columnas del array y no las filas:
char data[128][128];
for (int i = 0; i < 128; ++i){  for (int j = 0; j < 128; ++j)  {    data[i][j] = 0;  }}
Así se ponen a 0 todos los bytes de una misma página antes de empezar con la siguiente. Esto reduciría el número de fallos de página a 128, aunque el sistema operativo solo asigne un marco al proceso.
Es el mismo motivo por el que este segundo bucle también se ejecuta más rápido en un sistema con memoria caché. Recorrer la memoria en el orden en el que está almacenada aprovecha la localidad de referencia. Cada línea de caché que se trae se utiliza entera antes de pasar a la siguiente, en lugar de traer una distinta en cada iteración. La diferencia es que la penalización de una caché se mide en nanosegundos, mientras que la de un fallo de página se mide en milisegundos.
Por lo tanto se puede concluir que:
-
La selección cuidadosa de las estructuras de datos y de programación puede mejorar la localidad, reduciendo la tasa de fallos de página y el tamaño del conjunto de trabajo. Por ejemplo, las estructuras de datos tipo pila tienen buena localidad, puesto que el acceso siempre se realiza en lo alto de las mismas. Sin embargo, las tablas de dispersión, obviamente, están diseñadas para dispersar las referencias, lo que produce una mala localidad.
-
La elección del lenguaje de programación también puede tener efecto. En los lenguajes como C y C++ se utilizan punteros con frecuencia, lo que aleatoriza el acceso a la memoria, empeorando la localidad de referencia. Además, algunos estudios indican que los lenguajes orientados a objetos tienden a tener peor localidad de referencia que los que no lo son.
-
El compilador y el cargador también pueden tener un efecto importante:
- Separando el código de los datos para permitir que las páginas de código puedan ser de solo lectura. Esto es interesante porque las páginas no modificadas no tienen que ser escritas antes de ser reemplazadas.
- El compilador puede colocar las funciones que se llaman entre sí en la misma página.
- El cargador puede situar las funciones en la memoria de tal forma que en lo posible no crucen los bordes de las páginas.
Interbloqueo de E/S y bloqueo de páginas
Sección titulada «Interbloqueo de E/S y bloqueo de páginas»Supongamos que un proceso solicita una operación de E/S sobre el contenido del marco de alguna de las páginas de su espacio de direcciones y que, antes de que la operación sea realizada, la página es reemplazada mientras el proceso está esperando. En ese caso, la operación de E/S se podría acabar realizando sobre una página que pertenece a un proceso diferente, ya que la operación de E/S se realiza sobre el marco en la memoria física.
Para evitarlo existen diversas soluciones:
-
Se puede utilizar la memoria del núcleo como búfer en las operaciones de E/S. En una escritura, esto obliga a la llamada al sistema a copiar los datos desde las páginas del proceso a la memoria del núcleo, antes de solicitar la operación de E/S. Mientras que en las operaciones de lectura sería justo al contrario.
-
Cada página puede tener un bit de bloqueo que se utiliza para indicar qué páginas no pueden ser seleccionadas para reemplazo.
Además los bits de bloqueo se pueden utilizar en otras muchas situaciones:
-
Bloquear las páginas del núcleo para evitar que sean reemplazadas.
-
Bloquear las páginas que acaban de ser cargadas. Esto evita que un fallo de página en un proceso de mayor prioridad pueda reclamar el marco antes de que el proceso para el que se cargó la página originalmente sea reiniciado, desperdiciando el trabajo de cargarla y provocando un nuevo fallo de página. Para implementarlo, se puede poner el bit de bloqueo a 1 cuando la página se carga, volviéndolo después a poner a 0 cuando el proceso es planificado por primera vez, tras el fallo de página que provocó la carga de la página.
-
En los sistemas con tiempo real flexible, se suele permitir que las tareas de tiempo real informen de cuáles son las páginas más importantes, con el fin de que sean bloqueadas para evitar que puedan ser reemplazadas. Para evitar riesgos, el sistema suele considerar estas solicitudes como «consejos de bloqueo». De esta manera el sistema es libre de descartar dichos consejos si el conjunto de marcos libres llega a ser demasiado pequeño o si un proceso pide bloquear demasiadas páginas.
Espacio de intercambio
Sección titulada «Espacio de intercambio»La memoria virtual es una técnica que surgió para permitir ejecutar programas que no caben en la memoria física, cuando esta era un recurso muy limitado. Actualmente, con la cantidad de memoria física disponible en los sistemas modernos, surge la duda de si sigue siendo necesario disponer de espacio de intercambio.
Para responder a esa pregunta, hay que tener en cuenta que las páginas de memoria pueden clasificarse en alguna de las siguientes categorías:
-
Páginas de código y datos del núcleo, que siempre están en memoria, por lo que se bloquean para evitar que sean reemplazadas.
-
Páginas para la caché de datos de E/S, con el objeto de acelerar futuros accesos a los mismos. Estas páginas pueden ser reemplazadas y su contenido se puede descartar sin problemas.
-
Código de programas, que son páginas de solo lectura, por lo que su contenido es siempre el mismo que el del archivo del ejecutable que contiene al programa.
-
Páginas que mapean archivos en la memoria, cuyo contenido es el mismo que el de alguna región de un archivo en disco que les sirve de respaldo. Cuando estas páginas son de solo lectura, su contenido puede ser descartado sin problema. Mientras que si permiten acceso de escritura, las modificaciones son escritas por el sistema operativo en el archivo mapeado.
-
Páginas anónimas, que son aquellas que no corresponden con ningún archivo en disco. Eso incluye la pila, el montón o la memoria reservada dinámicamente con malloc(), new() o mmap(). Como el contenido de estas páginas no está respaldado en disco, si se reemplazan, el sistema operativo debe guardar su contenido en el espacio de intercambio.
Tener suficiente espacio de intercambio asegura la igualdad de trato entre las páginas de memoria, independientemente del tipo de página que sean. Porque si un sistema no dispone de espacio de intercambio, no puede reemplazar páginas anónimas, sin importar si su contenido es accedido con poca frecuencia, lo que puede llevar a reemplazar páginas más importantes para el rendimiento del sistema.
Veamos las situaciones más típicas en cuanto a la demanda de memoria y cómo afecta al sistema tener o no espacio de intercambio.
Baja demanda de memoria
Sección titulada «Baja demanda de memoria»-
Con espacio de intercambio. El sistema puede optar por intercambiar memoria anónima raramente utilizada, por ejemplo, para aumentar la cantidad de memoria caché y otras optimizaciones.
-
Sin espacio de intercambio. No se puede intercambiar la memoria anónima, ya que está bloqueada en la memoria. Aunque esto puede no presentar un problema de inmediato, en algunos casos puede implicar una caída en el rendimiento debido a que las páginas anónimas usadas con menor frecuencia no se pueden utilizar para cosas más importantes.
Demanda moderada de memoria
Sección titulada «Demanda moderada de memoria»-
Con espacio de intercambio. En este caso, todos los tipos de memoria tienen la misma posibilidad de ser reemplazados. Esto significa que hay mayores posibilidades de reemplazar una página que no vaya a ser reclamada rápidamente de nuevo.
-
Sin espacio de intercambio. Como las páginas anónimas están bloqueadas en la memoria, el reemplazo tiene que ocurrir en otro tipo de memoria, aunque contenga peores candidatos para el reemplazo. Por tanto, el sistema tenderá a reducir las páginas utilizadas como caché de E/S, perjudicando el rendimiento del acceso al almacenamiento, y hay más posibilidades de reemplazar una página que se necesitará pronto, aumentando la probabilidad de acabar hiperpaginando.
Alta demanda de memoria
Sección titulada «Alta demanda de memoria»-
Con espacio de intercambio. El sistema es más resiliente a picos temporales de demanda de memoria, ya que tiene libertad para escoger las mejores páginas para intercambio. En casos de agotamiento severo de la memoria, tiende a prolongarse el tiempo desde que comienza la hiperpaginación hasta que el sistema deja de ser usable.
-
Sin espacio de intercambio. El sistema cae en la hiperpaginación más rápidamente, ya que las páginas anónimas están bloqueadas en la memoria y no pueden ser reclamadas. En los sistemas Linux, el OOM Killer se activa más rápidamente para recuperar memoria por la vía de terminar procesos en ejecución.
Interfaz de gestión de la memoria
Sección titulada «Interfaz de gestión de la memoria»Gracias a la abstracción de las técnicas de memoria virtual —como la paginación bajo demanda— desde el punto de vista de los procesos, en cualquier sistema moderno prácticamente solo hace falta una llamada al sistema para gestionar su espacio de direcciones virtual.
En los sistemas POSIX esta llamada es mmap() y en Windows API es VirtualAlloc(), que se usan junto a sus opuestas munmap() y VirtualFree(), respectivamente.
Ambas funciones permiten:
-
Reservar una porción del espacio de direcciones virtual del proceso. La llamada solo reserva un rango de direcciones para que el proceso pueda utilizarlo, es decir, marca como válidas las páginas de ese rango. Es el componente de paginación bajo demanda el que asigna la memoria física que lo respalda, cuando el proceso accede a esas direcciones.
-
Establecer permisos —lectura, escritura y ejecución— opciones de compartición entre procesos, bloqueo de páginas en la memoria física, páginas de gran tamaño y otras opciones, en la región de memoria virtual a reservar.
Ambas funciones ofrecen una buena cantidad de funcionalidades, pero operan a muy bajo nivel. Por eso en ambas la página es la unidad mínima en la gestión de la memoria. Es decir, las regiones reservadas del espacio de direcciones virtual siempre deben comenzar en un borde de página y su tamaño debe ser múltiplo del tamaño de página.
El problema es cómo compatibilizar eso con las necesidades reales de los programas, que durante su ejecución necesitan reservar y liberar constantemente memoria para pequeños elementos, como arrays, cadenas de texto, estructuras u objetos. Para esos casos, utilizar directamente mmap() o VirtualAlloc() no es una solución, puesto que la fragmentación interna conlleva un importante derroche de recursos.
Anatomía del espacio de direcciones virtual del proceso
Sección titulada «Anatomía del espacio de direcciones virtual del proceso»Los procesos pueden utilizar diversas ubicaciones dentro de su espacio de direcciones virtual para almacenar los datos que necesitan para su ejecución (ver la siguiente figura):
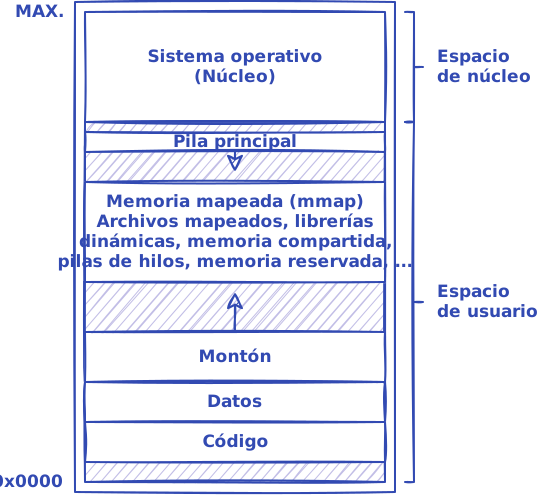
-
Las variables y constantes globales se almacenan en el segmento de datos, que tiene tamaño fijo, ya que las dimensiones de estas variables se conocen de antemano en tiempo de compilación, al igual que ocurre con el código del programa.
-
Las variables locales y los argumentos de las funciones se almacenan en la pila, junto con las direcciones de retorno para volver de las funciones. Esta es la ubicación ideal para ellos, puesto que al retornar de una función, la pila se restablece al estado previo al que tenía cuando se invocó dicha función, haciendo que las variables locales y argumentos desaparezcan automáticamente.
-
Las variables reservadas dinámicamente —por ejemplo, usando malloc() y free() en C o new() y delete() en C++ o Java— se almacenan en el montón, que no es más que una región contigua de memoria ubicada inmediatamente después del segmento de datos del proceso.
-
En la región entre el montón y la pila se ubican los archivos mapeados en memoria, las regiones de memoria compartida, las librerías de enlace dinámico, las pilas de cada hilo —en procesos multihilo— y, en general, la memoria reservada con funciones como mmap() y VirtualAlloc().
Cada lenguaje de programación debe proporcionar —a través de su librería estándar— un mecanismo en espacio de usuario, adecuado para la gestión en tiempo de ejecución de la memoria del montón del proceso. Para eso, cada lenguaje puede utilizar su propia implementación de dicho mecanismo o bien recurrir a la proporcionada por la librería del sistema.
Por ejemplo, en los sistemas POSIX, la librería del sistema proporciona su propia implementación, accesible a través de las funciones malloc() y free(), que es utilizada directamente por los programas escritos en C. Esta implementación hace uso de mmap(), pero ofrece mayor control sobre la cantidad de memoria que podemos reservar, como veremos en «Gestión de la memoria del montón».
Otros lenguajes de programación tienen otras interfaces para gestionar la memoria, pero utilizan internamente las funciones malloc() y free() de la librería del sistema. Sin embargo, este no es el caso ni de C++ ni de Java ni de algunos otros lenguajes. En C++, los operadores new() y delete() utilizan sus propios algoritmos de gestión de la memoria del montón, más optimizados que malloc() y free() para la creación y destrucción de objetos de cualquier tamaño de manera eficiente.
En Windows API ocurre algo similar. La librería del sistema proporciona su propia gestión de la memoria del montón, que es accesible para cualquier programa a través de las funciones HeapAlloc() y HeapFree(), y que se implementa sobre VirtualAlloc(). La librería estándar de C utiliza, a su vez, esas funciones para implementar malloc() y free(). Lo mismo ocurre en otros lenguajes, aunque no en todos, ya que algunos optan por implementar algoritmos más eficientes para sus casos de uso directamente sobre VirtualAlloc().
Gestión de la memoria del montón
Sección titulada «Gestión de la memoria del montón»Para ilustrar cómo se puede gestionar la memoria del montón utilizaremos como ejemplo el mecanismo empleado por la librería del sistema de los sistemas POSIX, accesible a través de las funciones malloc() y free(). Sin embargo, es importante tener en cuenta que esta tarea se realiza de manera muy similar en las implementaciones de otros sistemas operativos y lenguajes de programación.
El funcionamiento básico de malloc() sigue las siguientes reglas:
-
Cuando la memoria solicitada supera cierto umbral —128 KiB en sistemas GNU/Linux— es reservada directamente mediante la llamada al sistema mmap(). Eso significa que las peticiones de gran tamaño realmente no consumen espacio del montón, sino que se reservan del hueco entre el montón y la pila.
-
Cuando un proceso hace una petición de memoria dinámica espera que el espacio ofrecido sea contiguo en el espacio de direcciones virtual. Por eso la memoria del montón se gestiona con un algoritmo de asignación contigua de memoria, y con un esquema de particionado dinámico, ya que las peticiones pueden ser de tamaño variable.
Es decir, para las peticiones que no entran en el caso anterior, se busca en la tabla de huecos libres y ocupados del montón uno lo suficientemente grande como para atender la petición. La estrategia de búsqueda más común es el mejor ajuste, usando alguna estructura de datos que mantenga los huecos libres ordenados por tamaño para dar rápidamente con el adecuado. Una vez encontrado un hueco, se asigna el espacio solicitado y el resto sigue marcado como hueco libre.
-
Si no hay suficiente memoria libre contigua como para atender la petición, se utiliza la llamada al sistema mmap() para extender el tamaño del montón reservando una nueva región separada —a veces llamada arena— y comenzar a repartirla.
En algunas implementaciones el montón principal se puede ampliar hacia la región adyacente no asignada del espacio de direcciones virtual usando la llamada al sistema brk(). Es lo que intenta primero la implementación estándar de malloc() en GNU/Linux, que deja el uso de mmap() para las arenas de los demás hilos.
La función calloc() permite obtener memoria del montón inicializada a 0, por lo que sigue las mismas reglas que malloc(). Cuando la petición es pequeña, obtiene la memoria del montón —extendiéndolo si fuera necesario— para luego ponerla manualmente a 0 antes de retornar de la función. Si la cantidad es grande —mayor de 128 KiB en sistemas GNU/Linux, como hemos comentado— obtiene la memoria llamando directamente a mmap(), que ya la devuelve inicializada a 0. Además, esa llamada usa técnicas como el copy-on-write para ahorrar memoria física, retrasando la asignación de marcos hasta que el proceso comienza a escribir realmente en la memoria reservada.
Fragmentación
Sección titulada «Fragmentación»La estrategia comentada sufre de fragmentación interna. En las peticiones grandes, mmap() reserva en múltiplos de tamaño de página, por lo que siempre se puede perder cierta cantidad, aunque pequeña en comparación al tamaño de la región reservada. En las peticiones pequeñas, la memoria se asigna en múltiplos de una unidad mínima —por ejemplo, 16 o 32 bytes— por lo que también se puede perder cierta cantidad de memoria.
Además sufre de fragmentación externa, porque tras un tiempo reservando y liberando memoria el espacio del montón puede quedar fraccionado en un gran número de huecos pequeños. Entonces la librería tiene que buscar más espacio para el montón, aunque la suma de los huecos libres sea suficiente para atender la petición.
Esto representa un reto para los desarrolladores de aplicaciones que previsiblemente vayan a ejecutarse durante periodos muy largos de tiempo. En esos casos, es común optar por librerías externas que implementen gestores de memoria que fragmenten menos la memoria, o soluciones basadas en alguna forma de referencias indirectas y recolección de basura, para ocasionalmente poder compactar la memoria del montón. Esto último es lo que hace la máquina virtual de Java.
Referencias de las API
Sección titulada «Referencias de las API»Lenguaje C
Asigna memoria para un array e inicializa todos los bytes a cero.
void* calloc(size_t nmemb, size_t size);Libera memoria previamente asignada con malloc(), calloc() o realloc().
void free(void* ptr);Lenguaje C++
Operador para liberar memoria asignada dinámicamente con new.
delete ptr;delete[] ptr;POSIX
Cambia el límite del segmento de datos (heap) del proceso.
int brk(void* addr);void* sbrk(intptr_t increment);Reemplaza la imagen del proceso actual con un nuevo programa.
int execl(const char* pathname, const char* arg, ... /*, NULL */);int execv(const char* pathname, char* const argv[]);int execle(const char* pathname, const char* arg, ... /*, NULL, char* const envp[] */);int execve(const char* pathname, char* const argv[], char* const envp[]);int execlp(const char* file, const char* arg, ... /*, NULL */);int execvp(const char* file, char* const argv[]);Reposiciona el cursor de lectura/escritura de un descriptor de archivo.
off_t lseek(int fd, off_t offset, int whence);Proyecta un archivo o dispositivo en la memoria del proceso.
void* mmap(void* addr, size_t length, int prot, int flags, int fd, off_t offset);Elimina una proyección de memoria creada por mmap().
int munmap(void* addr, size_t length);Abre o crea un archivo y devuelve un descriptor de archivo.
int open(const char* pathname, int flags);int open(const char* pathname, int flags, mode_t mode);Lee datos de un descriptor de archivo.
ssize_t read(int fd, void* buf, size_t count);Windows API
Cierra un handle abierto del sistema.
BOOL CloseHandle(HANDLE hObject);Crea o abre un archivo, dispositivo, directorio o tubería.
HANDLE CreateFile(LPCTSTR lpFileName, DWORD dwDesiredAccess, DWORD dwShareMode, LPSECURITY_ATTRIBUTES lpSecurityAttributes, DWORD dwCreationDisposition, DWORD dwFlagsAndAttributes, HANDLE hTemplateFile);Crea o abre un objeto de asignación de archivo en memoria.
HANDLE CreateFileMapping(HANDLE hFile, LPSECURITY_ATTRIBUTES lpFileMappingAttributes, DWORD flProtect, DWORD dwMaximumSizeHigh, DWORD dwMaximumSizeLow, LPCTSTR lpName);Asigna un bloque de memoria del heap especificado.
LPVOID HeapAlloc(HANDLE hHeap, DWORD dwFlags, SIZE_T dwBytes);Libera un bloque de memoria asignado con HeapAlloc.
BOOL HeapFree(HANDLE hHeap, DWORD dwFlags, LPVOID lpMem);Proyecta una vista de un objeto de asignación de archivo en la memoria del proceso.
LPVOID MapViewOfFile(HANDLE hFileMappingObject, DWORD dwDesiredAccess, DWORD dwFileOffsetHigh, DWORD dwFileOffsetLow, SIZE_T dwNumberOfBytesToMap);Elimina una proyección de vista de archivo de la memoria del proceso.
BOOL UnmapViewOfFile(LPCVOID lpBaseAddress);Reserva, confirma o cambia el estado de una región de la memoria virtual del proceso.
LPVOID VirtualAlloc(LPVOID lpAddress, SIZE_T dwSize, DWORD flAllocationType, DWORD flProtect);Libera o desconfirma una región de la memoria virtual del proceso.
BOOL VirtualFree(LPVOID lpAddress, SIZE_T dwSize, DWORD dwFreeType);